# RAG 深入知识地图:文档处理、切分、向量库与检索器
RAG 工程可以拆成两条链路:数据入库链路和在线问答链路。数据入库链路负责把外部数据变成可检索的 Document、chunk、embedding 和向量索引;在线问答链路负责把用户 query 转成检索请求,拿到证据片段,再组织 Prompt 生成答案。
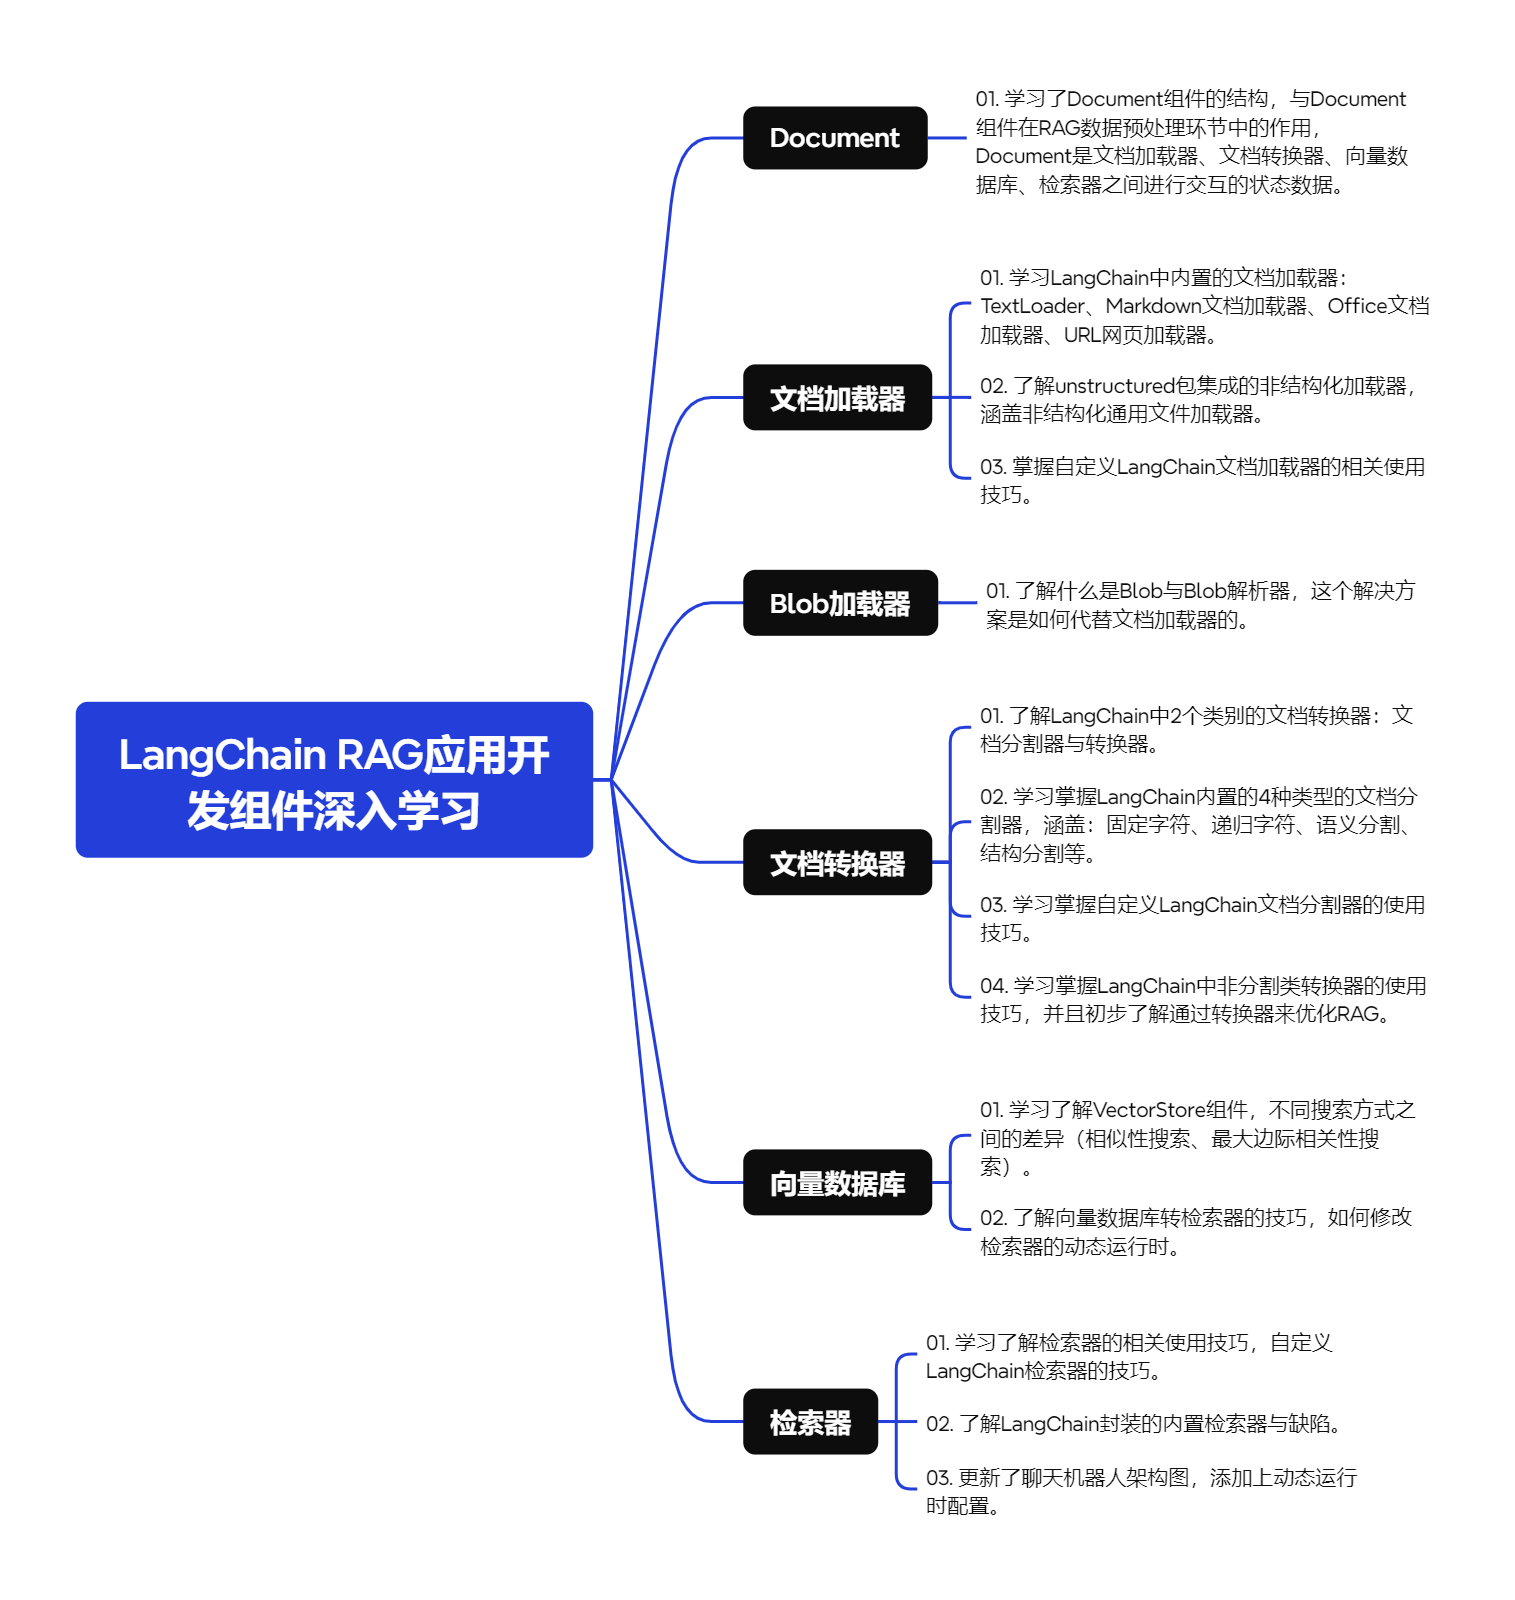
# 数据入库链路
数据入库通常包括以下步骤。
Document:LangChain 中最常见的文本载体,包含 page_content 和 metadata。正文放在 page_content,来源、页码、标题、版本、权限等放在 metadata。
Loader:从 Markdown、PDF、HTML、CSV、JSON、目录、Blob、数据库或业务系统读取内容,并生成 Document。
Blob 与 BlobParser:把二进制数据读取和内容解析拆开。Blob 负责承载原始数据,BlobParser 负责把它解析成文档,适合复杂文件、多来源文件和异步处理。
DocumentTransformer:对文档做清洗、转换、翻译、QA 抽取、HTML 转 Markdown、metadata 增强等。
TextSplitter:把文档切成适合 embedding 和检索的 chunk。常见策略包括递归字符分割、结构分割、语义分割和自定义业务分割。
Embedding:把 chunk 映射为向量。Embedding 模型决定了语义空间的表达方式,也影响跨语言、术语、短 query、长文档的检索效果。
VectorStore:存储向量和文档 metadata,并提供相似性搜索、阈值搜索、MMR、过滤等能力。
# 在线问答链路
在线链路通常包括:
query:用户问题。真实系统里可能需要改写、补全、分类、路由或抽取关键词。
Retriever:根据 query 返回相关 Document。它可以来自 VectorStore,也可以来自搜索引擎、业务 API、自定义检索逻辑或多路召回组合。
context:检索返回的证据片段。Prompt 中必须明确要求模型基于 context 回答,并在缺证据时拒答。
Prompt:把问题、上下文、历史对话、输出格式、约束条件组织起来。
LLM / ChatModel:根据 Prompt 生成答案。
OutputParser:把模型输出解析成字符串、JSON、对象或业务结构。
Memory / History:保存多轮对话上下文,但不能让历史对话覆盖检索证据。
# 组件之间的关键边界
Loader 不应该承担复杂检索逻辑。它的职责是读取数据并生成文档。
Transformer 不应该承担远程知识查询。它的职责是把文档加工成更适合索引或检索的形态。
Splitter 不应该只追求固定长度。它的职责是让 chunk 在大小可控的同时保持语义完整。
VectorStore 不应该承担权限决策的全部责任。权限条件要在写入、检索和展示多个阶段同时校验。
Retriever 不应该只是 top_k 包装。它应该成为检索策略、过滤、降级、观测和多路召回的工程入口。
# 一条最小 RAG 链路
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser

loader = UnstructuredMarkdownLoader("./项目API文档.md")
documents = loader.load()

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    add_start_index=True,
)
chunks = splitter.split_documents(documents)

embedding = OpenAIEmbeddings(model="text-embedding-3-small")
db = FAISS.from_documents(chunks, embedding)
retriever = db.as_retriever(search_kwargs={"k": 4})

prompt = ChatPromptTemplate.from_template(
    """请只根据给定上下文回答问题。

上下文:
{context}

问题:{question}"""
)

llm = ChatOpenAI(model="gpt-4o-mini")

chain = {
    "context": retriever,
    "question": RunnablePassthrough(),
} | prompt | llm | StrOutputParser()

answer = chain.invoke("配置接口有哪些?")
print(answer)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
这条链路足够小,但已经包含 RAG 的核心:加载、切分、向量化、向量库、检索、Prompt、模型和解析。
# 工程设计清单
文档层:是否保留来源、页码、章节、版本、更新时间、权限字段。
切分层:chunk 是否完整,是否能独立回答一个问题,是否过度重叠,是否保留 start index。
向量层:embedding 模型是否适合语料,是否需要多语言,是否需要批处理和缓存。
检索层:是否需要阈值、MMR、metadata filter、混合检索和 rerank。
生成层:Prompt 是否要求引用上下文,是否允许拒答,输出是否需要结构化。
观测层:是否记录 query、召回文档、分数、耗时、模型输出和用户反馈。
# 最新版 LangChain 用法提示
当前 LangChain Python 包已经拆得更细:核心抽象在 langchain_core,文档分割在 langchain_text_splitters,OpenAI 集成在 langchain_openai,大量第三方组件在 langchain_community 或独立集成包。
新代码建议使用 Runnable/LCEL 组织链路,并通过 invoke() 调用。Retriever、Prompt、LLM、Parser 都可以组合成清晰的数据流。
旧示例中的顶层导入路径不一定适合新项目。遇到 LangChain 组件时,要优先确认当前包名、安装方式和是否仍被推荐。
# 拓展
RAG 不一定只有一条链路。复杂系统常见多路召回:向量检索、关键词检索、图谱检索、SQL 查询、历史会话检索并行,再做合并和 rerank。
RAG 也可以分层索引。先对文档摘要做粗召回,再回到原文 chunk 做精召回。这样可以减少候选范围,同时保留原文证据。
对高价值业务,要建立评测集。每次调整 Loader、Splitter、Embedding、VectorStore、Retriever 或 Prompt,都要看命中率、答案正确率、引用正确率和拒答准确率。
# 常见问题
RAG 的核心难点是 Prompt 吗?
不是。Prompt 很重要,但更多问题来自数据质量、切分、embedding、检索策略和上下文组织。
为什么同一个问题有时答对、有时答错?
可能是召回不稳定、chunk 边界不合理、上下文太长、模型采样参数变化或历史对话干扰。
是不是向量库越强,RAG 就越准?
不是。向量库只是链路之一。文档解析、metadata、embedding、切分、过滤和 rerank 都会影响最终结果。
# 面试题
请描述一条完整 RAG 链路。
外部文档通过 Loader 变成 Document,经 Transformer 清洗增强,经 Splitter 切成 chunk,Embedding 后写入 VectorStore。用户 query 进入 Retriever,召回上下文,Prompt 组织问题和证据,LLM 生成答案,Parser 输出结果。
Document、Loader、TextSplitter、VectorStore、Retriever 的职责分别是什么?
Document 是数据载体,Loader 负责读取,TextSplitter 负责切分,VectorStore 负责向量存储和搜索,Retriever 负责面向 query 返回相关文档。
RAG 生产系统最常见的问题有哪些?
召回不相关、证据缺失、答案幻觉、权限越界、旧数据未更新、成本过高、延迟不稳定和缺少可观测性。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 答案合理但无依据 | Prompt 没限制上下文,或召回证据弱 | 增加引用要求、阈值和拒答策略 |
| 召回命中旧内容 | 文档更新后未重建索引 | 使用 hash、版本号和增量任务 |
| 召回结果重复 | chunk overlap 过大或多路召回未去重 | 基于 source_id、chunk_id 去重 |
| 越权访问 | metadata filter 缺失 | 写入和检索都强制权限字段 |
| 延迟过高 | 串行处理、候选过多、模型调用过多 | 并行检索、缓存、rerank 前裁剪、设置超时 |