# Blob 与 BlobParser 代替文档加载器
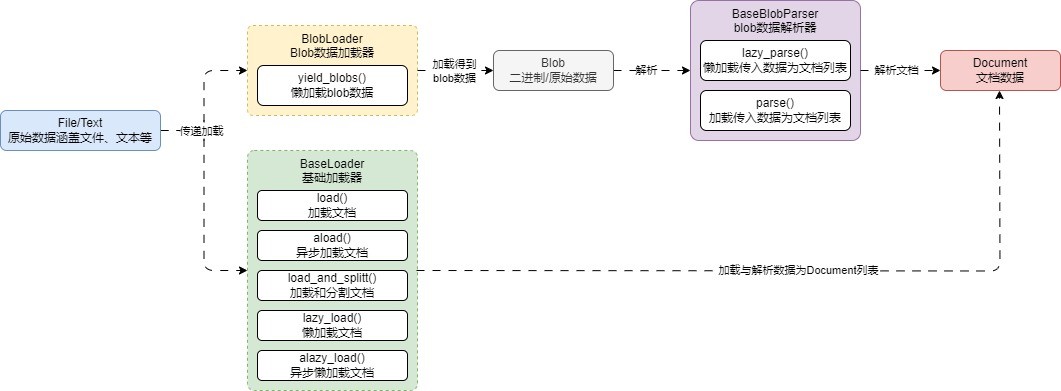
很多文档加载器都要处理文件解析问题。不同加载器之间的差异,往往不在“文件怎么读取”,而在“读取出来之后怎么解析”。例如 PDF、Markdown、TXT 都可以通过文件路径读取到原始内容,但把原始内容转换成文本和 Document 的方式完全不同。
为了解耦“读取数据”和“解析数据”,LangChain 提供了 Blob 相关方案。Blob 可以理解为原始数据载体,BlobParser 则负责把 Blob 解析成 Document。
# Blob 方案中的三个角色
Blob 方案主要涉及三个概念。
| 角色 | 作用 |
|---|---|
Blob | 表示原始数据,可以来自文件、字节、字符串或其他数据源 |
BlobLoader | 负责产生 Blob,类似更底层的数据加载器 |
BlobParser | 负责把 Blob 解析成 Document 列表 |
传统文档加载器通常把读取和解析放在一起。Blob 方案把它拆开以后,整体链路会变成:
文件 / 字节数据 -> BlobLoader -> Blob -> BlobParser -> Document
这样做的好处是:同一种加载方式可以搭配不同解析器,同一种解析器也可以处理来自不同来源的 Blob。
# 自定义 BlobParser
假设有一个文本文件,需要把文件中的每一行解析成一个 Document。使用 BlobParser 可以这样实现:
from typing import Iterator

from langchain_core.document_loaders import Blob
from langchain_core.document_loaders.base import BaseBlobParser
from langchain_core.documents import Document


class CustomParser(BaseBlobParser):
    """自定义解析器,用于将传入的文本二进制数据的每一行解析成 Document 组件"""

    def lazy_parse(self, blob: Blob) -> Iterator[Document]:
        line_number = 0
        with blob.as_bytes_io() as f:
            for line in f:
                yield Document(
                    page_content=line,
                    metadata={
                        "source": blob.source,
                        "line_number": line_number,
                    },
                )
                line_number += 1


# 1. 加载 Blob 数据
blob = Blob.from_path("./喵喵.txt")
parser = CustomParser()

# 2. 解析得到文档数据
documents = list(parser.lazy_parse(blob))

# 3. 输出相应信息
print(documents)
print(len(documents))
print(documents[0].metadata)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
这段代码中,Blob.from_path("./喵喵.txt") 负责从文件路径创建 Blob,CustomParser.lazy_parse() 负责把 Blob 中的内容逐行转换成 Document。
需要注意,BlobParser 不关心后续如何切分、向量化、入库。它只负责解析。
# FileSystemBlobLoader
如果要从文件系统中批量产生 Blob,可以使用 FileSystemBlobLoader:
from langchain_community.document_loaders.blob_loaders import FileSystemBlobLoader

loader = FileSystemBlobLoader(".", show_progress=True)

for blob in loader.yield_blobs():
    print(blob.as_string())
2
3
4
5
6
yield_blobs() 会遍历指定路径下的文件,并逐个产出 Blob。后续可以把这些 Blob 交给不同 Parser。
这种方式适合目录批处理。例如一个目录下有很多同类型文本文件,可以先统一产出 Blob,再交给解析器转换成 Document。
# GenericLoader
GenericLoader 可以把文件系统加载和解析器组合起来,形成更通用的加载流程。
from langchain_community.document_loaders.generic import GenericLoader

loader = GenericLoader.from_filesystem(".", glob="*.txt", show_progress=True)

for idx, doc in enumerate(loader.lazy_load()):
    print(f"当前正在加载第 {idx} 个文件,文件名:{doc.metadata['source']}")
2
3
4
5
6
这类写法适合把文件读取、文件过滤、解析逻辑组合起来。glob="*.txt" 表示只处理当前目录下的 txt 文件。
# Blob 与 Document 的区别
Blob 和 Document 不应该混在一起理解。
| 对象 | 含义 | 典型位置 |
|---|---|---|
Blob | 原始数据载体,可能是字节、文件引用或字符串 | 解析之前 |
Document | 已经解析好的文本和元数据 | 解析之后,进入 RAG 主链路 |
Blob 更接近文件本体,Document 更接近可检索文本。向量化、切分、检索通常面向 Document,而不是 Blob。
# 最新版 LangChain 用法提示
最新版 LangChain 仍然保留 Document loader 标准接口,也仍然强调把不同来源的数据读入 Document 格式。Blob / Parser 这种拆分思路在复杂解析场景中依然有价值。
不过实际使用时要注意:
- 简单文本文件可以直接使用
TextLoader,不一定要引入 BlobParser。 - 文件类型复杂、解析策略可替换时,再考虑 Blob / Parser 拆分。
- 社区加载器和解析器多来自
langchain_community或单独集成包,使用前要确认依赖。 - 新代码里仍应把解析后的 Document 再显式交给 splitter,而不是把所有步骤耦合在一起。
推荐的后续链路:
from langchain_text_splitters import RecursiveCharacterTextSplitter

documents = list(parser.lazy_parse(blob))

splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=200,
    add_start_index=True,
)
chunks = splitter.split_documents(documents)
2
3
4
5
6
7
8
9
10
如果只是加载一批普通文件,更直接的方式可能是使用已有 Loader:
from langchain_community.document_loaders import TextLoader

loader = TextLoader("./喵喵.txt", encoding="utf-8")
documents = loader.load()
2
3
4
是否使用 BlobParser,关键看读取和解析是否需要解耦。
# 拓展
Blob 方案适合以下场景:
- 文件来源很多:本地文件、对象存储、HTTP 下载、数据库二进制字段。
- 文件类型很多:TXT、Markdown、PDF、图片、Office 文档。
- 解析策略很多:同一个文件可能需要普通文本解析、OCR、表格解析、版面解析等。
- 需要重试解析:文件读取成功,但解析失败时,可以只重跑 Parser。
- 需要按文件类型路由:根据扩展名、MIME 类型或文件头选择不同 Parser。
在生产系统中,可以把 Blob 的 source、hash、size、last_modified 记录下来。这样后续可以判断文件是否变化,是否需要重新解析和重新入库。
# 常见问题
# 什么时候用 BlobParser,什么时候直接用 Loader?
如果只是读取普通文本或常见格式,直接用现成 Loader 更简单。如果数据来源和解析方式都很复杂,或者需要灵活替换解析器,BlobParser 更合适。
# BlobParser 输出的 Document 还需要切分吗?
通常需要。Parser 只负责把原始数据解析成文本和 metadata,不保证每个 Document 的长度适合检索。入库前仍然要根据内容长度和语义结构进行切分。
# Blob 中的 source 有什么用?
source 是追踪来源的关键字段。解析成 Document 后,应继续保留到 metadata 中,否则后续无法展示引用来源,也难以排查问题。
# 面试题
# Blob、BlobLoader、BlobParser 分别负责什么?
Blob 表示原始数据;BlobLoader 负责产生 Blob;BlobParser 负责把 Blob 解析成 Document。
# BlobParser 相比普通 Loader 的优势是什么?
它把读取和解析拆开,让读取逻辑、解析逻辑可以独立替换。复杂文件、多来源文件、多解析策略场景下更清晰。
# BlobParser 的输出为什么仍然是 Document?
因为后续 LangChain RAG 链路围绕 Document 工作,包括分割、向量化、向量库存储和检索器召回。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 解析结果乱码 | 编码判断错误,字节转字符串方式不对 | 显式指定编码或在 Parser 中做编码检测 |
| source 丢失 | Parser 没有把 blob.source 写入 metadata | 解析时强制保留 source |
| 文件重复解析 | 没有记录 hash 或更新时间 | 保存 hash、size、last_modified |
| 某些文件解析失败 | 文件类型不一致,Parser 不匹配 | 根据扩展名或 MIME 类型路由 Parser |
| 内存占用高 | 一次性读取大文件 | 使用流式读取和 lazy_parse |
| 后续无法删除旧数据 | metadata 没有稳定 doc_id | 基于 source/hash/version 生成稳定 id |