# 非分割类型文档转换器:清洗、问答抽取与翻译
文档转换器不是只负责“切分”。在 RAG 链路里,很多处理发生在加载之后、向量化之前:清洗 HTML、删除噪声、翻译、抽取问答、压缩内容、调整顺序、补充 metadata。这些操作输入是 Document 列表,输出仍然是 Document 列表,但每个文档的 page_content 或 metadata 已经被增强。
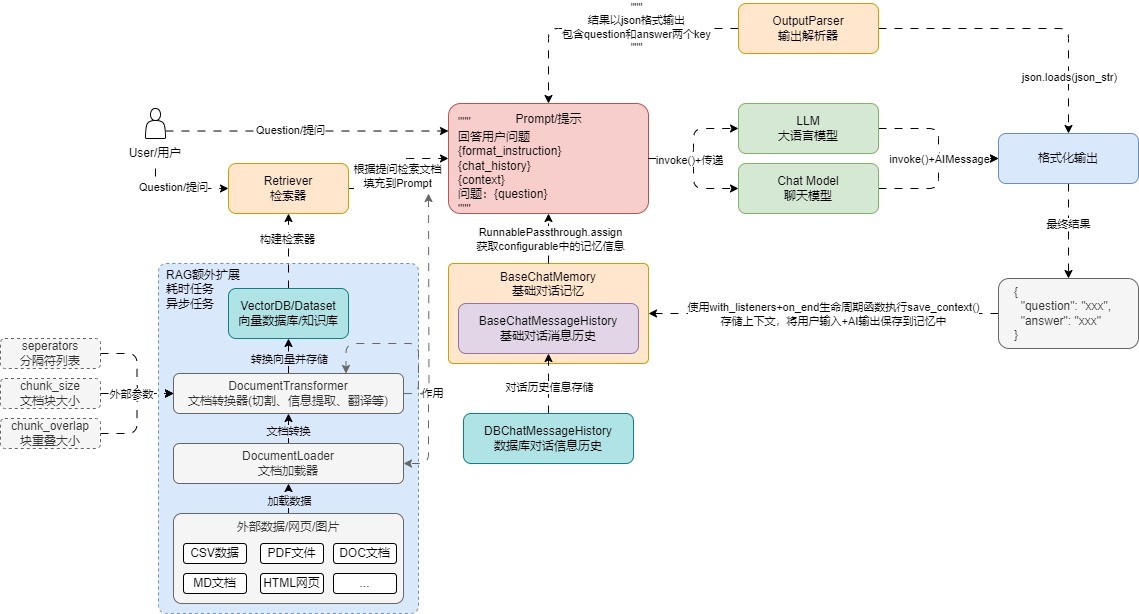
# DocumentTransformer 的位置
文档转换器的抽象接口可以理解为:
transform_documents(documents: Sequence[Document], **kwargs) -> Sequence[Document]
它不关心文档来自 PDF、Markdown、HTML 还是数据库,也不关心后面进入 FAISS、Weaviate、Pinecone 还是其他向量库。它只处理 Document 列表。
这类组件适合放在 Loader 和 TextSplitter 之间,也可以放在 TextSplitter 之后。放在切分前,适合做整篇文档级转换,例如翻译、脱敏、HTML 转文本。放在切分后,适合做 chunk 级增强,例如摘要、关键词、实体抽取、QA 抽取。
# 问答抽取转换器
DoctranQATransformer 会从文档中抽取可能的问答对,并把结果写入 metadata 的 questions_and_answers。这类能力适合问答型知识库:用户问法多变,而原文可能是通知、邮件、说明文、会议纪要。提前生成 QA 可以增加召回入口。
import dotenv
from doctran import Doctran
from langchain_community.document_transformers import DoctranQATransformer
from langchain_core.documents import Document

_ = Doctran

dotenv.load_dotenv()

page_content = """机密文件 - 仅供内部使用
日期:2023年7月1日
主题:各种话题的更新和讨论
亲爱的团队:
这里包含一些重要更新,并讨论需要关注的话题。请将此处信息视为高度机密。

安全和隐私措施
我们已在所有系统中实施了更强的数据保护措施。未来,每个人都应严格遵守数据保护政策和准则。如果发现潜在安全风险或事件,请立即向安全团队报告。

人力资源更新和员工福利
最近几位新成员加入了不同部门,并已经开始贡献价值。员工福利计划的开放报名期也即将到来,如有问题可以联系人力资源代表。

营销倡议和活动
营销团队正在制定新策略,以提高品牌知名度并推动客户参与。产品发布活动即将举行,相关成员需要提前准备支持材料。

研发项目
研发部门正在推进多个项目。相关成员可以在固定的研发讨论会上分享想法和建议,以便形成潜在的新项目方向。

请将此文档中的信息视为最机密,并确保不与未经授权的人员分享。
"""

documents = [Document(page_content=page_content)]

qa_transformer = DoctranQATransformer(openai_api_model="gpt-3.5-turbo-16k")
transformer_documents = qa_transformer.transform_documents(documents)

for qa in transformer_documents[0].metadata.get("questions_and_answers"):
    print("问答数据:", qa)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
输出形态通常类似:
问答数据: {'question': '文档中提到的数据保护要求是什么?', 'answer': '所有成员应严格遵守数据保护政策和准则,并在发现潜在安全风险或事件时报告。'}
问答数据: {'question': '营销团队近期关注什么?', 'answer': '营销团队正在提高品牌知名度、推动客户参与,并准备产品发布活动。'}
问答数据: {'question': '研发项目相关成员需要做什么?', 'answer': '可以在研发讨论会上分享想法和建议,形成潜在的新项目方向。'}
2
3
问答抽取不是为了替代原文,而是生成额外检索入口。落库时可以把原文 chunk 与 QA chunk 分开存储,也可以把 QA 放到 metadata 中,在检索或 rerank 阶段使用。
# 翻译转换器
DoctranTextTranslator 会把文档内容翻译成目标语言。多语言 RAG 里常见两种方案。
第一种是在写入向量库前统一翻译,把不同语言文档变成同一种语言后再 embedding。这样检索链路简单,但会增加入库成本,并且翻译质量会影响索引质量。
第二种是保留原文入库,检索后再翻译召回文档或答案。这样更尊重原文,但 Prompt 组织更复杂,也可能让不同语言 embedding 的召回质量不稳定。
import dotenv
from langchain_community.document_transformers import DoctranTextTranslator
from langchain_core.documents import Document

dotenv.load_dotenv()

page_content = """Confidential document - internal use only
Date: July 1, 2023
Subject: Updates and discussions across security, HR, marketing, and research.

Security and privacy measures
The organization has implemented stronger measures to protect customer data.
Potential risks or incidents should be reported immediately.

HR updates and employee benefits
Several new members have joined different departments. The open enrollment period for benefits is approaching.

Marketing initiatives and events
The marketing team is preparing new initiatives to improve brand awareness and customer engagement.

Research and development projects
The research team is collecting ideas and suggestions for potential projects.
"""

documents = [Document(page_content=page_content)]

text_translator = DoctranTextTranslator(openai_api_model="gpt-3.5-turbo-16k")
translator_documents = text_translator.transform_documents(documents)

print(translator_documents[0].page_content)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
# 适合转换器处理的内容
页眉页脚、目录、版权尾注、重复导航、HTML 标签、特殊编码、表格转 Markdown、字段补全、实体抽取、关键词抽取、摘要生成、QA 生成、翻译和脱敏,都可以放在文档转换阶段。
要注意转换器的边界:数据读取属于 Loader,切分属于 TextSplitter,存储属于 VectorStore,查询属于 Retriever。转换器主要负责 Document -> Document 的内容加工。
# 最新版 LangChain 用法提示
BaseDocumentTransformer 位于 langchain_core,DoctranQATransformer 和 DoctranTextTranslator 位于 langchain_community.document_transformers。这说明 Doctran 仍属于社区集成,而不是核心接口。
如果新项目对可维护性要求高,可以把这类转换写成普通函数或 LCEL RunnableLambda,并使用当前模型的结构化输出能力生成 JSON。Doctran 示例能说明处理思路,但生产链路不一定要绑定 Doctran。
涉及敏感文档时,不要直接把原文发给外部模型。至少要做脱敏、字段过滤、访问控制、审计日志和数据保留策略。
# 拓展
转换器可以做多版本索引。比如同一份文档保留原文版、摘要版、QA 版、关键词版。召回时多路检索,再合并去重和 rerank。
转换器还可以服务评测。把每个 chunk 抽取出候选问题,形成一批检索评测 query,用来检查知识库更新后召回是否退化。
# 常见问题
问答抽取后的 QA 要不要单独入库?
如果用户问题短、问法多、原文较长,单独入库能提升召回。若文档已经结构化清晰,可以把 QA 放入 metadata,用于排序或展示。
翻译应该在入库前还是检索后?
如果业务主要单语言问答,入库前统一语言更简单。如果需要保留原文准确性,检索后翻译更稳,但链路更复杂。
转换器会不会改变原文含义?
会有风险。翻译、摘要、QA 抽取都会引入模型误差。关键业务需要保留原文引用,并在答案中展示来源。
# 面试题
DocumentTransformer 和 TextSplitter 的区别是什么?
TextSplitter 主要把文本拆成多个片段;DocumentTransformer 更通用,可以清洗、翻译、抽取、重排或增强文档,输入输出都是 Document 列表。
为什么 QA 抽取能改善 RAG 召回?
它把陈述式文档转成问题入口,缩短用户 query 与文档之间的表达差距,从而提升相似度匹配机会。
多语言 RAG 如何设计?
可以统一翻译后入库,也可以原文入库后检索翻译。选择时看语言覆盖、准确性要求、成本、延迟和审计要求。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| QA 抽取内容不稳定 | 模型输出波动或文档过长 | 使用结构化输出、分段抽取、增加校验 |
| 翻译后召回偏移 | 专有名词、缩写、代码字段被误译 | 建立术语表,保护不可翻译字段 |
| metadata 过大 | 把完整 QA、摘要、实体都塞入单条记录 | 分字段存储,必要时拆成多条辅助文档 |
| 成本过高 | 每次入库都做 LLM 转换 | 增量处理、缓存 hash、只处理变更文档 |
| 合规风险 | 原文含敏感信息直接发给模型 | 脱敏、最小字段、审计、权限与数据保留控制 |