# Retriever 深入:从 VectorStore 到可组合检索能力
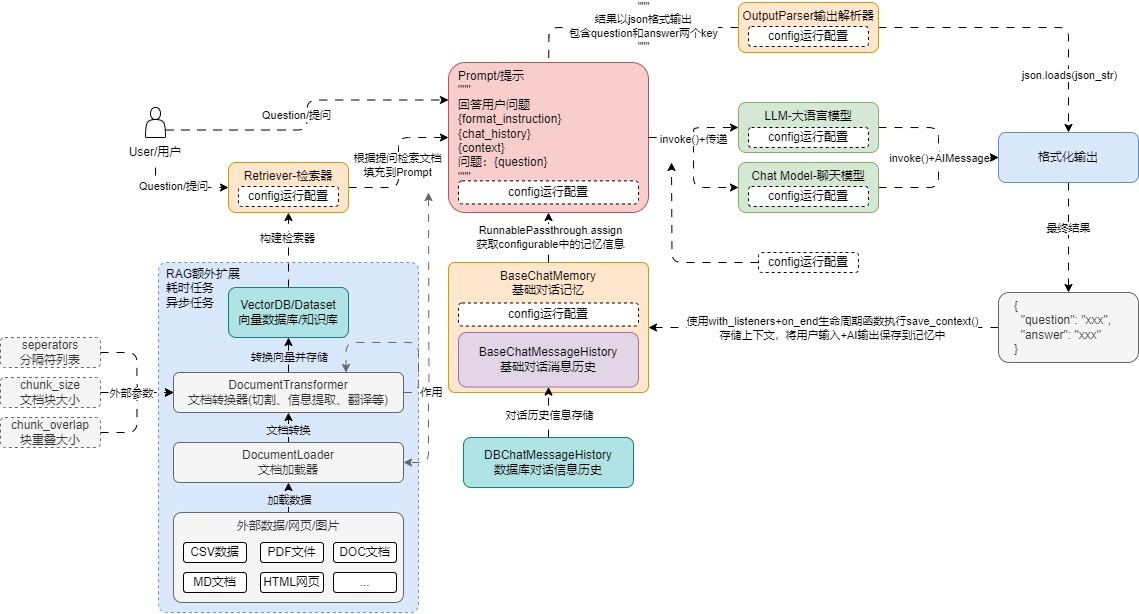
Retriever 是 RAG 查询链路的入口组件。它接收用户 query,返回相关 Document 列表。VectorStore 可以做检索,但 Retriever 把检索包装成统一接口,使它能接入 LCEL、Runnable 配置、重试、回退、监听器和运行时参数。
# BaseRetriever 的职责
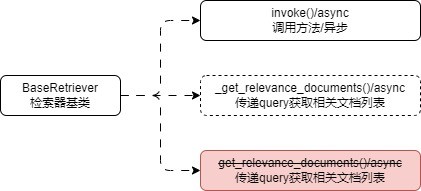
BaseRetriever 可以理解为“输入字符串,输出文档列表”的组件。它不要求底层一定是向量库,也可以是数据库、搜索引擎、API、文件系统或业务服务。
自定义 Retriever 需要实现 _get_relevant_documents()。如果有原生异步能力,可以额外实现 _aget_relevant_documents()。现在推荐通过 invoke()、ainvoke()、batch()、abatch() 调用,因为 Retriever 遵循 Runnable 接口。
# VectorStoreRetriever
向量库通过 as_retriever() 生成的通常是 VectorStoreRetriever。它主要包含三个信息:vectorstore、search_type 和 search_kwargs。
内部逻辑可以理解为根据 search_type 分发到不同方法:
if search_type == "similarity":
    docs = vectorstore.similarity_search(query, **search_kwargs)
elif search_type == "similarity_score_threshold":
    docs_and_scores = vectorstore.similarity_search_with_relevance_scores(query, **search_kwargs)
    docs = [doc for doc, _ in docs_and_scores]
elif search_type == "mmr":
    docs = vectorstore.max_marginal_relevance_search(query, **search_kwargs)
else:
    raise ValueError("search_type 不支持")
2
3
4
5
6
7
8
9
这也是为什么 as_retriever() 的参数很重要:它不是简单换个名字,而是在决定底层调用哪一种检索方法。
# 运行时可配置检索器
有些场景需要同一个检索器在不同请求中使用不同策略。例如普通问答走带阈值的相似性搜索,复杂问题走 MMR,后台评测时临时调整 k。可以用 configurable_fields() 暴露运行时可配置字段。
import dotenv
import weaviate
from langchain_core.runnables import ConfigurableField
from langchain_openai import OpenAIEmbeddings
from langchain_weaviate import WeaviateVectorStore
from weaviate.auth import AuthApiKey

dotenv.load_dotenv()

db = WeaviateVectorStore(
    client=weaviate.connect_to_wcs(
        cluster_url="https://example.weaviate.cloud",
        auth_credentials=AuthApiKey("WEAVIATE_API_KEY"),
    ),
    index_name="DatasetDemo",
    text_key="text",
    embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
)

retriever = db.as_retriever(
    search_type="similarity_score_threshold",
    search_kwargs={"k": 10, "score_threshold": 0.5},
).configurable_fields(
    search_type=ConfigurableField(id="db_search_type"),
    search_kwargs=ConfigurableField(id="db_search_kwargs"),
)

mmr_documents = retriever.with_config(
    configurable={
        "db_search_type": "mmr",
        "db_search_kwargs": {"k": 4},
    }
).invoke("关于应用配置的接口有哪些?")

print("搜索结果: ", mmr_documents)
print("内容长度:", len(mmr_documents))
print(mmr_documents[0].page_content[:20])
print(mmr_documents[1].page_content[:20])
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
这段代码先创建默认检索器,再把 search_type 和 search_kwargs 标记为可配置字段。调用时通过 with_config() 覆盖默认值,实现同一个检索器在不同请求中的策略切换。
# LCEL 中的配置传递
Retriever 进入 LCEL 链后,配置可以沿链路传递。常见链路是:
from langchain_core.runnables import RunnablePassthrough

chain = {
    "context": retriever,
    "question": RunnablePassthrough(),
} | prompt | llm | parser

answer = chain.with_config(
    configurable={
        "db_search_type": "similarity_score_threshold",
        "db_search_kwargs": {"k": 6, "score_threshold": 0.55},
    }
).invoke("配置接口如何使用?")
2
3
4
5
6
7
8
9
10
11
12
13
这使得检索策略可以由业务场景、用户等级、知识库类型或评测配置决定,而不是写死在代码里。
# Runnable 能力
Retriever 作为 Runnable,可以使用很多通用能力。
with_retry():底层向量库或网络调用偶发失败时重试。
with_fallbacks():主检索器失败时切到备用检索器,例如从 Weaviate 切到本地 FAISS 或关键词检索。
with_listeners():在调用开始、结束、报错时记录日志,便于观测召回内容和耗时。
configurable_alternatives():在运行时切换不同组件,比如不同向量库、不同 embedding 空间、不同业务索引。
bind():给 Runnable 绑定固定参数。但要注意,不是所有向量库检索器都会读取 invoke() 传入的额外 kwargs。很多检索参数应通过 search_kwargs 配置,而不是依赖 bind()。
# 最新版 LangChain 用法提示
当前 BaseRetriever 位于 langchain_core.retrievers,并明确遵循 Runnable 接口。官方参考也推荐使用 invoke()、ainvoke()、batch()、abatch()。
旧代码里常见的 get_relevant_documents() 已不建议作为主要入口。新项目要围绕 Runnable 组织检索链路,便于统一追踪、并发、配置和回退。
VectorStoreRetriever 的行为仍取决于底层向量库集成。不同集成对 filter、score_threshold、mmr 的支持可能不同,上线前必须用真实数据验证。
# 拓展
Retriever 可以作为权限边界。比如同一个向量库中存多租户数据,Retriever 层可以统一注入 tenant_id、dataset_id、document_status 等过滤条件。
Retriever 也可以作为路由入口。简单问题走单库检索,复杂问题走多库检索,工具型问题走 API 检索,无法判断时先做 query 分类。
还可以把 Retriever 输出接 reranker。向量召回取 fetch_k=30,reranker 排序后只给 LLM top 5,通常比直接 top 5 更稳。
# 常见问题
为什么 Retriever 返回的文档没有分数?
很多 Retriever 默认只返回 Document。如果需要分数,直接调用向量库的带分数方法,或封装一个自定义 Runnable 把 score 写入 metadata。
运行时配置会不会影响并发请求?
使用 with_config() 是单次调用配置,不应该修改全局对象。不要在请求处理中直接改共享 retriever 的属性。
什么时候需要自定义 Retriever?
当数据源不是标准向量库,或者需要复杂业务过滤、外部 API、混合召回、权限处理时,可以自定义 Retriever。
# 面试题
BaseRetriever 的核心抽象是什么?
输入 query 字符串,返回相关 Document 列表。它把检索来源统一成 Runnable 组件。
VectorStoreRetriever 如何根据 search_type 工作?
它根据 similarity、similarity_score_threshold、mmr 等类型分发到底层向量库的不同搜索方法。
为什么新代码推荐使用 invoke?
因为 Retriever 已经纳入 Runnable 体系,invoke() 能统一配置、追踪、并发、重试和组合方式。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 配置没有生效 | 字段没有用 configurable_fields() 暴露 | 检查 configurable id,并打印运行时配置 |
| 结果数量不稳定 | 阈值过滤后不足 k 条 | 区分期望 k 和实际命中数,增加降级策略 |
| bind 后参数无效 | 底层检索器不读取额外 kwargs | 使用 search_kwargs 或封装自定义 Retriever |
| 多用户串数据 | Retriever 未注入权限过滤 | 在 Retriever 层强制 metadata filter |
| 检索偶发失败 | 向量库网络抖动或超时 | 使用 with_retry()、超时、备用检索器 |