# 递归字符文本分割器的使用与运行流程
普通的字符文本分割器只能使用单个分隔符对文本内容进行划分。在划分过程中,经常会出现文档块过小或者过大的情况,这会让 RAG 的检索效果变得不可控。
如果文档块非常大,极端情况下某个块的内容长度可能直接超过 LLM 的上下文长度限制。这样这个文本块虽然已经被存储,但在问答时永远不会被完整引用到,相当于“数据进来了,但使用时又丢失了”。
如果文档块远小于上下文窗口,问题同样明显。过小的文档块信息密度太低,即使被填充进 Prompt,LLM 也可能无法从中提取出有用信息。比如一个 chunk 里只有半句话、一个短字段、几个无上下文的词,检索命中也无法支撑回答。
更理想的分割方式应该是:先按照高优先级分隔符进行初次分割;如果分割后的块仍然过大,就继续使用备选分隔符二次分割;如果块太小,就尝试和前后块合并。最终让所有文档块的长度尽量控制在指定大小附近。
LangChain 中的 RecursiveCharacterTextSplitter 就是为这种场景设计的。它可以接收一组分隔符和目标块大小,根据分隔符优先级对文本进行预分割,然后把小块合并,把大块递归切分,直到得到尽可能接近目标长度的文档块。
需要注意,最终文档块大小并不会完全相同。递归分割器的目标不是平均切分,而是在保留文本自然边界的前提下,让 chunk 尽量逼近设定长度。
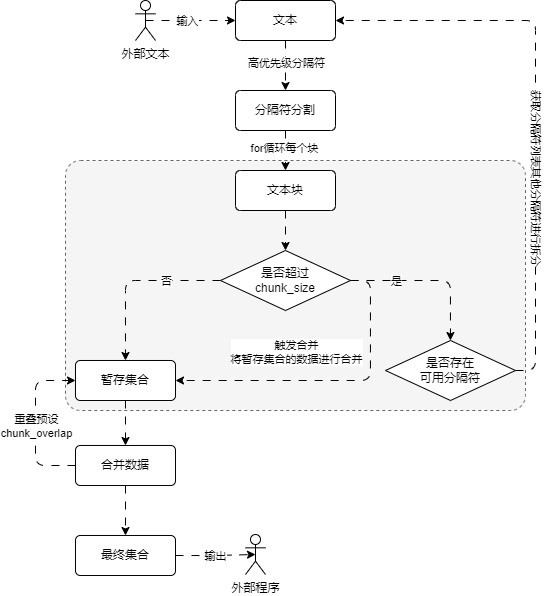
# 默认分隔符
RecursiveCharacterTextSplitter 默认分隔符为:
["\n\n", "\n", " ", ""]
它的优先级含义如下:
- 先使用两个换行符进行分割,也就是优先按段落切。
- 如果块内容仍然过大,再使用单个换行符切。
- 如果仍然过大,再使用空格切。
- 最后才使用空字符串,把内容拆到字符级别。
所以,在默认参数下,递归字符文本分割器最后得到的文档块长度一般不会超过预设大小。但仍然可能出现少量远小于目标大小的块,这和原始文本结构有关,目前没有绝对完美的解决方式。
# 基础示例
使用递归字符文本分割器处理 Markdown 文档:
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

loader = UnstructuredMarkdownLoader("./项目API文档.md")
documents = loader.load()

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    add_start_index=True,
)

chunks = text_splitter.split_documents(documents)

for chunk in chunks:
    print(f"块大小: {len(chunk.page_content)}, 元数据: {chunk.metadata}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
可能得到类似输出:
块大小: 251, 元数据: {'source': './项目API文档.md', 'start_index': 0}
块大小: 451, 元数据: {'source': './项目API文档.md', 'start_index': 246}
块大小: 490, 元数据: {'source': './项目API文档.md', 'start_index': 699}
块大小: 305, 元数据: {'source': './项目API文档.md', 'start_index': 1165}
块大小: 435, 元数据: {'source': './项目API文档.md', 'start_index': 1472}
块大小: 497, 元数据: {'source': './项目API文档.md', 'start_index': 1859}
块大小: 237, 元数据: {'source': './项目API文档.md', 'start_index': 2359}
块大小: 483, 元数据: {'source': './项目API文档.md', 'start_index': 2598}
块大小: 486, 元数据: {'source': './项目API文档.md', 'start_index': 3092}
块大小: 438, 元数据: {'source': './项目API文档.md', 'start_index': 3580}
块大小: 293, 元数据: {'source': './项目API文档.md', 'start_index': 4013}
块大小: 498, 元数据: {'source': './项目API文档.md', 'start_index': 4261}
块大小: 463, 元数据: {'source': './项目API文档.md', 'start_index': 4712}
块大小: 438, 元数据: {'source': './项目API文档.md', 'start_index': 5129}
块大小: 474, 元数据: {'source': './项目API文档.md', 'start_index': 5569}
块大小: 93, 元数据: {'source': './项目API文档.md', 'start_index': 6018}
块大小: 464, 元数据: {'source': './项目API文档.md', 'start_index': 6113}
块大小: 478, 元数据: {'source': './项目API文档.md', 'start_index': 6579}
块大小: 379, 元数据: {'source': './项目API文档.md', 'start_index': 7035}
块大小: 489, 元数据: {'source': './项目API文档.md', 'start_index': 7416}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
从输出可以看到,大部分块都接近 500,但并不是完全相同。start_index 表示当前 chunk 在原始文档中的起始位置,后续做引用和问题排查时非常有用。
# 底层运行流程
递归字符文本分割器底层运行流程可以拆成三步:
- 预分割:按照高优先级分隔符先把文本拆成候选片段。
- 大文档块递归分割:如果某个候选片段超过
chunk_size,继续使用下一优先级分隔符切分。 - 小文档块合并:如果片段较小,则尝试合并相邻片段,使结果尽量接近目标大小。
对比普通字符文本分割器,递归字符文本分割器可以传入多个分隔符,并根据不同分隔符的优先级执行对应分割。它不是简单地从左到右按固定长度截断,而是尽量优先保留更大的语义结构。
# 编程语言分割
递归字符文本分割器的核心能力在于传递不同优先级的分隔符列表。基于这一点,它也可以用于代码文件分割。
LangChain 内部预先构建了多种编程语言的分隔符列表。支持的编程语言类型存储在 langchain_text_splitters.Language 枚举中,常见值包括:
class Language(str, Enum):
    CPP = "cpp"
    GO = "go"
    JAVA = "java"
    KOTLIN = "kotlin"
    JS = "js"
    TS = "ts"
    PHP = "php"
    PROTO = "proto"
    PYTHON = "python"
    RST = "rst"
    RUBY = "ruby"
    RUST = "rust"
    SCALA = "scala"
    SWIFT = "swift"
    MARKDOWN = "markdown"
    LATEX = "latex"
    HTML = "html"
    SOL = "sol"
    CSHARP = "csharp"
    COBOL = "cobol"
    C = "c"
    LUA = "lua"
    PERL = "perl"
    HASKELL = "haskell"
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
如果想查看某种语言的分隔符,可以使用 get_separators_for_language():
from langchain_text_splitters import Language, RecursiveCharacterTextSplitter

separators = RecursiveCharacterTextSplitter.get_separators_for_language(
    Language.PYTHON
)
print(separators)
2
3
4
5
6
Python 对应的分隔符类似:
["\nclass ", "\ndef ", "\n\tdef ", "\n\n", "\n", " ", ""]
可以看出,Python 文件会优先按类切分,再按函数切分,然后再考虑类方法、模块语句、换行、空格和字符。
使用语言分割器的示例:
from langchain_community.document_loaders import UnstructuredFileLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter, Language

loader = UnstructuredFileLoader("./demo.py")
documents = loader.load()

text_splitter = RecursiveCharacterTextSplitter.from_language(
    language=Language.PYTHON,
    chunk_size=500,
    chunk_overlap=50,
    add_start_index=True,
)

chunks = text_splitter.split_documents(documents)

for chunk in chunks:
    print(f"块大小: {len(chunk.page_content)}, 元数据: {chunk.metadata}")

print(chunks[2].page_content)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
递归分割会尽可能从较大的结构上保证数据连续性。例如打印某个 Python 分块,可能得到:
def split_text(self, text: str) -> List[str]:
    """Split incoming text and return chunks."""
    # First we naively split the large input into a bunch of smaller ones.
    separator = (
        self._separator if self._is_separator_regex else re.escape(self._separator)
    )
    splits = _split_text_with_regex(text, separator, self._keep_separator)
    _separator = "" if self._keep_separator else self._separator
    return self._merge_splits(splits, _separator)
2
3
4
5
6
7
8
9
这类结果比按固定长度截断源码更可读,也更适合后续检索。
# 中文场景下的递归分割
默认分隔符更偏英文场景。中文文本除了换行和空格,还经常通过句号、感叹号、问号、分号、逗号等符号表达语义边界。
如果想更好地切分中文或中英文混合文档,可以重设分隔符列表,也可以继承该类做自定义扩展。
不同符号优先级可以这样设计:
\n\n:两个换行符,优先级最高,一般表示段落边界。\n:普通换行符,通常不会导致上下文语义明显丢失。。|!|?:中文句号、感叹号、问号,通常表示句子结束。\.\s|\!\s|\?\s:英文句号、感叹号、问号,标准英文写法中这些符号后通常有空格。;|;\s:中英文分号,表示较弱的分段边界。,|,\s:中英文逗号,表示语义还未完全结束,通常优先级较低,只有块仍然过大时才考虑。- 空格和空字符串:优先级最低。空字符串会把中文拆成单个汉字、英文拆成单个字母,几乎完全丢失语义,只有最后兜底时使用。
示例代码:
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 1. 创建加载器和文本分割器
loader = UnstructuredMarkdownLoader("./项目API文档.md")

text_splitter = RecursiveCharacterTextSplitter(
    separators=[
        "\n\n",
        "\n",
        "。|!|?",
        r"\.\s|\!\s|\?\s",  # 英文标点符号后面通常需要加空格
        ";|;\s",
        ",|,\s",
        " ",
        "",
    ],
    is_separator_regex=True,
    chunk_size=500,
    chunk_overlap=50,
    add_start_index=True,
)

# 2. 加载文档与分割
documents = loader.load()
chunks = text_splitter.split_documents(documents)

# 3. 输出信息
for chunk in chunks:
    print(f"块大小: {len(chunk.page_content)}, 元数据: {chunk.metadata}")

print(chunks[2].page_content)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
这种配置更适合中文知识库,尤其是内容以自然语言段落为主的文档。
# 在知识库系统中的参数设计
在真实知识库系统中,具体文本分割逻辑往往不应该写死。更合理的方式是由创建知识库的用户或后台配置决定分隔符、文档块大小和块重叠大小,然后动态生成 RecursiveCharacterTextSplitter。
例如:
from langchain_text_splitters import RecursiveCharacterTextSplitter

def create_text_splitter(
    separators: list[str],
    chunk_size: int,
    chunk_overlap: int,
) -> RecursiveCharacterTextSplitter:
    return RecursiveCharacterTextSplitter(
        separators=separators,
        is_separator_regex=True,
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        add_start_index=True,
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
文档加载器可以根据扩展名选择专用加载器,也可以通过通用非结构化文件加载器兜底。加载完成后,再把 Document 交给外部配置生成的分割器处理。
这样做的好处是,同一套 RAG 系统可以适配不同知识库:有的知识库偏中文段落,有的偏代码,有的偏接口文档,有的偏产品说明,不需要为每类数据写死一套分割逻辑。
# 最新版 LangChain 用法提示
最新版 LangChain 中,通用文本切分仍推荐使用 RecursiveCharacterTextSplitter。官方文档也强调,它会优先保留段落等较大结构,如果超出 chunk 大小,再逐步下钻到句子、词和字符级别。
推荐写法:
from langchain_text_splitters import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=200,
    add_start_index=True,
)

chunks = text_splitter.split_documents(documents)
2
3
4
5
6
7
8
9
需要注意:
langchain_text_splitters是独立包,使用前要确认依赖已安装。- 通用文本优先用递归字符分割器,而不是普通字符分割器。
- 中文文本要补充分隔符。
- 代码文本优先使用
from_language()。 - 生产中要根据评估集调整
chunk_size和chunk_overlap。
# 拓展
递归字符分割器适合大多数普通文本,但不是所有文本都应该使用同一种策略。
- Markdown 文档可以先按标题结构拆,再递归切分正文。
- HTML 文档可以先按标题层级拆,再切分段落。
- JSON 数据可以用 JSON 分割器保留结构。
- 代码文件可以按语言结构切分。
- 表格数据不适合直接按字符切,最好先结构化解析。
分割策略要服务于检索目标。如果用户的问题通常对应一个小段落,chunk 可以小一些;如果答案需要上下文推理,chunk 可以适当大一些,并保留 overlap。
# 常见问题
# 为什么递归分割后 chunk 大小不完全一样?
递归分割器不是平均切分工具。它会尽量保留自然边界,所以不同 chunk 大小可能不同,只要整体接近目标大小即可。
# chunk_overlap 设置多少合适?
通常可以先设置为 chunk_size 的 10% 到 20%。如果答案经常被切断,可以适当增加;如果检索结果重复严重,就要降低。
# 中文文本为什么要自定义 separators?
中文没有英文空格分词习惯,默认分隔符可能无法按句子切开。加入中文标点后,chunk 更容易保持语义完整。
# 为什么空字符串优先级最低?
空字符串会把文本切到单字符级别。它能保证块不会超过目标大小,但语义破坏最大,所以只能作为最后兜底。
# 面试题
# RecursiveCharacterTextSplitter 的递归体现在哪里?
它按分隔符优先级逐层尝试切分。上一级分隔符切出的文本块如果仍然超过 chunk_size,就继续使用下一级分隔符切分,直到满足大小要求。
# 它和 CharacterTextSplitter 的区别是什么?
CharacterTextSplitter 主要按单一分隔符切分;RecursiveCharacterTextSplitter 会按分隔符列表递归切分,更适合结构复杂、段落长度不稳定的文本。
# 为什么 add_start_index=True 很重要?
它能记录 chunk 在原文中的起始位置,方便答案引用、原文回溯和线上问题排查。
# 如何处理代码文档切分?
优先使用 RecursiveCharacterTextSplitter.from_language(),根据编程语言选择更符合代码结构的分隔符,例如 Python 优先按 class、def 切分。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| chunk 过大 | 分隔符不合适,chunk_size 太大 | 调整 separators,降低 chunk_size |
| chunk 过小 | 分隔符过细,合并后仍不足 | 增大 chunk_size,减少过细分隔符 |
| 中文切分很差 | 没有加入中文标点 | 自定义中文 separators |
| 检索结果重复 | overlap 太大 | 降低 chunk_overlap 或使用 MMR |
| 答案缺上下文 | overlap 太小或 chunk 太小 | 增加 chunk_size 或 overlap |
| 无法定位原文 | 没有 start_index | 开启 add_start_index |
| 代码被切断 | 使用普通文本分割 | 使用 from_language 按语言切分 |