# VectorStore 深入:相似度检索、得分与过滤
VectorStore 是 RAG 链路里连接 embedding 与检索的核心组件。Loader 和 Splitter 解决“文档怎么进来、怎么切”,Embedding 解决“文本如何映射到向量空间”,VectorStore 则负责“向量如何存、如何查、如何过滤、如何返回”。
# VectorStore 抽象
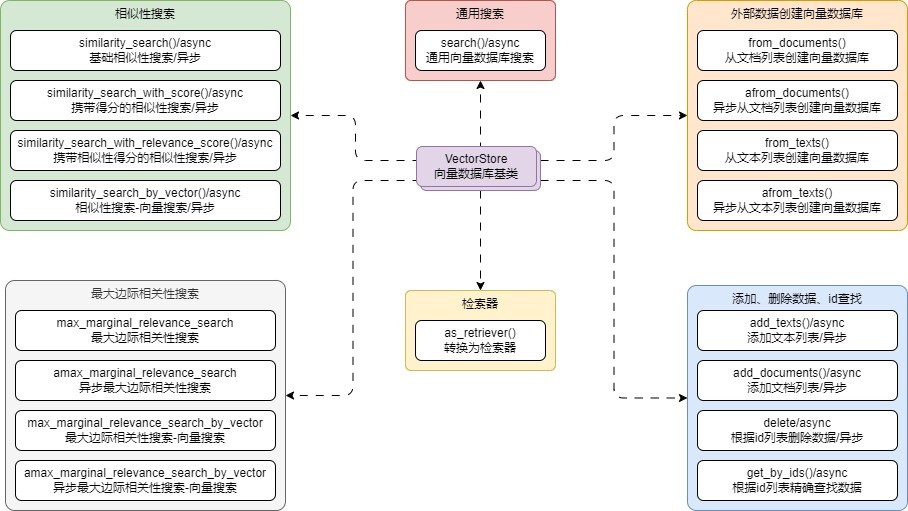
LangChain 的 VectorStore 是一个统一接口。不同向量数据库的存储结构、索引方式、过滤语法和部署形态不一样,但在应用层一般都需要这些能力:
| 能力 | 作用 |
|---|---|
add_documents | 把 Document 写入向量库 |
similarity_search | 按相似度返回文档 |
similarity_search_with_relevance_scores | 返回文档和相关性得分 |
max_marginal_relevance_search | 在相关性和多样性之间做平衡 |
as_retriever | 把向量库包装成 Retriever,接入 Runnable 链路 |
相同的 Loader、Splitter、Embedding,换不同的检索策略,最终返回给 LLM 的上下文可能完全不同。
# 为什么需要得分阈值
普通相似性搜索通常会返回 top_k。问题是:即使 query 与知识库毫不相关,它也会从库里找出“相对最像”的几条。这些结果不是正确证据,只是库里最接近的噪声。
similarity_search_with_relevance_scores 可以返回分数,并配合 score_threshold 过滤弱相关内容。当分数不足时宁可少返回,也不要把低质量上下文交给 LLM。
import dotenv
from langchain_community.vectorstores import FAISS
from langchain_core.documents import Document
from langchain_openai import OpenAIEmbeddings

dotenv.load_dotenv()

embedding = OpenAIEmbeddings(model="text-embedding-3-small")

documents = [
    Document(page_content="笨笨是一只很喜欢睡觉的猫咪", metadata={"page": 1}),
    Document(page_content="我喜欢在夜晚听音乐,这让我感到放松。", metadata={"page": 2}),
    Document(page_content="猫咪在窗台上打盹,看起来非常可爱。", metadata={"page": 3}),
    Document(page_content="掌握新技能是每个人都应该追求的目标。", metadata={"page": 4}),
    Document(page_content="我最喜欢的食物是意大利面,尤其是番茄酱的那种。", metadata={"page": 5}),
    Document(page_content="昨晚我做了一个奇怪的梦,梦见自己在太空飞行。", metadata={"page": 6}),
    Document(page_content="我的手机突然关机了,让我有些焦虑。", metadata={"page": 7}),
    Document(page_content="阅读是我每天都会做的事情,我觉得很充实。", metadata={"page": 8}),
    Document(page_content="他们一起计划了一次周末的野餐,希望天气能好。", metadata={"page": 9}),
    Document(page_content="我的狗喜欢追逐球,看起来非常开心。", metadata={"page": 10}),
]

db = FAISS.from_documents(documents, embedding)

results = db.similarity_search_with_relevance_scores(
    "我养了一只猫,叫笨笨",
    score_threshold=0.4,
)
print(results)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
这个例子里,query 同时包含“猫”和“笨笨”。如果不设阈值,可能返回所有相对接近的文本;加入阈值后,更可能留下真正包含关键信息的文档。
# as_retriever 的搜索类型
as_retriever() 会把 VectorStore 包装成 Retriever。常见配置如下:
retriever = db.as_retriever(
    search_type="similarity_score_threshold",
    search_kwargs={"k": 10, "score_threshold": 0.5},
)
2
3
4
search_type 常见有三种。
similarity:只做相似性搜索,返回 top_k。适合多数常规问答,链路简单,延迟低。
similarity_score_threshold:在相似性搜索基础上增加分数阈值。适合要求答案必须有依据的场景。
mmr:最大边际相关性搜索,会从候选集中选择相关但不重复的文档。适合知识点分散、需要覆盖多个角度的查询。
search_kwargs 常见参数包括 k、filter、score_threshold、fetch_k、lambda_mult。k 是最终返回数量,fetch_k 是 MMR 的初始候选数量,lambda_mult 控制相关性和多样性的权重。
# Weaviate 检索器示例
import dotenv
import weaviate
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_weaviate import WeaviateVectorStore
from weaviate.auth import AuthApiKey

dotenv.load_dotenv()

loader = UnstructuredMarkdownLoader("./项目API文档.md")
text_splitter = RecursiveCharacterTextSplitter(
    separators=["\n\n", "\n", "。|!|?", r"\.\s|\!\s|\?\s", ";|;\\s", ",|,\\s", " ", ""],
    is_separator_regex=True,
    chunk_size=500,
    chunk_overlap=50,
    add_start_index=True,
)

documents = loader.load()
chunks = text_splitter.split_documents(documents)

db = WeaviateVectorStore(
    client=weaviate.connect_to_wcs(
        cluster_url="https://example.weaviate.cloud",
        auth_credentials=AuthApiKey("WEAVIATE_API_KEY"),
    ),
    index_name="DatasetDemo",
    text_key="text",
    embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
)

db.add_documents(chunks)

retriever = db.as_retriever(
    search_type="similarity_score_threshold",
    search_kwargs={"k": 10, "score_threshold": 0.5},
)

documents = retriever.invoke("关于配置接口的信息有哪些")
print(list(document.page_content[:50] for document in documents))
print(len(documents))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
这里的关键不是 Weaviate 本身,而是完整链路:加载文档、切分、写入向量库、转换成 Retriever、通过 invoke() 查询。
# MMR 检索
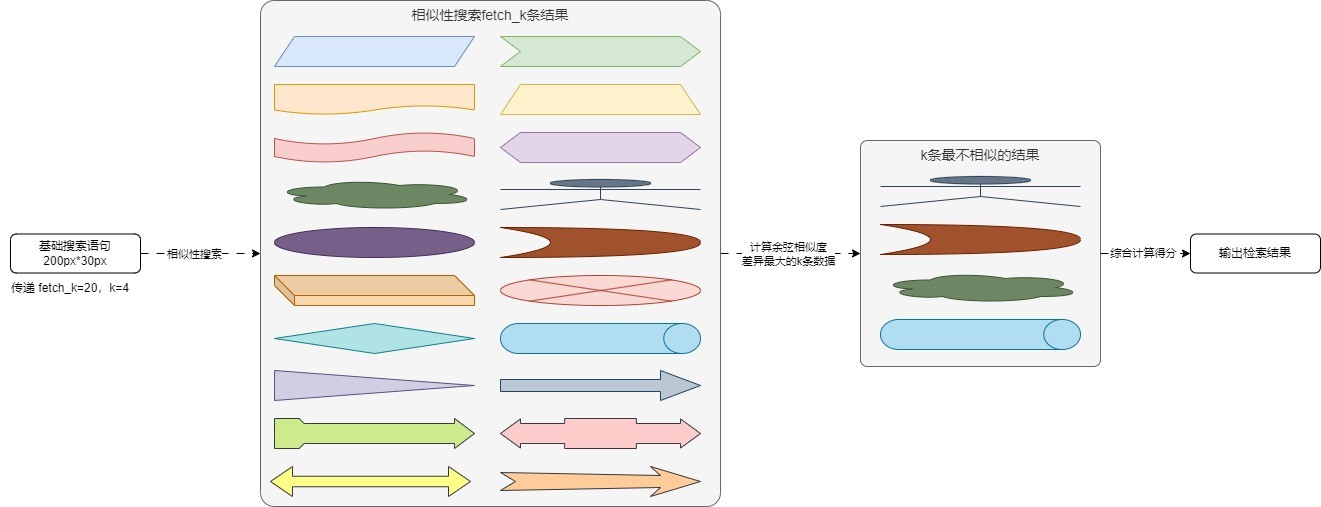
最大边际相关性搜索适合“既要相关,又不要全都重复”的场景。它通常先取 fetch_k 个候选,再从中选择 k 个结果。选择时会同时考虑 query 与文档的相关性,以及候选文档之间的相似度。
search_documents = db.max_marginal_relevance_search(
    "关于应用配置的接口有哪些?",
    k=4,
    fetch_k=20,
    lambda_mult=0.5,
)

for document in search_documents:
    print(document.page_content[:100])
    print("===========")
2
3
4
5
6
7
8
9
10
lambda_mult 越接近 1,越偏向相似性;越接近 0,越偏向多样性。多数问答场景先用相似性搜索即可;当召回结果重复、多个 chunk 都来自同一小段内容时,再考虑 MMR。
# 如何保留分数
Retriever 默认返回 Document 列表,不一定保留得分。如果业务要展示置信度、做二次排序或阈值告警,可以直接调用 similarity_search_with_relevance_scores,把分数写入 metadata,再继续下游链路。
from langchain_core.runnables import RunnableLambda


def search_with_scores(query: str):
    pairs = db.similarity_search_with_relevance_scores(query, score_threshold=0.5)
    documents = []
    for document, score in pairs:
        document.metadata["score"] = score
        documents.append(document)
    return documents

retriever_with_scores = RunnableLambda(search_with_scores)
documents = retriever_with_scores.invoke("配置接口有哪些?")
2
3
4
5
6
7
8
9
10
11
12
13
# 最新版 LangChain 用法提示
当前 VectorStore 抽象位于 langchain_core.vectorstores,FAISS 集成来自 langchain_community.vectorstores,OpenAI Embedding 建议从 langchain_openai 导入,Weaviate 建议使用 langchain_weaviate.WeaviateVectorStore。
新代码优先使用 invoke() 调 Retriever。不要依赖旧式 get_relevant_documents() 作为主调用入口。
as_retriever() 仍然是把向量库接入 LCEL/Runnable 链路的常用方式,但具体 search_kwargs 是否支持,要看对应向量库集成。
# 拓展
向量库检索通常还会结合 metadata filter。比如知识库多租户场景必须过滤 tenant_id、dataset_id;文档多版本场景要过滤版本号;权限场景要过滤用户可见范围。
还可以做混合检索:向量召回负责语义相似,关键词或 BM25 召回负责精确词命中,然后合并去重、rerank。API 文档、错误码、字段名这类内容,纯向量检索可能不如混合检索稳定。
# 常见问题
为什么 query 不相关时仍然能返回结果?
因为 top_k 返回的是相对最相似,而不是绝对相关。需要得分阈值、拒答策略或结果质量检查。
score_threshold 应该设多少?
没有固定值。要基于语料、embedding 模型、切分方式和业务容错做评测。可以从 0.4 或 0.5 开始,观察召回率和误召回。
MMR 会不会降低准确率?
可能。MMR 为了多样性会牺牲部分相似度。它适合结果重复严重或问题需要多角度证据的场景。
# 面试题
VectorStore 和 Retriever 的关系是什么?
VectorStore 负责向量存储和检索能力,Retriever 是面向查询链路的抽象。as_retriever() 可以把 VectorStore 包装成 Retriever。
为什么要使用带阈值的相似性搜索?
为了避免不相关 query 也返回低质量 top_k,从而降低 LLM 基于错误上下文生成答案的风险。
MMR 的核心思想是什么?
在 query 相关性和候选文档之间的差异性之间做权衡,尽量返回相关且不重复的上下文。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 不相关问题仍有答案 | 低相关 chunk 被返回 | 增加阈值、拒答策略和引用校验 |
| 召回全来自同一段 | chunk 重叠过大或相似性搜索重复 | 使用 MMR,降低 overlap,去重 |
| 重要结果被过滤掉 | score_threshold 太高或 embedding 不合适 | 降低阈值,重评 embedding,检查切分 |
| metadata filter 不生效 | 字段名、类型或索引配置错误 | 写入后抽样查询,增加过滤单测 |
| 成本和延迟升高 | k、fetch_k 过大或多路召回无缓存 | 控制候选数量,缓存检索结果,增加超时策略 |