# 多查询改写:提升 RAG 召回准确率
把一个用户问题改写成多个检索 query,扩大召回覆盖面。
# 01. Multi-Query 多查询策略
多查询策略 也被称为 子查询,是一种用于生成子问题的技术,其核心思想是在问答过程中,为了更好地理解和回答主问题,系统会自动生成并提出与主问题相关的子问题,这些子问题通常具有更具体的细节,可以帮助大语言模型更深入地理解主问题,从而进行更加准确的检索并提供正确的答案。
多查询策略 会从多个角度重写用户问题,为每个重写的问题执行检索,然后将检索到的文档列表进行合并后去重,返回唯一文档,该策略的运行流程非常简单,如下:
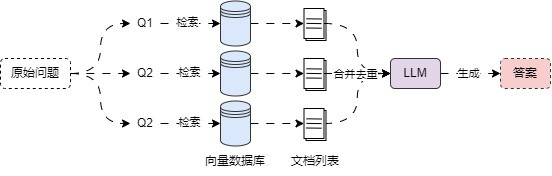
在 LangChain 中,针对 多查询策略 封装了一个检索器 MultiQueryRetriever,该检索器可以通过构造函数亦或者 from_llm 类方法进行实例化,参数如下:
retriever:基础检索器,必填参数。llm:大语言模型,用于将原始问题转换成多个问题,必填参数。prompt:转换原始问题为多个问题的提示模板,非必填,已有默认值。parser_key:解析键,该参数在未来将被抛弃,非必填,已弃用,新版本中保留参数,但没有任何使用的地方。inclued_original:是否保留原始问题,默认为False,如果设置为True,则除了检索新问题,还会检索原始问题。
例如以 weaviate 向量数据库作为检索器,使用 多查询策略 优化普通的 RAG检索,对应的代码具象化如下:
import dotenv
import weaviate
from langchain.retrievers import MultiQueryRetriever
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_weaviate import WeaviateVectorStore
from weaviate.auth import AuthApiKey

dotenv.load_dotenv()

# 1.构建向量数据库与检索器
db = WeaviateVectorStore(
 client=weaviate.connect_to_wcs(
 cluster_url="https://eftofnujtxqcsa0sn272jw.c0.us-west3.gcp.weaviate.cloud",
 auth_credentials=AuthApiKey("21pzYy0orl2dxH9xCoZG1O2b0euDeKJNEbB0"),
 ),
 index_name="DatasetDemo",
 text_key="text",
 embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
)
retriever = db.as_retriever(search_type="mmr")

# 2.创建多查询检索器
multi_query_retriever = MultiQueryRetriever.from_llm(
 retriever=retriever,
 llm=ChatOpenAI(model="gpt-3.5-turbo-16k", temperature=0),
)

# 3.执行检索
docs = multi_query_retriever.invoke("关于LLMOps应用配置的文档有哪些")
print(docs)
print(len(docs))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
输出内容:
[Document(metadata={'source': './项目API文档.md', 'start_index': 0.0}, page_content='LLMOps 项目 API 文档\n\n应用 API 接口统一以 JSON 格式返回,并且包含 3 个字段:code、data 和 message,分别代表业务状态码、业务数据和接口附加信息。\n\n业务状态码共有 6 种,其中只有 success(成功) 代表业务操作成功,其他 5 种状态均代表失败,并且失败时会附加相关的信息:fail(通用失败)、not_found(未找到)、unauthorized(未授权)、forbidden(无权限)和validate_error(数据验证失败)。\n\n接口示例:\n\njson { "code": "success", "data": { "redirect_url": "https://github.com/login/oauth/authorize?client_id=f69102c6b97d90d69768&redirect_uri=http%3A%2F%2Flocalhost%3A5001%2Foauth%2Fauthorize%2Fgithub&scope=user%3Aemail" }, "message": "" }'), Document(metadata={'source': './项目API文档.md', 'start_index': 3042.0}, page_content='1.2 [todo]更新应用草稿配置信息\n\n接口说明:更新应用的草稿配置信息,涵盖:模型配置、长记忆模式等,该接口会查找该应用原始的草稿配置并进行更新,如果没有原始草稿配置,则创建一个新配置作为草稿配置。\n\n接口信息:授权+POST:/apps/:app_id/config\n\n接口参数:\n\n请求参数:\n\napp_id -> str:需要修改配置的应用 id。\n\nmodel_config -> json:模型配置信息。\n\ndialog_round -> int:携带上下文轮数,类型为非负整型。\n\nmemory_mode -> string:记忆类型,涵盖长记忆 long_term_memory 和 none 代表无。\n\n请求示例:\n\njson { "model_config": { "dialog_round": 10 }, "memory_mode": "long_term_memory" }\n\n响应示例:\n\njson { "code": "success", "data": {}, "message": "更新AI应用配置成功" }\n\n1.3 [todo]获取应用调试长记忆'), Document(metadata={'source': './项目API文档.md', 'start_index': 5818.0}, page_content='json { "code": "success", "data": { "list": [ { "id": "1550b71a-1444-47ed-a59d-c2f080fbae94", "conversation_id": "2d7d3e3f-95c9-4d9d-ba9c-9daaf09cc8a8", "query": "能详细讲解下LLM是什么吗?", "answer": "LLM 即 Large Language Model,大语言模型,是一种基于深度掌握的自然语言处理模型,具有很高的语言理解和生成能力,能够处理各式各样的自然语言任务,例如文本生成、问答、翻译、摘要等。它通过在大量的文本数据上进行训练,掌握到语言的模式、结构和语义知识'), Document(metadata={'source': './项目API文档.md', 'start_index': 675.0}, page_content='json { "code": "success", "data": { "list": [ { "app_count": 0, "created_at": 1713105994, "description": "这是专门用来存储慕课LLMOps内容信息的知识库", "document_count": 13, "icon": "https://imooc-llmops-1257184990.cos.ap-guangzhou.myqcloud.com/2024/04/07/96b5e270-c54a-4424-aece-ff8a2b7e4331.png", "id": "c0759ca8-2d35-4480-83a8-1f41f29d1401", "name": "慕课LLMOps内容知识库", "updated_at": 1713106758, "word_count": 8850 } ], "paginator": { "current_page": 1, "page_size": 20, "total_page": 1, "total_record": 2 } }'), Document(metadata={'source': './项目API文档.md', 'start_index': 2324.0}, page_content='json { "code": "success", "data": { "id": "5e7834dc-bbca-4ee5-9591-8f297f5acded", "name": "慕课LLMOps聊天机器人", "icon": "https://imooc-llmops-1257184990.cos.ap-guangzhou.myqcloud.com/2024/04/23/e4422149-4cf7-41b3-ad55-ca8d2caa8f13.png", "description": "这是一个慕课LLMOps的Agent应用", "published_app_config_id": null, "drafted_app_config_id": null, "debug_conversation_id": "1550b71a-1444-47ed-a59d-c2f080fbae94", "published_app_config": null, "drafted_app_config": { "id": "755dc464-67cd-42ef-9c56-b7528b44e7c8"'), Document(metadata={'source': './项目API文档.md', 'start_index': 2042.0}, page_content='dialog_round -> int:携带上下文轮数,类型为非负整型。\n\nmemory_mode -> string:记忆类型,涵盖长记忆 long_term_memory 和 none 代表无。\n\nstatus -> string:应用配置的状态,drafted 代表草稿、published 代表已发布配置。\n\nupdated_at -> int:应用配置的更新时间。\n\ncreated_at -> int:应用配置的创建时间。\n\nupdated_at -> int:应用的更新时间。\n\ncreated_at -> int:应用的创建时间。\n\n响应示例:')]
6
2
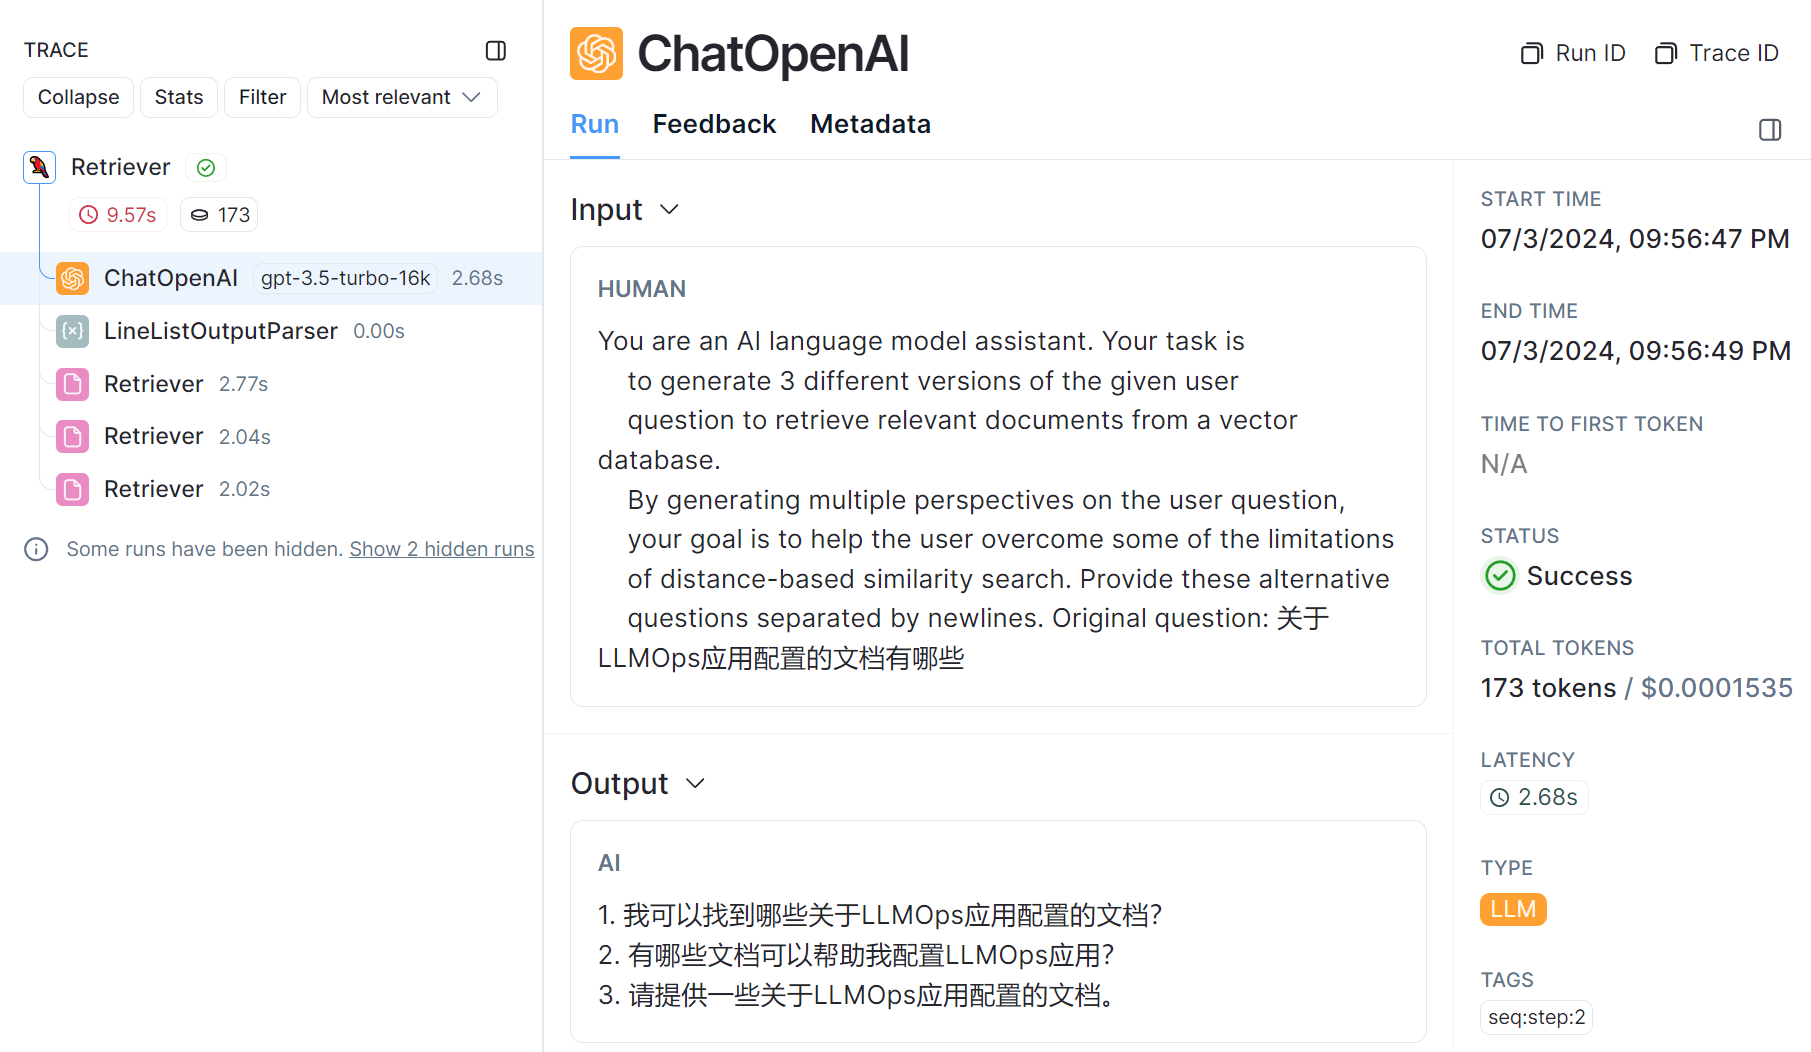
亦或者在 LangSmith 平台上也可以观测到整个执行的流程,如下:
# 02. 核心及注意事项
从 LangSmith 平台记录的运行流程,可以很清晰看到这个检索器会先调用大语言模型生成 3 条与原始问题相关的 子问题,然后再逐个使用传递的检索器检索 3 个子问题,得到对应的文档列表,最后再将所有文档列表进行合并去重,得到最终的文档。
在 MultiQueryRetriever 这个检索器中,预设了一段 prompt,用于将原始问题生成 3 个关联子问题,并使用 \n 分割得到具体问题。
这段 prompt 如下:
# langchain/retrievers/multi_query.py
DEFAULT_QUERY_PROMPT = PromptTemplate(
 input_variables=["question"],
 template="""You are an AI language model assistant. Your task is to generate 3 different versions of the given user question to retrieve relevant documents from a vector database. By generating multiple perspectives on the user question, your goal is to help the user overcome some of the limitations of distance-based similarity search. Provide these alternative questions separated by newlines. Original question: {question}""",
)
2
3
4
5
在 LangChain 中,所有预设的 prompt 绝大部分场景都是使用 OpenAI 的大语言模型进行调试的,所以效果会比较好,对于其他的模型,例如国内的模型,一般来说还需要将对应的提示换成 中文语言,所以可以考虑使用 ChatGPT 翻译原有的 prompt,更新后:
multi_query_retriever = MultiQueryRetriever.from_llm(
 retriever=retriever,
 llm=ChatOpenAI(model="gpt-3.5-turbo-16k", temperature=0),
 prompt=ChatPromptTemplate.from_template(
 "你是一个AI语言模型助手。你的任务是生成给定用户问题的3个不同版本,以从向量数据库中检索相关文档。"
 "通过提供用户问题的多个视角,你的目标是帮助用户克服基于距离的相似性搜索的一些限制。"
 "请用换行符分隔这些替代问题。"
 "原始问题:{question}"
 )
)
2
3
4
5
6
7
8
9
10
基于中文 prompt 生成的问题列表如下:
1. LLMOps应用配置的文档有哪些资源可供参考?
2. 我可以在哪里找到关于LLMOps应用配置的文档?
3. 有哪些文档可以帮助我了解LLMOps应用配置的相关信息?
2
3
对于该检索器,不同的模型生成的 query 格式可能并不一样,某些模型生成的多条 query 可能并不是按照 \n 进行分割,这个时候查询的效果可能不如原始问题,所以在使用该检索器时,一定要多次测试 prompt 的效果,或者设置 inclued_original 为 True,确保生成内容不符合规范时,仍然可以使用原始问题进行检索。
另外,在 MultiQueryRetriever 的底层进行合并去重时,并没有任何特别的,仅仅只做了循环遍历并记录唯一的文档而已,核心代码:
# langchain/retrievers/multi_query.py
def _unique_documents(documents: Sequence[Document]) -> List[Document]:
 return [doc for i, doc in enumerate(documents) if doc not in documents[:i]]
2
3
多查询策略是最基础+最简单的 RAG 优化,不涉及到复杂的逻辑与算法,会稍微影响单次对话的耗时。
并且由于需要转换 query 一般较小,以及生成 sub-queries 时对 LLM 的能力要求并不高,在实际的 LLM 应用开发中,通常使用参数较小的本地模型+针对性优化的 prompt 即可完成任务。
而且为了减少模型的幻觉以及胡说八道,一般都将 temperature 设置为 0,确保生成的文本更加有确定性。
# 最新版 LangChain 用法提示
新项目要优先确认组件所在包名。核心抽象通常在 langchain_core,文档分割在 langchain_text_splitters,OpenAI 相关集成在 langchain_openai,大量社区组件在 langchain_community 或独立集成包中。
涉及 Retriever、Runnable、LCEL、LangGraph 的链路,建议用 invoke() / ainvoke() 作为统一调用入口,并把检索参数、路由条件、重排参数和降级策略显式配置出来。不要只照搬旧导入路径。
# 拓展
多查询改写:提升 RAG 召回准确率 不应该孤立使用。RAG 优化通常要和评测集、召回日志、答案引用、用户反馈、成本统计一起看。只优化某一个环节,可能会让另一个环节退化。
工程上建议把 query、改写后的 query、召回文档、metadata filter、重排得分、最终 Prompt 和模型输出都记录下来。否则问题出现时,很难判断是加载、切分、Embedding、检索、重排、Prompt 还是生成阶段出了问题。
# 常见问题
什么时候需要使用这个策略?
当普通向量检索已经不能稳定命中关键证据,或者复杂问题经常漏召回、召回重复、上下文不完整时,就需要引入该类优化。
它能替代基础 RAG 链路吗?
不能。优化策略依赖基础链路。文档质量、chunk 设计、Embedding 模型、metadata 规范和 Retriever 配置没有打好,后续策略只能缓解,不能根治。
如何判断优化是否有效?
用固定评测集对比优化前后:召回命中率、答案正确率、引用正确率、拒答准确率、延迟和成本。只看单个 demo 很容易误判。
# 面试题
RAG 优化应该从哪里开始?
先定位问题阶段:文档是否解析正确、chunk 是否完整、Embedding 是否适合、检索是否命中、上下文是否可用、模型是否按证据回答。定位后再选择对应策略。
为什么复杂 RAG 系统需要可观测性?
因为答案错误可能来自任意环节。没有检索日志、重排分数、Prompt 和输出记录,就只能靠猜。
如何避免优化策略越加越乱?
每个策略都要有触发条件、输入输出、评测指标和降级方案。能用简单策略解决的问题,不要过早引入复杂链路。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 优化后更慢 | 多路检索、重排或图分支增加调用次数 | 增加超时、缓存、并行和候选裁剪 |
| 召回更多但更乱 | 多查询或混合检索没有去重和重排 | 使用 RRF、rerank、source_id 去重 |
| 答案仍然无依据 | 上下文质量低或 Prompt 没有约束证据 | 增加引用要求、拒答策略和证据检查 |
| 成本上涨明显 | 过多 LLM 改写、摘要或评估调用 | 缓存中间结果,限制触发条件 |
| 线上效果不稳定 | 缺少评测集和回归流程 | 固化 golden set,发布前跑回归 |