# 自定义 LangChain 文档加载器使用技巧
对于企业内部数据,例如数据库记录、API 接口、工单系统、知识库平台等,通用文档加载器通常很难直接满足要求。它们也许能把内容读出来,但数据格式、字段结构、权限信息、业务主键、更新时间等往往不符合 RAG 系统的需要。
例如网页加载器可能会提取到大量空白、换行、Tab、导航文字和页脚信息。如果这些内容直接进入向量数据库,会降低检索和生成的准确性。
在 LangChain 中,自定义文档加载器的实现并不复杂。核心思路是继承 BaseLoader,并实现 lazy_load() 方法。如果存在异步读取场景,再实现 alazy_load()。
# 自定义 Loader 的职责
自定义 Loader 负责把业务数据源转换成 Document。它应该处理:
- 从文件、数据库、API 或消息队列中读取数据。
- 把每条业务数据整理成
page_content。 - 把来源、主键、行号、更新时间、权限等信息写入
metadata。 - 通过
yield Document(...)输出标准文档对象。
它不应该负责:
- 文本向量化。
- 写入向量库。
- 调用 LLM。
- 拼 Prompt。
- 生成最终答案。
这些动作属于后续链路。如果都写在 Loader 中,后面排查会非常困难。
# 逐行文本加载示例
假设有一个文本文件,需要把每一行都转换成一个 Document。可以这样实现:
from typing import Iterator, AsyncIterator

from langchain_core.document_loaders import BaseLoader
from langchain_core.documents import Document


class CustomDocumentLoader(BaseLoader):
    """自定义文档加载器,将文本文件的每一行都解析成 Document"""

    def __init__(self, file_path: str) -> None:
        self.file_path = file_path

    def lazy_load(self) -> Iterator[Document]:
        # 1. 读取对应的文件
        with open(self.file_path, encoding="utf-8") as f:
            line_number = 0
            # 2. 提取文件的每一行
            for line in f:
                # 3. 将每一行生成一个 Document 实例并通过 yield 返回
                yield Document(
                    page_content=line,
                    metadata={
                        "source": self.file_path,
                        "line_number": line_number,
                    },
                )
                line_number += 1

    async def alazy_load(self) -> AsyncIterator[Document]:
        import aiofiles

        async with aiofiles.open(self.file_path, encoding="utf-8") as f:
            line_number = 0
            async for line in f:
                yield Document(
                    page_content=line,
                    metadata={
                        "source": self.file_path,
                        "line_number": line_number,
                    },
                )
                line_number += 1


loader = CustomDocumentLoader("./喵喵.txt")
documents = loader.load()

print(documents)
print(len(documents))
print(documents[0].metadata)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
这里的关键点是 lazy_load()。它不是一次性返回所有 Document,而是通过 yield 逐条返回。这样在数据量较大时,可以边读取边处理,减少内存压力。
# 为什么要保留 metadata
自定义 Loader 最大的价值之一,就是可以在加载阶段补齐业务 metadata。
例如一条工单记录可以转换成:
from langchain_core.documents import Document

document = Document(
    page_content="用户反馈支付成功后订单状态未更新,客服建议重新查询支付流水。",
    metadata={
        "source": "ticket_system",
        "ticket_id": "T202608130001",
        "user_id": "U10086",
        "category": "payment",
        "updated_at": "2026-08-13 10:30:00",
        "tenant_id": "default",
    },
)
2
3
4
5
6
7
8
9
10
11
12
13
这些字段后续可以用于:
- 按租户过滤。
- 按业务分类过滤。
- 展示答案引用来源。
- 删除或更新旧数据。
- 排查线上 bad case。
如果加载阶段没有写入这些信息,后续再补通常很困难。
# 最新版 LangChain 用法提示
最新版 LangChain 中,自定义 Loader 的思路仍然建议保留:继承 BaseLoader,输出 Document。需要注意的是,生产中更推荐把 lazy_load() 当作主要实现方式,而不是只实现一次性加载。
推荐写法:
from collections.abc import Iterator
from langchain_core.document_loaders import BaseLoader
from langchain_core.documents import Document


class ApiRecordLoader(BaseLoader):
    def __init__(self, client) -> None:
        self.client = client

    def lazy_load(self) -> Iterator[Document]:
        for record in self.client.iter_records():
            yield Document(
                page_content=record["content"],
                metadata={
                    "source": "internal_api",
                    "record_id": record["id"],
                    "updated_at": record["updated_at"],
                },
            )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
对于需要异步调用的 API 或异步文件读取,可以额外实现 alazy_load()。如果项目暂时不需要异步能力,可以先只实现 lazy_load()。
不建议在自定义 Loader 中直接做:
# 不建议放在 Loader 中
embedding = embeddings.embed_query(text)
vector_store.add_texts([text])
answer = llm.invoke(prompt)
2
3
4
这些属于索引和问答阶段,应该留在 Loader 之后处理。
# 拓展
自定义 Loader 可以接入很多业务场景:
- 数据库知识表:每行记录转成一个 Document。
- 工单系统:标题、问题描述、处理方案合并成 page_content。
- API 文档系统:接口路径、请求参数、响应字段组成文档。
- 对象存储:读取文件内容,并把 bucket、key、etag 写入 metadata。
- 权限系统:把租户、部门、角色写入 metadata,检索时过滤。
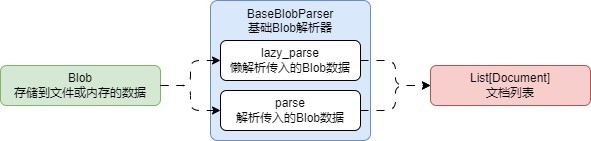
当数据源很复杂时,可以把读取和解析继续拆开:Loader 负责产生原始记录,Parser 负责把原始记录转换成 Document。
# 常见问题
# 自定义 Loader 一定要实现 load() 吗?
通常不需要。继承 BaseLoader 后,只要实现 lazy_load(),load() 可以基于懒加载结果得到文档列表。更推荐先实现 lazy_load()。
# 为什么不直接写一个函数返回 Document 列表?
简单脚本可以这样做,但自定义 Loader 更容易复用,也更符合 LangChain 的组件接口。后续接入批处理、异步、目录加载、统一管道时会更方便。
# 每一行都变成 Document 会不会太碎?
可能会。示例只是说明如何实现 Loader。真实业务中要根据语义决定粒度,比如一条工单、一个 FAQ、一个接口说明、一个知识条目,而不一定是一行。
# 面试题
# 自定义 Loader 的核心步骤是什么?
继承 BaseLoader,实现 lazy_load(),在方法中读取业务数据,并通过 yield Document(page_content=..., metadata=...) 输出标准 Document。
# 自定义 Loader 和 TextSplitter 的边界是什么?
Loader 负责读取并生成原始 Document;TextSplitter 负责把长 Document 切分成 chunk。Loader 不应该承担复杂切分职责。
# 如何设计自定义 Loader 的 metadata?
至少包含 source、业务主键、更新时间。涉及权限时增加 tenant_id、acl、department 等字段;涉及分页文档时增加 page、line_number 或 section。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 数据重复入库 | 没有稳定业务主键 | 使用 record_id、doc_id 或 hash |
| 无法删除旧数据 | chunk_id 不稳定 | 设计 doc_id + chunk 序号 |
| 读取接口超时 | 一次拉取数据太多 | 分页读取,加入重试和超时 |
| 内存占用过高 | 一次性返回全量列表 | 使用 lazy_load() |
| 权限过滤失效 | metadata 没有权限字段 | 在 Loader 中写入 tenant_id、acl |
| 内容质量差 | 原始字段拼接混乱 | 统一 page_content 模板并抽样检查 |