# 语义文档分割器与其他文档分割器的使用
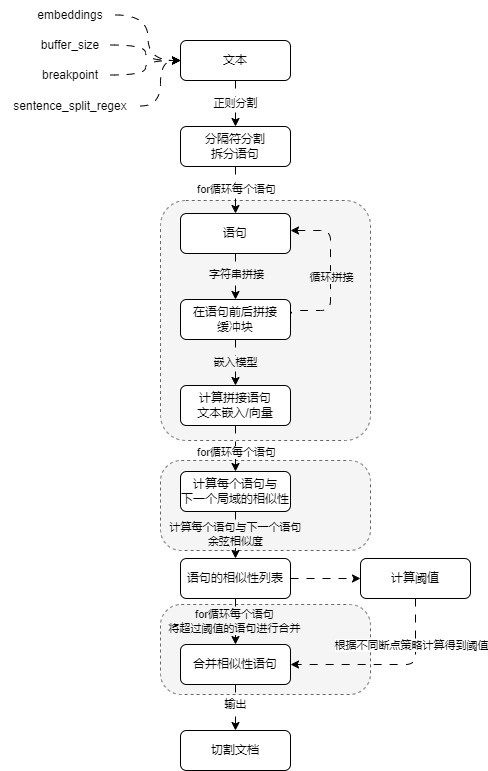
RAG 中的分割器并不只有按字符、换行、标点递归拆分这一类。前面的字符分割器主要依赖固定分隔符切分文本,这种模式会尽量避免在段落、句子、标点边界上生硬切断,但它仍然没有真正判断句子之间的语义相关性。
如果有一篇很长的文本,希望把它切成语义相关的块,让每个块内部主题更集中,后续检索和生成也更容易对齐上下文,就可以考虑语义相似度分割器。除此之外,LangChain 还提供了 HTML 标题分割器、Markdown 标题分割器、递归 JSON 分割器,以及基于 token 计数的分割方式。这些分割器不是互相替代的关系,而是分别适合不同数据结构。
这篇文章会覆盖:
- 语义文档分割器
SemanticChunker的使用背景、参数和运行机制。 - 基于自然语言处理的其他语义类分割器。
- HTML / Markdown 标题与段落分割器。
- 递归 JSON 分割器
RecursiveJsonSplitter。 - 基于 token 计数的分割器配置。
- 最新版 LangChain 中这些组件是否仍建议这样使用。
- 常见问题、面试题和生产问题排查。
# 01. 语义文档分割器的使用背景
常规文本分割器通常使用特定字符对文本进行拆分。例如:
- 先按空行切。
- 再按换行切。
- 再按中文句号、问号、感叹号切。
- 再按英文句号、问号、感叹号切。
- 再按逗号、空格等更细粒度的分隔符切。
这种方式的优点是简单、稳定、速度快,也容易预测每个 chunk 的大小。但它有一个天然问题:分隔符只能说明文本表面结构,不能说明两句话的语义距离。
比如一段文章前半部分在讲“向量数据库”,后半部分突然转到“Prompt 模板”,如果中间没有明显的段落分隔符,字符分割器可能会把两个主题切进同一个 chunk。反过来,如果一个主题跨越多个短段落,普通分割器也可能把本来应该放在一起的内容拆开。
语义分割器要解决的就是这个问题:它不只看字符边界,还会计算句子之间的向量相似度。当相邻句子的语义距离明显变大时,就把这个位置视为更适合切分的断点。
# 02. SemanticChunker 的安装与定位
SemanticChunker 当前位于 langchain_experimental 包中,使用前需要额外安装:
pip install -Uqq langchain_experimental
它和常见的 TextSplitter 有一些差异:SemanticChunker 并没有继承 TextSplitter,底层不是简单按长度递归拆分,而是先对文本做句子切分,再使用 Embedding 模型计算句子之间的语义距离,最后根据阈值策略生成 chunk。
也就是说,它更像一个“基于 Embedding 的语义断点检测器”。普通分割器的成本主要是 CPU 文本处理,语义分割器还会额外调用 Embedding,所以速度、费用、稳定性都要单独评估。
# 03. SemanticChunker 参数说明
SemanticChunker 的核心参数如下。
| 参数 | 含义 |
|---|---|
embeddings | 文本嵌入模型。底层会使用向量的余弦相似度识别语句之间的相似性。 |
buffer_size | 文本缓冲区大小,默认是 1。计算相似度时,会把当前句子前后一定数量的句子拼接进来,避免只看单句导致上下文过短。 |
add_start_index | 是否在元数据中添加起始索引,默认是 False。需要定位原文位置时建议打开。 |
breakpoint_threshold_type | 断点阈值类型,默认是 percentile,也就是百分位。 |
breakpoint_threshold_amount | 断点阈值数值或得分,用来控制切分敏感度。 |
number_of_chunks | 期望切分后的文档块个数,默认是 None。 |
sentence_split_regex | 句子切分正则,默认是 (?<=[.?!])\s+,也就是按英文句号、问号、感叹号后的空格切分。中文文本通常需要自己传入中文标点规则。 |
这里有几个参数很容易踩坑:
sentence_split_regex默认更适合英文。如果处理中文文本,却不配置中文句号、问号、感叹号,句子切分效果会很差。number_of_chunks不是绝对保证每个 chunk 都均匀,只是告诉分割器希望大致切成多少块。breakpoint_threshold_type和breakpoint_threshold_amount会直接影响断点数量。阈值过低,chunk 会非常碎;阈值过高,又可能切不出足够断点。buffer_size太小可能只看局部句子,太大又会让语义变化被抹平,需要结合文本长度调试。
# 04. SemanticChunker 使用示例
下面示例把 科幻短篇.txt 按语义切成大约 10 个文档块。
import dotenv
from langchain_community.document_loaders import UnstructuredFileLoader
from langchain_experimental.text_splitter import SemanticChunker
from langchain_openai import OpenAIEmbeddings

dotenv.load_dotenv()

# 1. 构建加载器和文本分割器
loader = UnstructuredFileLoader("./科幻短篇.txt")
text_splitter = SemanticChunker(
    embeddings=OpenAIEmbeddings(model="text-embedding-3-small"),
    number_of_chunks=10,
    add_start_index=True,
    sentence_split_regex=r"(?<=[。?!.?!])"
)

# 2. 加载文本并分割
documents = loader.load()
chunks = text_splitter.split_documents(documents)

# 3. 循环打印
for chunk in chunks:
    print(f"块大小: {len(chunk.page_content)}, 元数据: {chunk.metadata}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
示例输出类似如下:
块大小: 201, 元数据: {'source': './科幻短篇.txt'}
块大小: 25, 元数据: {'source': './科幻短篇.txt'}
块大小: 31, 元数据: {'source': './科幻短篇.txt'}
块大小: 46, 元数据: {'source': './科幻短篇.txt'}
块大小: 203, 元数据: {'source': './科幻短篇.txt'}
块大小: 19, 元数据: {'source': './科幻短篇.txt'}
块大小: 91, 元数据: {'source': './科幻短篇.txt'}
块大小: 466, 元数据: {'source': './科幻短篇.txt'}
块大小: 116, 元数据: {'source': './科幻短篇.txt'}
块大小: 0, 元数据: {'source': './科幻短篇.txt'}
2
3
4
5
6
7
8
9
10
这个输出能看到两件事:
- 分割结果并不会像固定长度切分那样每块大小相近,因为它优先考虑语义断点。
- 可能出现非常短的块,甚至极端情况下出现空块,所以生产环境不能只写完代码就直接入库,必须抽样检查分割结果。
# 05. SemanticChunker 的运行机制
SemanticChunker 的核心思路并不复杂,可以拆成几个步骤:
- 先根据
sentence_split_regex把原始文本拆成独立句子。 - 根据
buffer_size把每个句子和前后句子拼接成更完整的上下文片段。 - 使用传入的
embeddings计算这些片段的向量。 - 计算相邻片段之间的语义距离。
- 根据断点阈值策略得到一个阈值。
- 把语义距离超过阈值的位置视为断点。
- 根据断点把原始句子合并为 chunk。
它本质上不是在问“这一段够不够长”,而是在问“这里的主题是不是发生了明显变化”。这就是语义分割器和字符分割器最大的区别。
目前 SemanticChunker 底层检测相似度阈值的方法主要有 4 种:
| 阈值类型 | 说明 |
|---|---|
percentile | 百分位数,默认策略。把语义距离按分布排序后,取指定百分位作为断点阈值。 |
standard_deviation | 标准差。把明显高于平均距离的点识别为断点。 |
interquartile | 四分位数。使用四分位区间识别异常语义距离。 |
gradient | 梯度。根据语义距离变化趋势寻找断点。 |
在调参时,可以先用默认 percentile 跑一版,再观察每个 chunk 的大小和内容主题。如果 chunk 太碎,可以提高阈值或降低目标块数量;如果 chunk 太大,可以降低阈值或增加目标块数量。
# 06. 其他基于自然语言处理的分割器
除了 SemanticChunker 这种基于 Embedding 的语义分割器,LangChain 还提供了一些基于自然语言处理工具的分割器。
| 分割器 | 说明 |
|---|---|
NLTKTextSplitter | NLTK 是一套用于英文符号和统计自然语言处理的 Python 库与程序集合,可用于更符合语言边界的文本切分。 |
SpacyTextSplitter | spaCy 是用于高级自然语言处理的开源库,使用 Python 和 Cython 编写,适合依赖 NLP 句法能力的切分场景。 |
SentenceTransformersTokenTextSplitter | 用于 sentence-transformers 模型的文本拆分器,默认会把文本拆成适合句子转换模型 token 窗口的块。 |
这些分割器的使用频率通常不如 RecursiveCharacterTextSplitter,但在特定场景下很有价值。例如英文长文、句法边界要求高的文本、或者和 sentence-transformers 模型配套的本地向量化流程。
# 07. 其他文档分割器的使用场景
LangChain 还封装了一些适合特殊数据结构的分割器,常见包括:
- 基于 HTML 标题或段落的分割器。
- Markdown 标题分割器。
- 递归 JSON 分割器。
- 基于 token 计数的分割器。
这些分割器的共同特点是:它们不是只把文本当成纯字符串,而是尽量利用原始文档结构。对于 RAG 来说,结构信息非常重要,因为检索结果不仅要包含正文,还要尽量保留“这段内容属于哪个标题、哪个接口、哪个配置块、哪个章节”这样的上下文。
# 08. HTML 标题与段落分割器
LangChain 针对 HTML 类型文档提供了两个常见分割器:HTMLHeaderTextSplitter 和 HTMLSectionSplitter。
| 分割器 | 作用 |
|---|---|
HTMLHeaderTextSplitter | 按 HTML 元素级别进行分割,查找每块文本内容及其所有关联标题,并把相关标题写入元数据。它会按顺序向上逐层查找,直到找到所有嵌套层级标题。 |
HTMLSectionSplitter | 按 HTML 元素级别进行分割,查找每块文本内容及其副标题。它通常会向上查找最近的副标题,找到后停止。 |
这里要注意一个理解点:标题层级不一定等于真实 HTML DOM 的嵌套层级。更准确地说,它看的是文档目录和标题导航关系。某块内容出现在某个 h1、h2、h3 之后,就可以被视为属于这些标题上下文。
这类分割器的价值在于:把标题层级放进 metadata。当检索结果返回给 LLM 时,不仅有正文,还能知道正文属于哪个一级标题、二级标题和三级标题。对技术文档、帮助中心、API 文档、产品说明页尤其有用。
# 09. HTMLHeaderTextSplitter 使用示例
下面示例使用 HTMLHeaderTextSplitter 对一段 HTML 字符串进行切分。
from langchain_text_splitters import HTMLHeaderTextSplitter

# 1. 构建文本与分割标题
html_string = """
<!DOCTYPE html>
<html>
<body>
    <div>
        <h1>标题1</h1>
        <p>关于标题1的一些介绍文本。</p>
        <div>
            <h2>子标题1</h2>
            <p>关于子标题1的一些介绍文本。</p>
            <h3>子子标题1</h3>
            <p>关于子子标题1的一些文本。</p>
            <h3>子子标题2</h3>
            <p>关于子子标题2的一些文本。</p>
        </div>
        <div>
            <h3>子标题2</h2>
            <p>关于子标题2的一些文本。</p>
        </div>
        <br>
        <p>关于标题1的一些结束文本。</p>
    </div>
</body>
</html>
"""
headers_to_split_on = [
    ("h1", "一级标题"),
    ("h2", "二级标题"),
    ("h3", "三级标题"),
]

# 2. 创建分割器并分割
text_splitter = HTMLHeaderTextSplitter(headers_to_split_on)
chunks = text_splitter.split_text(html_string)

# 3. 输出分割内容
for chunk in chunks:
    print(chunk)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
输出内容类似如下:
Document(page_content='标题1')
Document(metadata={'一级标题': '标题1'}, page_content='关于标题1的一些介绍文本。\n子标题1 子子标题1 子子标题2')
Document(metadata={'一级标题': '标题1', '二级标题': '子标题1'}, page_content='关于子标题1的一些介绍文本。')
Document(metadata={'一级标题': '标题1', '二级标题': '子标题1', '三级标题': '子子标题1'}, page_content='关于子子标题1的一些文本。')
Document(metadata={'一级标题': '标题1', '二级标题': '子标题1', '三级标题': '子子标题2'}, page_content='关于子子标题2的一些文本。')
Document(metadata={'一级标题': '标题1'}, page_content='子标题2')
Document(metadata={'一级标题': '标题1', '三级标题': '子标题2'}, page_content='关于子标题2的一些文本。')
Document(metadata={'一级标题': '标题1'}, page_content='关于标题1的一些结束文本。')
2
3
4
5
6
7
8
从输出可以看出,正文被拆成多个 Document,并且标题信息被写到了 metadata 中。例如“关于子子标题1的一些文本。”对应的元数据同时包含一级标题、二级标题和三级标题。后续把这些数据写入向量库时,可以把标题元数据一起保存,检索后再拼回 Prompt。
另一个细节是示例 HTML 中有一个不规范标签:<h3>子标题2</h2>。真实生产数据里这种不规范 HTML 很常见,所以处理网页内容时,要关注解析器对坏 HTML 的容错效果。
# 10. MarkdownHeaderTextSplitter
除了 HTML 类型的文档,Markdown 文件也有类似的标题层级结构,可以使用 MarkdownHeaderTextSplitter。它通常适合:
- 技术文档。
- README。
- 产品说明。
- API 使用手册。
- 内部知识库的 Markdown 文档。
例如可以按 #、##、### 标题拆分,并把标题层级写入 metadata。这样检索到某个函数说明时,不会只拿到孤立的一小段文字,还能知道它属于哪个模块、哪个功能标题。
在实际 RAG 中,Markdown 标题分割通常不会单独结束整个流程。更常见的做法是:
- 先按 Markdown 标题拆出结构化大块。
- 再对过长的大块使用
RecursiveCharacterTextSplitter二次切分。 - 把标题 metadata 保留下来。
- 向量入库时保存正文和 metadata。
这样既保留结构,又避免单个 chunk 过长。
# 11. 递归 JSON 分割器
对于 JSON 类型数据,LangChain 封装了 RecursiveJsonSplitter。它会按照深度优先的方式遍历 JSON 数据,并构建较小的 JSON 块,同时尽可能保持嵌套 JSON 对象完整。
它适合处理:
- OpenAPI schema。
- 接口文档 JSON。
- 配置文件。
- 前端国际化资源。
- 嵌套业务规则。
- 复杂字段字典。
和纯文本不同,JSON 的 key-value 关系非常重要。直接按字符切分很容易把 key 和 value 拆散,导致检索结果缺少结构上下文。RecursiveJsonSplitter 的目标就是尽量保留 JSON 结构。
它的参数很简单,主要是:
| 参数 | 含义 |
|---|---|
max_chunk_size | 单个 JSON chunk 的最大大小。 |
min_chunk_size | 可选参数,控制尽量不要切出过小 chunk。 |
需要注意的是,如果 JSON 中某个 value 本身就是一个特别长的字符串,RecursiveJsonSplitter 不一定会继续切这个字符串。此时可以配合 RecursiveCharacterTextSplitter 做二次切分,降低单条数据超过预设大小的风险。
# 12. RecursiveJsonSplitter 使用示例
下面示例读取 LangSmith 的 OpenAPI JSON,并对其进行递归拆分。
import json

import requests
from langchain_text_splitters import RecursiveJsonSplitter

# 1. 获取并加载 json
url = "https://api.smith.langchain.com/openapi.json"
json_data = requests.get(url).json()
print(len(json.dumps(json_data)))

# 2. 递归 JSON 分割器
text_splitter = RecursiveJsonSplitter(max_chunk_size=300)

# 3. 分割 json 数据并创建文档
json_chunks = text_splitter.split_json(json_data)
chunks = text_splitter.create_documents(json_chunks)

# 4. 输出内容
count = 0
for chunk in chunks:
    count += len(chunk.page_content)

print(count)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
如果打印前几个文档,输出会类似:
page_content='{"openapi": "3.1.0", "info": {"title": "LangSmith", "version": "0.1.0"}, "paths": {"/api/v1/sessions/{session_id}": {"get": {"tags": ["tracer-sessions"], "summary": "Read Tracer Session", "description": "Get a specific session."}}}}'
page_content='{"paths": {"/api/v1/sessions/{session_id}": {"get": {"operationId": "read_tracer_session_api_v1_sessions__session_id__get", "security": [{"API Key": []}, {"Tenant ID": []}, {"Bearer Auth": []}]}}}}'
page_content='{"paths": {"/api/v1/sessions/{session_id}": {"get": {"parameters": [{"name": "session_id", "in": "path", "required": true, "schema": {"type": "string", "format": "uuid", "title": "Session Id"}}, {"name": "include_stats", "in": "query", "required": false, "schema": {"type": "boolean", "default": false, "title": "Include Stats"}}, {"name": "accept", "in": "header", "required": false, "schema": {"anyOf": [{"type": "string"}, {"type": "null"}], "title": "Accept"}}]}}}}'
2
3
RecursiveJsonSplitter 的运行流程可以理解为:
- 从 JSON 根节点开始。
- 按深度优先方式一层一层向下读取。
- 尝试把当前结构合并成一个新 JSON 块。
- 如果合并后的块大小接近或超过限制,就停止继续合并,生成一个 chunk。
- 对剩余结构继续递归处理。
极端情况下,它生成的 chunk 仍然可能超过预设大小。例如某个 key 很长,或者某个 value 是一段特别长的字符串,单条数据本身就超过了 max_chunk_size。所以 JSON 切分并不是“设置了大小就绝对不会超过”,生产中仍要做分块长度检查。
# 13. 基于 token 的分割器
大语言模型上下文长度是按 token 计算的,而不是按字符长度计算的。中文、英文、数字、符号的 token 比例都不一样,所以只用 len() 统计字符数,并不能精确反映模型真实消耗。
在 OpenAI 相关模型中,可以使用 tiktoken 大致计算文本的 token 数。先安装:
pip install -U tiktoken
然后定义一个基于 tiktoken 的长度计算函数:
import tiktoken


def calculate_token_count(query: str) -> int:
    """计算传入文本的 token 数"""
    encoding = tiktoken.encoding_for_model("text-embedding-3-large")
    return len(encoding.encode(query))
2
3
4
5
6
7
接下来把这个函数传给分割器的 length_function,让分割器按 token 数控制 chunk 大小。
import tiktoken
from langchain_community.document_loaders import UnstructuredFileLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter


def calculate_token_count(query: str) -> int:
    """计算传入文本的 token 数"""
    encoding = tiktoken.encoding_for_model("text-embedding-3-large")
    return len(encoding.encode(query))


# 1. 定义加载器和文本分割器
loader = UnstructuredFileLoader("./科幻短篇.txt")
text_splitter = RecursiveCharacterTextSplitter(
    separators=[
        "\n\n",
        "\n",
        "。|!|?",
        "\.\s|\!\s|\?\s",  # 英文标点符号后面通常需要加空格
        ";|;\s",
        ",|,\s",
        " ",
        ""
    ],
    is_separator_regex=True,
    chunk_size=500,
    chunk_overlap=50,
    length_function=calculate_token_count,
)

# 2. 加载文档并执行分割
documents = loader.load()
chunks = text_splitter.split_documents(documents)

# 3. 循环打印分块内容
for chunk in chunks:
    print(f"块大小: {len(chunk.page_content)}, 元数据: {chunk.metadata}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
示例输出类似:
块大小: 334, 元数据: {'source': './科幻短篇.txt'}
块大小: 409, 元数据: {'source': './科幻短篇.txt'}
块大小: 372, 元数据: {'source': './科幻短篇.txt'}
块大小: 95, 元数据: {'source': './科幻短篇.txt'}
2
3
4
这里打印的“块大小”仍然是字符长度,因为示例中打印的是 len(chunk.page_content)。但分割器内部判断 chunk_size=500 时,使用的是 calculate_token_count 这个 token 长度函数。
# 14. from_tiktoken_encoder 快速写法
除了手动传入 length_function,也可以直接使用分割器的类方法 from_tiktoken_encoder() 创建基于 tiktoken 的文本分割器。只要确保分词器使用的模型和实际 LLM 或 Embedding 模型保持一致即可。
from langchain_text_splitters import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    model_name="gpt-4",
    chunk_size=500,
    chunk_overlap=50,
    separators=[
        "\n\n",
        "\n",
        "。|!|?",
        "\.\s|\!\s|\?\s",  # 英文标点符号后面通常需要加空格
        ";|;\s",
        ",|,\s",
        " ",
        ""
    ],
    is_separator_regex=True,
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
这个写法更短,也更适合不想自己维护 token 计数函数的情况。不过生产环境仍建议明确记录使用的 model_name,否则后续模型切换时,chunk 大小可能和预期不一致。
# 最新版 LangChain 用法提示
在新版 LangChain 体系里,文本分割器通常从 langchain_text_splitters 导入,例如:
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_text_splitters import HTMLHeaderTextSplitter
from langchain_text_splitters import RecursiveJsonSplitter
2
3
SemanticChunker 仍然属于 experimental 方向,通常从 langchain_experimental.text_splitter 导入:
from langchain_experimental.text_splitter import SemanticChunker
因此建议这样取舍:
| 场景 | 建议 |
|---|---|
| 普通文本、Markdown 正文、段落型文档 | 优先使用 RecursiveCharacterTextSplitter。 |
| 主题变化明显、长文内容语义跳转多 | 可以评估 SemanticChunker,但要关注 Embedding 成本和切分稳定性。 |
| HTML 页面 | 优先使用 HTMLHeaderTextSplitter 或 HTMLSectionSplitter,保留标题 metadata。 |
| Markdown 文档 | 先用 MarkdownHeaderTextSplitter 保留标题结构,再视长度二次切分。 |
| JSON / OpenAPI schema | 使用 RecursiveJsonSplitter,必要时再二次切分长字符串。 |
| 上下文窗口敏感 | 使用 length_function 或 from_tiktoken_encoder() 按 token 控制长度。 |
最新版并不意味着所有场景都要用语义分割。SemanticChunker 的成本更高、依赖 Embedding 模型、结果也更依赖阈值。通用 RAG 里,RecursiveCharacterTextSplitter + 合理 separators + chunk_overlap + metadata 仍然是最稳的起点。
# 拓展
选择分割器时可以按“数据结构”而不是按“组件名”思考。
| 数据类型 | 更合适的处理方式 |
|---|---|
| 小说、文章、FAQ | 递归字符分割器,必要时评估语义分割器。 |
| 技术文档 | 标题分割保留结构,再递归切过长内容。 |
| HTML 页面 | HTML 标题或段落分割器。 |
| Markdown 文件 | Markdown 标题分割器。 |
| OpenAPI / JSON 配置 | 递归 JSON 分割器。 |
| 代码 | 使用按语言规则的分割器,尽量保留函数、类和注释上下文。 |
| 模型上下文敏感场景 | 按 token 长度切分。 |
在完整 RAG 链路中,分割器只是其中一步。真正影响效果的还有:
- Loader 是否正确解析出正文。
- metadata 是否保留来源、标题、页码、行号、路径等信息。
- chunk 是否过大或过小。
- overlap 是否造成太多重复。
- Embedding 模型是否适合当前语言和领域。
- 检索器是否支持 metadata filter。
- Prompt 是否正确使用检索结果。
一个可落地的处理流程通常是:
- 先按文档类型选择 Loader。
- 结构化文档先保留标题、页码、路径等 metadata。
- 再按结构或递归规则分割正文。
- 对特殊格式使用专用分割器。
- 抽样检查 chunk 内容和长度。
- 写入向量库。
- 用真实问题评估召回质量。
# 常见问题
# 语义分割一定比字符分割好吗?
不一定。语义分割会额外消耗 Embedding,速度更慢、成本更高,也更依赖阈值和模型效果。普通知识库通常先用递归字符分割器就能得到稳定结果,只有在主题跳转明显、段落结构混乱、传统切分效果不佳时,再评估语义分割。
# 为什么 SemanticChunker 会切出很短的块?
因为它看的是语义断点,不是固定长度。如果某些句子和前后句子语义距离很大,就可能被单独切出来。可以通过调整 number_of_chunks、breakpoint_threshold_type、breakpoint_threshold_amount、buffer_size 来控制。
# 中文文本为什么要改 sentence_split_regex?
默认正则 (?<=[.?!])\s+ 偏英文,它依赖英文标点后的空格。中文句子通常使用 。?!,而且标点后不一定有空格,所以需要配置类似 r"(?<=[。?!.?!])" 的规则。
# HTMLHeaderTextSplitter 的 metadata 有什么用?
metadata 能保存标题层级。检索时拿到正文后,可以同时知道该正文属于哪个标题范围,生成回答时上下文更完整,也便于做来源展示和过滤。
# RecursiveJsonSplitter 为什么还可能超出 max_chunk_size?
因为 JSON 中可能存在单个特别长的 key 或 value。分割器会尽量保持 JSON 对象完整,但无法把一个天然超长的字段自动拆成多个语义完整的小字段。此时要结合递归字符分割器二次处理。
# token 分割和字符分割的区别是什么?
字符分割按 len() 之类的字符长度判断,token 分割按模型分词后的 token 数判断。模型上下文窗口按 token 计算,所以 token 分割更接近真实限制。
# 面试题
# 1. SemanticChunker 的核心工作流程是什么?
先把文本拆成句子,再根据 buffer_size 拼接上下文片段,然后调用 Embedding 模型生成向量,计算相邻片段的语义距离,最后根据阈值策略寻找断点并合并成 chunk。
# 2. SemanticChunker 和 RecursiveCharacterTextSplitter 的区别是什么?
RecursiveCharacterTextSplitter 主要按分隔符和长度递归切分,速度快、稳定、成本低。SemanticChunker 根据 Embedding 相似度寻找语义断点,能更好处理主题变化,但成本更高,也需要调参和抽样验证。
# 3. breakpoint_threshold_type 有哪些常见类型?
常见有 percentile、standard_deviation、interquartile、gradient。它们都是用不同统计方式判断哪些语义距离可以被视为断点。
# 4. HTMLHeaderTextSplitter 适合什么场景?
适合 HTML 页面、帮助中心、技术文档、产品说明页等有明显标题层级的内容。它能把标题上下文写入 metadata,提高检索结果的可解释性。
# 5. RecursiveJsonSplitter 为什么适合 OpenAPI schema?
OpenAPI schema 是结构化 JSON,包含嵌套路径、参数、请求体、响应体等信息。递归 JSON 分割器可以尽量保留嵌套结构,避免 key-value 被普通字符切分打散。
# 6. 为什么 RAG 中经常需要按 token 控制 chunk_size?
因为 LLM 的上下文窗口、Embedding 输入限制、Prompt 拼接成本都按 token 计算。按字符控制可能导致实际 token 超限,尤其在中英文混合、代码、符号较多的文本中更明显。
# 7. 分割器参数如何影响召回?
chunk 太大时,一个块里会混入多个主题,召回噪声变多;chunk 太小时,上下文不足,LLM 难以回答完整问题。overlap 太小可能丢上下文,overlap 太大则会增加重复召回和向量库成本。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 语义分割很慢 | 每次分割都要调用 Embedding | 离线批处理、缓存 Embedding、减少重跑、必要时改用递归字符分割。 |
| Embedding 费用突然升高 | 文档重复处理、chunk 数过多、语义分割重跑 | 做文件 hash、版本号、缓存表和处理状态表。 |
| 中文长文只切出很少块 | 使用了偏英文的 sentence_split_regex | 增加中文标点规则,例如 r"(?<=[。?!.?!])"。 |
| chunk 特别碎 | 阈值太敏感、目标块数量过多 | 调整 number_of_chunks 或断点阈值参数。 |
| chunk 过大 | 阈值太保守、句子切分失败 | 检查正则,降低阈值,或二次使用递归字符分割。 |
| HTML 检索结果没有标题上下文 | 直接抽正文后按字符切分 | 先用 HTML 标题分割器保存 metadata。 |
| JSON 检索结果结构断裂 | 普通字符切分破坏 key-value | 使用 RecursiveJsonSplitter。 |
| JSON chunk 仍然超限 | 单个 key 或 value 本身很长 | 对长字符串字段进行二次切分。 |
| token 超过模型限制 | 用字符数估算 chunk 大小 | 使用 length_function 或 from_tiktoken_encoder()。 |
| 检索命中但回答不准 | chunk 缺少标题、路径、页码等上下文 | 保存并在 Prompt 中拼接 metadata。 |
这几类分割器的选择原则可以压缩成一句话:普通文本先求稳定,结构化文档先保结构,模型上下文敏感时按 token,只有当主题边界确实影响召回质量时,再引入语义分割。