# LangChain Runnable 重试与回退机制:with_retry、with_fallbacks 与生产级容错
LLM 应用的错误和普通后端接口不太一样。
普通接口常见的是数据库连接失败、网络超时、参数校验失败。LLM 链路除了这些,还会遇到模型供应商限流、临时 5xx、上下文超长、输出格式不稳定、工具调用失败、JSON 解析失败、检索服务抖动、模型安全策略拒答等问题。
如果所有异常都直接抛给用户,体验会很差;如果所有异常都无脑重试,成本和延迟又会失控。生产级 LLM 应用需要一套清晰的容错策略:
- 临时性错误:可以重试。
- 不可恢复错误:不要重试。
- 主链失败:可以回退到备用链。
- 能力降级:要明确告诉系统后续如何处理。
- 所有容错行为:必须能被观测和统计。
LangChain Runnable 提供了两个核心方法:
with_retry():原 Runnable 失败后,对同一个 Runnable 再试几次。with_fallbacks():原 Runnable 失败后,按顺序尝试备用 Runnable。
它们不是简单的“报错再跑一次”,而是生产稳定性设计里的两个不同层次。
# retry 和 fallback 的区别
先把概念分清楚。
retry 是同一个动作失败后再做一次。比如 OpenAI 临时 429,等一小段时间再请求同一个模型。
fallback 是当前动作失败后换一个备选动作。比如 OpenAI 连续失败后切到备用模型,或者结构化输出解析失败后切到一个更保守的修复链。
| 机制 | 做什么 | 典型场景 |
|---|---|---|
with_retry() | 同一个 Runnable 失败后重新执行 | 网络抖动、429、临时 5xx、偶发解析失败 |
with_fallbacks() | 当前 Runnable 失败后换备用 Runnable | 主模型不可用、供应商故障、强模型失败后降级、解析链失败后修复 |
两者可以组合,但顺序要想清楚。通常建议:
- 对主 Runnable 做少量重试。
- 主 Runnable 重试后仍失败,再进入 fallback。
- fallback 自己也可以有独立的重试策略。
不要把所有问题都交给重试。重试解决的是“短暂抖动”,不是“设计错误”。
# with_retry 的基本写法
with_retry() 会返回一个新的 Runnable。这个新 Runnable 包着原始 Runnable,执行失败时按策略重新调用。
from langchain_core.runnables import RunnableLambda


attempt = 0


def unstable_divide(x: int) -> float:
    global attempt
    attempt += 1

    if attempt < 2:
        raise ValueError("temporary failure")

    return 10 / x


chain = RunnableLambda(unstable_divide).with_retry(
    retry_if_exception_type=(ValueError,),
    stop_after_attempt=2,
    wait_exponential_jitter=True,
)

result = chain.invoke(2)
print(result)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
当前 LangChain 中,with_retry() 的核心参数是:
| 参数 | 作用 |
|---|---|
retry_if_exception_type | 哪些异常类型可以重试,默认是 (Exception,) |
wait_exponential_jitter | 是否在重试间隔里加入指数退避和随机抖动,默认是 True |
exponential_jitter_params | 调整指数退避参数,例如 initial、max、exp_base、jitter |
stop_after_attempt | 最多尝试次数,默认是 3 |
生产里最重要的是第一个参数:不是所有异常都应该重试。
# with_retry 的内部流程
with_retry() 的运行逻辑可以理解为:生成一个新的 RetryRunnable,里面保存原始 Runnable、异常类型、等待策略和最大尝试次数。调用时循环执行原始 Runnable,成功就返回,失败且异常可重试就等待后继续,直到达到最大次数。
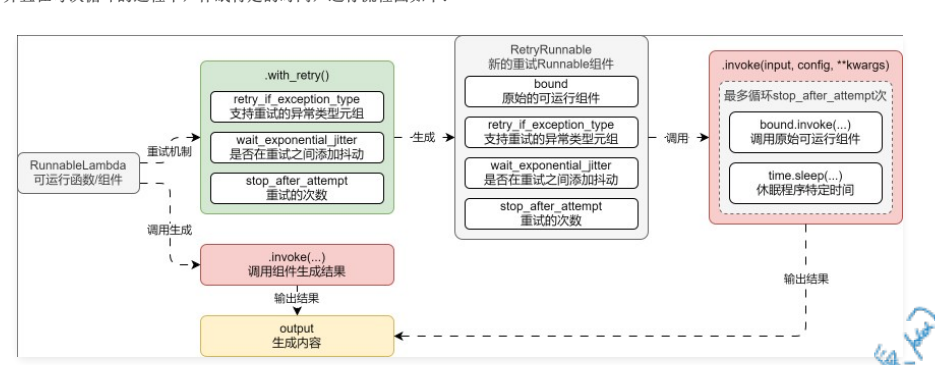
这个流程有几个关键点:
- 它不会修改原始 Runnable,而是返回一个包装后的新 Runnable。
- 它只会处理
retry_if_exception_type中声明的异常。 - 达到
stop_after_attempt后仍失败,会继续抛出最后一次异常。 - 重试间隔建议开启 jitter,避免大量请求同时重试造成流量尖峰。
这和普通后端里的重试中间件思路一致,但在 LLM 应用里还要额外考虑 token 成本和用户等待时间。
# 哪些异常应该重试
适合重试的错误通常有一个共同点:它们是临时性的。
可以考虑重试:
- 网络超时。
- 连接重置。
- 供应商临时 5xx。
- 供应商 429 限流。
- 临时网关错误。
- 偶发 JSON 解析失败。
- 偶发工具调用响应不完整。
不应该重试:
- 参数校验失败。
- API key 错误。
- 权限不足。
- 余额不足。
- 模型名不存在。
- prompt 变量缺失。
- 上下文长度长期超限。
- 用户输入违反策略。
- 业务状态不允许执行。
重试的本质是“同样的动作再执行一次可能成功”。如果同样的输入永远不会成功,重试只是在浪费时间和钱。
# LLM 调用的重试策略
模型调用重试要克制。一个常见配置是最多尝试 2 到 3 次:
from langchain_openai import ChatOpenAI


llm = ChatOpenAI(
    model="gpt-4.1-mini",
    timeout=20,
).with_retry(
    retry_if_exception_type=(TimeoutError, ConnectionError),
    stop_after_attempt=3,
    wait_exponential_jitter=True,
)
2
3
4
5
6
7
8
9
10
11
真实项目里,供应商 SDK 可能会抛出更具体的异常类型。建议封装模型适配层,把不同供应商异常归一化成项目内部异常:
class ModelTransientError(Exception):
    pass


class ModelRateLimitError(ModelTransientError):
    pass


class ModelPermanentError(Exception):
    pass
2
3
4
5
6
7
8
9
10
然后只对临时异常重试:
safe_llm = llm.with_retry(
    retry_if_exception_type=(ModelTransientError,),
    stop_after_attempt=3,
)
2
3
4
这样可以避免把权限错误、配置错误、上下文超长这类永久错误也拿去重试。
# with_fallbacks 的基本写法
with_fallbacks() 会返回一个新的 Runnable。它先运行原始 Runnable,如果失败,就按顺序尝试 fallback 列表里的 Runnable,直到某个分支成功,或者所有分支都失败。
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_template("{query}")

primary_llm = ChatOpenAI(model="gpt-4.1-mini")
backup_llm = ChatOpenAI(model="gpt-4.1-nano")

llm = primary_llm.with_fallbacks(
    [backup_llm],
    exceptions_to_handle=(Exception,),
)

chain = prompt | llm | StrOutputParser()

answer = chain.invoke({"query": "解释一下服务熔断"})
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
当前 with_fallbacks() 的核心参数是:
| 参数 | 作用 |
|---|---|
fallbacks | 原 Runnable 失败后依次尝试的备用 Runnable 列表 |
exceptions_to_handle | 哪些异常会触发 fallback,默认是 (Exception,) |
exception_key | 是否把异常对象作为输入的一部分传给 fallback |
注意方法名是 with_fallbacks(),是复数,因为可以传多个 fallback。
# with_fallbacks 的内部流程
with_fallbacks() 的运行流程是:先执行原始 Runnable,如果出现被允许处理的异常,就按顺序执行 fallback 列表。第一个成功的 fallback 返回结果;如果都失败,就抛出最终异常。
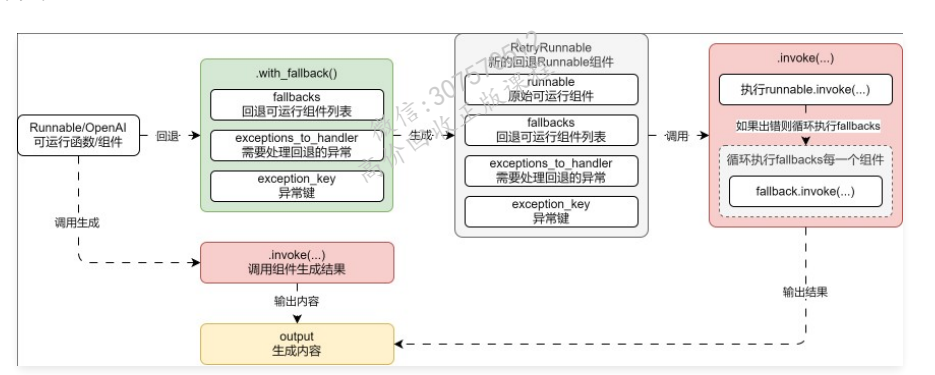
这个机制适合做“可控降级”:
- 强模型失败,降级到快模型。
- 主供应商失败,切到备用供应商。
- 严格 JSON 输出失败,切到修复链。
- 高级检索失败,切到基础检索。
- reranker 失败,跳过 rerank 直接回答。
fallback 不是为了掩盖错误,而是为了让系统有明确的备用路径。
# exception_key:把错误交给备用链
有些 fallback 需要知道原始错误是什么。比如结构化输出解析失败后,修复链需要拿到原始异常和原始内容。
exception_key 可以把异常作为输入的一部分传给 fallback:
from langchain_core.runnables import RunnableLambda


def primary(input: dict) -> str:
    raise ValueError("JSON parse failed")


def fallback(input: dict) -> str:
    error = input["error"]
    return f"fallback handled: {type(error).__name__}"


chain = RunnableLambda(primary).with_fallbacks(
    [RunnableLambda(fallback)],
    exceptions_to_handle=(ValueError,),
    exception_key="error",
)

print(chain.invoke({"query": "生成 JSON"}))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
使用 exception_key 时有一个限制:原始 Runnable 和 fallback 都必须接收字典输入。因为异常会被塞进输入字典的指定 key 里。
生产里建议把异常转换成可审计的错误摘要,不要把完整堆栈、密钥、内部请求参数写入模型 prompt 或 trace。
# retry 和 fallback 如何组合
生产里经常这样组合:
primary = ChatOpenAI(model="gpt-4.1-mini").with_retry(
    retry_if_exception_type=(TimeoutError, ConnectionError),
    stop_after_attempt=2,
)

backup = ChatOpenAI(model="gpt-4.1-nano").with_retry(
    retry_if_exception_type=(TimeoutError, ConnectionError),
    stop_after_attempt=2,
)

llm = primary.with_fallbacks(
    [backup],
    exceptions_to_handle=(TimeoutError, ConnectionError),
)
2
3
4
5
6
7
8
9
10
11
12
13
14
这个顺序表示:
- 主模型遇到临时错误时,先自己重试。
- 主模型重试后仍失败,再切到备用模型。
- 备用模型也有自己的重试策略。
不要随便写成无限套娃。每多一次重试和 fallback,都会增加延迟、成本和不确定性。
建议给每条链明确设置:
- 总超时时间。
- 最大尝试次数。
- 最大 fallback 层数。
- 是否允许降级。
- 降级后输出质量要求。
- 降级结果是否需要标记。
# 结构化输出的容错
结构化输出是 LLM 应用里最常见的失败点之一。模型返回了文本,但 parser 解析失败。
一种生产化写法是:主链要求严格 JSON,失败后进入修复链。
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableLambda
from langchain_openai import ChatOpenAI


llm = ChatOpenAI(model="gpt-4.1-mini", temperature=0)
parser = JsonOutputParser()

primary_prompt = ChatPromptTemplate.from_template(
    "请只输出 JSON:{query}"
)

repair_prompt = ChatPromptTemplate.from_template(
    "下面的输出无法解析为 JSON,请修复为合法 JSON。\n错误:{error}\n原始请求:{query}"
)

primary_chain = primary_prompt | llm | parser
repair_chain = repair_prompt | llm | parser

chain = primary_chain.with_fallbacks(
    [repair_chain],
    exceptions_to_handle=(ValueError,),
    exception_key="error",
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
这只是示意。真实项目里还要把模型原始输出传给修复链,否则修复链只能根据错误猜测。更稳的方式是把“生成”和“解析”拆开,把原始文本、错误摘要、schema 一起交给修复链。
结构化输出失败不要只依赖重试。重试可能得到另一个格式错误的结果;修复链或 schema 约束通常更有效。
# RAG 链路的 fallback
RAG 里 fallback 更像“降级策略”。
例如:
- 向量库失败时,切到关键词检索。
- reranker 失败时,跳过 reranker。
- 文档召回为空时,切到 FAQ。
- 长上下文压缩失败时,返回短答案。
示意:
retriever = vector_retriever.with_fallbacks(
    [keyword_retriever],
    exceptions_to_handle=(TimeoutError, ConnectionError),
)

rag_chain = {
    "context": retriever,
    "query": lambda x: x["query"],
} | prompt | llm | parser
2
3
4
5
6
7
8
9
但这里要特别小心权限一致性。备用检索器必须和主检索器使用同样的租户过滤、文档权限过滤和脱敏策略。否则 fallback 可能成为数据越权入口。
# 幂等性与副作用
重试最容易忽略的问题是副作用。
如果 Runnable 只是调用模型生成文本,重试通常还算安全。但如果 Runnable 会写数据库、发消息、扣费、调用外部业务接口,重试就可能造成重复执行。
危险例子:
create_order_runnable.with_retry(stop_after_attempt=3)
如果第一次其实已经创建订单,只是响应超时,第二次重试可能创建重复订单。
生产里要做到:
- 写操作必须有幂等键。
- 外部接口必须支持 request_id。
- 扣费、发券、发消息不能无脑重试。
- 重试前区分“请求未送达”和“结果未知”。
- 对副作用 Runnable 单独设计补偿机制。
LLM 链路里,工具调用尤其要注意。模型调用失败可以重试,工具写操作失败不一定能重试。
# 避免重试风暴
当供应商整体故障时,所有请求一起重试,可能把故障放大成重试风暴。
生产系统需要配合:
- 指数退避。
- jitter。
- 全局限流。
- 单租户限流。
- 熔断器。
- 请求队列。
- 降级开关。
- 供应商健康检查。
with_retry() 是局部重试工具,不是完整的稳定性平台。它应该和服务层限流、熔断、超时、监控一起使用。
# 可观测性
容错机制上线后,必须能回答这些问题:
- 每条链平均重试几次。
- 哪些异常触发最多。
- fallback 命中率是多少。
- fallback 后用户体验是否下降。
- 哪个供应商故障最多。
- 哪个 parser 最容易失败。
- 重试带来了多少额外 token 成本。
- 重试和 fallback 给 P95/P99 延迟增加了多少。
建议把容错策略写入 tags 和 metadata:
config = {
    "run_name": "support_answer_chain",
    "tags": ["support", "retry:enabled", "fallback:enabled"],
    "metadata": {
        "tenant_id": tenant_id,
        "feature": "support_answer",
        "retry_attempts": 2,
        "fallback_policy": "llm_backup_v1",
    },
}
2
3
4
5
6
7
8
9
10
同时在回调或 LangSmith trace 中观察每个步骤的错误和分支选择。没有观测的 fallback,会让线上问题变得更隐蔽。
# 问题
重试和回退最容易造成三个问题。
第一是错误被掩盖。系统看起来成功了,但其实长期在走 fallback,主链已经坏了很久。
第二是成本失控。一次用户请求可能触发多次模型调用、多个备用模型、多个修复链,最后账单比预期高很多。
第三是语义不一致。主模型和备用模型能力不同,主检索和备用检索权限不同,主 parser 和修复 parser 输出 schema 不同,都会让后续业务逻辑出问题。
所以,容错不是越多越好。每一层 retry 和 fallback 都要有明确的异常范围、次数上限、超时上限、观测指标和降级语义。
# 拓展
可以把 retry/fallback 和前面几篇 Runnable 能力组合起来:
- 和
configurable_alternatives()结合:根据策略选择主模型和备用模型。 - 和
with_config()结合:给容错链打上 trace 标签。 - 和
RunnableWithMessageHistory结合:对聊天链做模型容灾,但不要重复写入历史。 - 和 OutputParser 结合:解析失败后进入修复链。
- 和 RAG 结合:检索失败后切到备用检索策略。
也可以把容错策略抽象成工厂函数:
def with_model_resilience(primary, backup):
    primary = primary.with_retry(stop_after_attempt=2)
    backup = backup.with_retry(stop_after_attempt=2)
    return primary.with_fallbacks([backup])
2
3
4
复杂项目里,不建议每条链自己随手配置容错。应该统一成平台能力,形成标准配置和默认策略。
# 实际生产是否使用
会使用,而且非常常用。
适合生产使用的场景:
- 模型供应商临时失败。
- 网络超时。
- 限流。
- 结构化输出解析失败。
- RAG 检索服务抖动。
- 非关键 reranker 失败。
- 多供应商容灾。
但生产里不会只靠 with_retry() 和 with_fallbacks()。它们通常会和这些能力一起出现:
- 服务层超时。
- 熔断器。
- 限流器。
- 幂等键。
- 降级开关。
- 错误分类。
- trace 和指标。
- 成本监控。
把它们当成 Runnable 层的容错原语,而不是完整的稳定性方案。
# 现在是否抛弃
没有抛弃。
with_retry() 和 with_fallbacks() 仍然是当前 LangChain Runnable 体系里的正式能力。它们直接挂在 Runnable 方法上,可以作用于单个模型、单个 parser、单个 retriever,也可以作用于完整 LCEL 链。
需要变化的是使用方式:旧项目可能喜欢对所有异常直接重试或直接 fallback;新项目更强调错误分类、可观测性、幂等、安全边界和成本控制。
# 最新生产如何实现
最新生产实现建议按五层来做。
第一层,定义错误分类:
class TransientAIError(Exception):
    pass


class PermanentAIError(Exception):
    pass
2
3
4
5
6
第二层,对主组件做有限重试:
primary_llm = primary_llm.with_retry(
    retry_if_exception_type=(TransientAIError,),
    stop_after_attempt=2,
    wait_exponential_jitter=True,
)
2
3
4
5
第三层,定义备用组件:
backup_llm = backup_llm.with_retry(
    retry_if_exception_type=(TransientAIError,),
    stop_after_attempt=2,
)
2
3
4
第四层,组合 fallback:
resilient_llm = primary_llm.with_fallbacks(
    [backup_llm],
    exceptions_to_handle=(TransientAIError,),
)
2
3
4
第五层,调用时写入观测信息:
answer = chain.invoke(
    {"query": query},
    config={
        "run_name": "support_answer_chain",
        "tags": ["support", "retry", "fallback"],
        "metadata": {
            "tenant_id": tenant_id,
            "fallback_policy": "model_backup_v1",
        },
    },
)
2
3
4
5
6
7
8
9
10
11
最终原则是:能重试的只是临时错误,能 fallback 的必须是协议一致的备用组件;所有容错都要有上限、有观测、有成本意识、有幂等保护。这样 with_retry() 和 with_fallbacks() 才能真正降低线上错误率,而不是把错误换一种方式藏起来。