# LangChain 回调与可观测性实践:让链路执行过程透明可追踪
LLM 应用最难排查的问题,往往不是代码直接抛异常,而是“看起来正常运行,但回答不对”。
一次链路执行里可能发生了很多事:Prompt 被格式化,Retriever 查了文档,模型消耗了 token,OutputParser 解析了结果,Agent 调用了工具,某一步重试了,某个分支超时了,最后用户只看到一句回答。如果没有过程数据,排障就只能靠猜。
LangChain 的回调和 tracing 能解决这个透明度问题。它们让你看到链路内部发生了什么:什么时候开始,输入是什么,模型输出了什么 token,检索到了哪些文档,工具调用了几次,哪一步失败,耗时和 token 花在哪里。
不过在当前 LangChain 里,调试链路不要只停留在自定义 callback。生产里更推荐把三类能力结合起来:
RunnableConfig:给每次运行加tags、metadata、run_name。- Callback handler:在本地或服务内捕获链路事件。
- LangSmith tracing:把执行过程、输入输出、耗时、token 和错误统一记录下来。
回调适合本地调试和轻量扩展,LangSmith 更适合团队协作、线上排障、评估和长期观测。
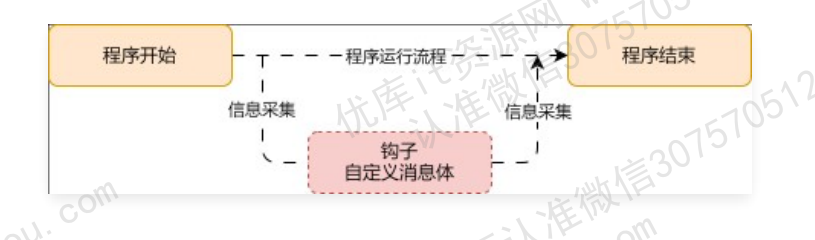
可以把 callback 理解成插在链路生命周期里的观察点:程序执行到关键阶段时,把开始、结束、token、错误、工具调用等事件交给自定义处理器。它适合做信息采集和调试,不应该承载核心业务状态变更。
# 为什么普通日志不够
很多项目一开始只会记录:
logger.info("user question: %s", question)
logger.info("model answer: %s", answer)
2
这只能看到入口和出口,看不到中间过程。
真实问题通常藏在中间:
- Prompt 变量是不是传错了。
- RAG 检索结果是不是不相关。
- 模型实际收到的 system prompt 是什么。
- 哪个 Runnable 分支最慢。
- OutputParser 是否失败后重试。
- Agent 调用了哪个工具,入参是什么。
- token 是否被长历史或长上下文吃掉。
- fallback 模型是否被触发。
- 同一用户的连续请求是否属于同一个会话。
LLM 应用的日志不能只记录最终答案。你需要能沿着一次请求从 API 层追到 Prompt、Model、Retriever、Tool、Parser 和最终响应。
# 三层可观测性
可以把 LangChain 可观测性分成三层。
第一层是本地输出:快速看链路是否按预期执行。适合开发阶段。
第二层是自定义 callback:把关键事件接入自己的日志、指标或告警。适合服务内控制。
第三层是 tracing 平台:记录完整链路树、输入输出、耗时、token、错误和评估结果。适合团队长期维护。
生产项目通常三层都需要,但重点不同:
| 场景 | 推荐方式 |
|---|---|
| 本地看 Prompt 和输出 | callback 或 astream_events |
| API 请求排障 | RunnableConfig + LangSmith |
| 记录 token 和耗时 | LangSmith 或结构化日志 |
| 对接公司日志系统 | 自定义 callback |
| Agent 工具调用分析 | LangSmith tracing |
| 实时前端展示过程 | streaming events |
| 评估 Prompt 和模型版本 | LangSmith datasets / evals |
不要把自定义 callback 写成一个万能日志系统。回调能捕获事件,但日志治理、隐私脱敏、查询分析、评估对比,仍然需要更完整的平台能力。
# RunnableConfig:先给链路命名
在写 callback 之前,先养成给链路传配置的习惯。
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个严谨的技术助手。"),
    ("human", "{question}"),
])

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
chain = prompt | model | StrOutputParser()

answer = chain.invoke(
    {"question": "如何排查 Flask 数据库连接池耗尽?"},
    config={
        "run_name": "backend_qa_chain",
        "tags": ["qa", "backend"],
        "metadata": {
            "tenant_id": "tenant_001",
            "user_id": "u_1001",
            "prompt_version": "backend-qa-2026-08-06-v1",
            "env": "dev",
        },
    },
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
run_name 让你知道这条链路是什么,tags 方便过滤,metadata 方便把一次模型调用和业务请求关联起来。
建议放进 metadata 的字段:
- environment
- request id
- tenant id
- user id
- session id / thread id
- prompt version
- model route
- experiment id
- feature name
不建议放进去的内容:
- API Key。
- 密码、token、cookie。
- 完整身份证、手机号、银行卡。
- 大段用户隐私文本。
- 内部权限策略细节。
metadata 是为了排障和聚合,不是为了把所有业务数据都复制一份。
# with_config:给链路固定默认配置
对于稳定链路,可以用 with_config 固定默认名称和标签。
qa_chain = (
    prompt
    | model
    | StrOutputParser()
).with_config({
    "run_name": "knowledge_base_qa",
    "tags": ["rag", "qa"],
})
2
3
4
5
6
7
8
每次调用再补充动态 metadata:
answer = qa_chain.invoke(
    {"question": "数据库迁移上线前要检查什么?"},
    config={
        "metadata": {
            "tenant_id": "tenant_001",
            "request_id": "req_20260806_001",
        }
    },
)
2
3
4
5
6
7
8
9
生产里链路名称要稳定。不要把用户输入、随机 ID 或时间戳拼进 run_name,否则后面在 trace 系统里很难聚合。
# 使用 LangSmith tracing
如果应用要长期维护,建议尽早接 LangSmith。
安装:
pip install -U langsmith
配置环境变量:
$env:LANGSMITH_TRACING="true"
$env:LANGSMITH_API_KEY="你的 LangSmith API Key"
$env:LANGSMITH_PROJECT="my-llm-app-dev"
2
3
macOS 或 Linux:
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY="你的 LangSmith API Key"
export LANGSMITH_PROJECT="my-llm-app-dev"
2
3
只要 LangChain 链路带着 tracing 运行,你就能在 LangSmith 里看到完整 run tree。对 Agent 来说尤其重要,因为你需要看到模型在哪一步决定调用工具、工具返回了什么、模型如何继续生成最终答案。
生产建议按环境分项目:
my-app-devmy-app-stagingmy-app-prod
也可以按业务线或租户隔离项目,但不要一开始拆得太碎。项目拆太细会影响跨功能分析,拆太粗又会增加权限和隐私风险。
# 自定义 CallbackHandler
如果你只想在本地或服务日志里看事件,可以自定义 callback。
from typing import Any
from uuid import UUID

from langchain_core.callbacks import BaseCallbackHandler
from langchain_core.outputs import LLMResult


class DebugCallbackHandler(BaseCallbackHandler):
    def on_chain_start(
        self,
        serialized: dict[str, Any],
        inputs: dict[str, Any],
        *,
        run_id: UUID,
        parent_run_id: UUID | None = None,
        **kwargs: Any,
    ) -> None:
        print(f"[chain:start] run_id={run_id} inputs={inputs}")

    def on_chain_end(
        self,
        outputs: dict[str, Any],
        *,
        run_id: UUID,
        parent_run_id: UUID | None = None,
        **kwargs: Any,
    ) -> None:
        print(f"[chain:end] run_id={run_id} outputs={outputs}")

    def on_llm_end(
        self,
        response: LLMResult,
        *,
        run_id: UUID,
        parent_run_id: UUID | None = None,
        **kwargs: Any,
    ) -> None:
        print(f"[llm:end] run_id={run_id}")

    def on_chain_error(
        self,
        error: BaseException,
        *,
        run_id: UUID,
        parent_run_id: UUID | None = None,
        **kwargs: Any,
    ) -> None:
        print(f"[chain:error] run_id={run_id} error={error}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
调用时通过 config 传入:
handler = DebugCallbackHandler()

answer = chain.invoke(
    {"question": "什么是 LangChain callback?"},
    config={
        "callbacks": [handler],
        "tags": ["debug"],
        "metadata": {
            "request_id": "req_debug_001",
        },
    },
)
2
3
4
5
6
7
8
9
10
11
12
自定义 callback 适合:
- 本地打印调试。
- 接入公司日志系统。
- 统计特定链路事件。
- 对某些错误打点。
- 在开发环境观察输入输出。
不适合:
- 在 callback 里做耗时很长的操作。
- 在 callback 里写高风险业务副作用。
- 在 callback 里抛出未处理异常影响主链路。
- 在 callback 里记录大量敏感原文。
Callback 是观测钩子,不应该变成业务流程的隐藏入口。
# 监听模型 token
流式输出时,可以通过 callback 捕获新 token。
from typing import Any
from uuid import UUID

from langchain_core.callbacks import BaseCallbackHandler


class TokenCallbackHandler(BaseCallbackHandler):
    def on_llm_new_token(
        self,
        token: str,
        *,
        run_id: UUID,
        parent_run_id: UUID | None = None,
        **kwargs: Any,
    ) -> None:
        print(token, end="", flush=True)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
调用:
handler = TokenCallbackHandler()

for chunk in chain.stream(
    {"question": "用一段话解释 RunnableConfig。"},
    config={"callbacks": [handler]},
):
    pass
2
3
4
5
6
7
实际 Web 应用里,前端通常通过 SSE 或 WebSocket 接收增量内容。不要直接把 callback 和 WebSocket 连接强绑定在一起,否则客户端断开、网络抖动和重连会让链路很难维护。更好的方式是后端定义事件协议,把模型 token、工具调用、错误和完成状态统一转换成业务事件。
# astream_events:直接消费事件流
除了 callback,Runnable 还可以使用事件流观察执行过程。
async def debug_events(chain):
    async for event in chain.astream_events(
        {"question": "LCEL 如何让链路更透明?"},
        config={
            "run_name": "debug_qa_chain",
            "tags": ["debug"],
        },
    ):
        event_name = event["event"]
        run_name = event.get("name")

        if event_name.endswith("_start"):
            print(f"[start] {run_name}")
        elif event_name.endswith("_end"):
            print(f"[end] {run_name}")
        elif event_name.endswith("_stream"):
            print(f"[stream] {run_name}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
事件流适合:
- 命令行调试。
- 前端展示 Agent 执行过程。
- 观察工具调用。
- 区分消息流、状态流和错误事件。
- 在不写 callback class 的情况下快速看链路。
对于新应用,如果目标是“把执行过程展示给用户”,事件流通常比自定义 callback 更自然;如果目标是“接入内部日志或指标”,callback 更合适;如果目标是“长期追踪和评估”,LangSmith 更合适。
# 调试 RAG 链路
RAG 问答的失败点很多。用户问一个问题,回答不对,可能是:
- 问题改写错了。
- 检索 query 不对。
- 向量库没有召回相关文档。
- 文档切分太碎或太长。
- Prompt 没有约束“只根据上下文回答”。
- 模型忽略上下文。
- OutputParser 截掉了关键信息。
所以 RAG tracing 至少要记录:
- 原始问题。
- 检索 query。
- retriever 名称。
- top k。
- 文档 ID。
- 文档标题或来源。
- 文档 score。
- 格式化后的上下文长度。
- 最终 Prompt 版本。
- 模型名、token、耗时。
示例链路:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough


def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)


rag_chain = (
    {
        "context": retriever.with_config({"run_name": "retrieve_kb_docs"}) | format_docs,
        "question": RunnablePassthrough(),
    }
    | prompt.with_config({"run_name": "build_rag_prompt"})
    | model.with_config({"run_name": "generate_answer"})
    | StrOutputParser()
).with_config({
    "run_name": "rag_qa_chain",
    "tags": ["rag", "qa"],
})
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
这样 trace 里能清楚看到检索、Prompt、模型、解析各自耗时。排查时不用在一堆日志里手动拼请求。
# 调试 Agent 工具调用
Agent 比普通 chain 更需要 tracing,因为它的执行路径不是固定的。
一次 Agent 运行可能包括:
- 模型分析用户意图。
- 决定调用工具。
- 传入工具参数。
- 工具返回结果。
- 模型根据工具结果继续推理。
- 再次调用工具。
- 最终返回答案或结构化结果。
使用 create_agent 时,建议给调用加上 tags 和 metadata:
from langchain.agents import create_agent


agent = create_agent(
    model="openai:gpt-4o-mini",
    tools=[get_order_status],
    system_prompt="你是订单客服助手。查询订单状态时必须调用工具。",
)

result = agent.invoke(
    {
        "messages": [
            {"role": "user", "content": "帮我查一下订单 A1001 的状态"}
        ]
    },
    config={
        "run_name": "order_support_agent",
        "tags": ["agent", "order-support"],
        "metadata": {
            "tenant_id": "tenant_001",
            "session_id": "session_abc",
        },
    },
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
排查 Agent 时重点看:
- 工具是否被调用。
- 工具调用参数是否正确。
- 工具返回是否符合预期。
- 模型是否正确使用工具结果。
- 是否出现无意义循环。
- 是否触发了人工确认。
- 是否把敏感工具当成普通工具直接执行。
高风险工具一定要有确认、权限、审计和幂等。Tracing 能帮你看见问题,但不能代替安全设计。
# 生产日志要脱敏
LLM trace 很容易包含敏感信息,因为 Prompt 和输出里可能有:
- 用户个人信息。
- 订单信息。
- 企业内部知识。
- API 返回数据。
- 数据库查询结果。
- 工具调用参数。
- 模型生成的推断内容。
所以生产 tracing 必须有隐私策略。
建议:
- 只记录必要字段。
- 对手机号、邮箱、证件号做脱敏。
- 对长文本做截断。
- 对高敏租户单独隔离项目或关闭原文记录。
- 对 trace 查看权限做分级。
- 对数据保留周期做限制。
- 禁止记录密钥、token、cookie。
可以在 callback 或日志层做简单脱敏:
import re


def mask_text(text: str) -> str:
    text = re.sub(r"1[3-9]\d{9}", "1**********", text)
    text = re.sub(r"[\w.-]+@[\w.-]+", "***@***", text)
    return text[:1000]
2
3
4
5
6
7
注意这只是示例。真实生产里,脱敏规则要结合业务字段、数据分类和合规要求设计,不能只靠两条正则。
# 不要让 callback 阻塞主链路
Callback 运行在链路执行过程中。如果你在 callback 里做慢操作,就会拖慢用户请求。
危险做法:
- 每个 token 都同步写数据库。
- 每个事件都请求外部 HTTP。
- 在 callback 里做复杂聚合。
- 日志服务失败后阻塞主请求。
更稳妥的做法:
- callback 只做轻量采集。
- 大量事件写入队列。
- 指标聚合异步处理。
- 日志失败不影响主链路。
- 对 callback 自身异常做保护。
Callback 是观察者,不应该成为主要瓶颈。
# 记录哪些指标
生产里至少要记录这些指标:
- request count
- success count
- error count
- latency p50 / p95 / p99
- first token latency
- prompt tokens
- completion tokens
- total tokens
- estimated cost
- parser failure rate
- retriever latency
- empty retrieval rate
- tool call count
- tool error rate
- fallback rate
- user feedback score
只看平均值不够。LLM 应用经常出现长尾延迟,p95 和 p99 更能反映用户体验。
成本也不能只看总 token。要按 feature、tenant、model、prompt version 拆开看,否则很难知道钱花在哪里。
# 排障路径
当用户反馈“回答不对”时,可以按这个顺序查:
- 找到 request id 或 session id。
- 打开对应 trace。
- 看最终输入是否和用户反馈一致。
- 看 Prompt 版本是否正确。
- 看检索结果是否相关。
- 看模型是否正确使用上下文。
- 看工具调用参数和返回结果。
- 看 parser 或结构化输出是否改写了结果。
- 看是否触发 fallback。
- 把失败样本加入评估集。
一次排障如果只修一行 Prompt,而不沉淀失败样本,问题很容易反复出现。Trace 的价值不只是定位单次问题,还要把线上问题转成可回放、可评估的数据。
# 项目封装建议
可以把观测相关代码集中放在一个模块里。
internal/
  ai/
    callbacks.py
    observability.py
    chains/
      qa.py
      ticket.py
    agents/
      order_support.py
2
3
4
5
6
7
8
9
示例:
# internal/ai/observability.py
from typing import Any


def build_run_config(
    *,
    run_name: str,
    feature: str,
    tenant_id: str,
    user_id: str,
    request_id: str,
    prompt_version: str,
    extra_metadata: dict[str, Any] | None = None,
) -> dict[str, Any]:
    metadata = {
        "feature": feature,
        "tenant_id": tenant_id,
        "user_id": user_id,
        "request_id": request_id,
        "prompt_version": prompt_version,
    }

    if extra_metadata:
        metadata.update(extra_metadata)

    return {
        "run_name": run_name,
        "tags": [feature],
        "metadata": metadata,
    }
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
业务调用:
from internal.ai.observability import build_run_config


config = build_run_config(
    run_name="knowledge_base_qa",
    feature="rag_qa",
    tenant_id=tenant_id,
    user_id=user_id,
    request_id=request_id,
    prompt_version="kb-qa-2026-08-06-v1",
)

answer = chain.invoke(
    {"question": question},
    config=config,
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
这样每条链路的 metadata 不会散落在 route、service 和 chain 里。后续要统一增加 experiment_id、model_route 或 locale,只需要改一个地方。
# Callback 测试
自定义 callback 也要测试。至少要保证它不会影响主链路。
from langchain_core.runnables import RunnableLambda


def test_callback_does_not_break_chain():
    handler = DebugCallbackHandler()
    chain = RunnableLambda(lambda value: value.upper())

    result = chain.invoke(
        "hello",
        config={"callbacks": [handler]},
    )

    assert result == "HELLO"
2
3
4
5
6
7
8
9
10
11
12
13
如果 callback 会写日志或指标,可以用 fake client:
class FakeMetricsClient:
    def __init__(self):
        self.events = []

    def emit(self, name: str, payload: dict):
        self.events.append((name, payload))
2
3
4
5
6
测试重点不是模拟 LangChain 所有事件,而是验证你的 handler 在正常、失败、字段缺失时都不会拖垮主链路。
# 常见坑
# 只在开发环境 print
print 能解决本地问题,解决不了线上问题。线上需要 request id、trace id、结构化日志、错误码和可查询平台。
# 把用户原文全部打进日志
这会制造隐私和合规风险。尤其是企业知识库、客服、医疗、金融、HR、法务场景,输入输出都要有数据分级。
# metadata 没有版本字段
Prompt 和模型一直在变。如果 trace 里没有 prompt version、model name、feature name,后面很难解释为什么同一个问题昨天和今天答案不同。
# callback 里写复杂业务
Callback 应该观察链路,不应该驱动核心业务。真正的业务状态变更要放在 service、tool 或 workflow 中。
# 只记录失败,不记录成功
只看失败样本会失真。成功样本能帮你分析成本、延迟、质量分布和回归风险。
# 不区分本地调试和生产观测
本地可以详细打印,生产要脱敏、采样、限流、权限控制。两者策略应该不同。
# 生产 Checklist
上线前可以按这张表检查:
- 每条核心链路是否有稳定
run_name。 - 每次请求是否带
request_id。 - 是否记录
tenant_id、user_id、session_id。 - 是否记录 prompt version 和 model name。
- 是否能看到 retriever、model、parser、tool 的子 run。
- 是否统计 token、耗时、错误率和 fallback rate。
- 是否能根据 metadata 过滤某个功能或租户。
- 是否有输入输出脱敏策略。
- callback 是否不会阻塞主链路。
- Agent 工具调用是否可追踪。
- 失败样本是否会进入评估集。
做到这些,链路出了问题时,团队不会只剩“感觉模型不稳定”这种模糊判断。
# 小结
LangChain 的回调机制让链路执行过程从黑盒变成可观察事件;LangSmith tracing 则把这些事件组织成可查询、可分析、可评估的运行记录。
本地开发时,可以用 callback 或 astream_events 快速看过程。生产系统里,更应该用 RunnableConfig 统一注入 tags 和 metadata,用 LangSmith 或内部观测平台记录 trace、耗时、token、错误和工具调用。
LLM 应用要长期稳定,不能只优化 Prompt。你还要知道每次回答是怎么来的,哪里慢,哪里贵,哪里错,哪些失败样本应该进入下一轮评估。这就是回调和 tracing 真正的价值。