# LangChain Runnable 生命周期监听器:with_listeners、with_alisteners 与生产观测
Runnable 是 LangChain 里最重要的执行协议。Prompt、Model、Parser、Retriever、工具函数、LCEL 链,本质上都可以被看成 Runnable。
只要有执行,就会有生命周期:
- 什么时候开始执行。
- 输入是什么。
- 执行了多久。
- 是否成功。
- 输出是什么。
- 如果失败,异常是什么。
- 这次执行属于哪个租户、哪个功能、哪个实验分组。
生产环境里,这些信息不能只靠 print()。它们要进入日志、指标、trace、告警和审计系统。LangChain 提供了轻量的生命周期监听能力:with_listeners() 和 with_alisteners()。
# 生命周期监听器是什么
with_listeners() 可以给一个 Runnable 绑定三个生命周期钩子:
on_start:Runnable 开始执行前触发。on_end:Runnable 正常结束后触发。on_error:Runnable 抛出异常时触发。
基本结构如下:
from langchain_core.runnables import RunnableLambda, RunnableConfig
from langchain_core.tracers.schemas import Run


def on_start(run: Run, config: RunnableConfig) -> None:
    print("start:", run.id, run.inputs)


def on_end(run: Run, config: RunnableConfig) -> None:
    print("end:", run.id, run.outputs)


def on_error(run: Run, config: RunnableConfig) -> None:
    print("error:", run.id, run.error)


chain = RunnableLambda(lambda x: x + 1).with_listeners(
    on_start=on_start,
    on_end=on_end,
    on_error=on_error,
)

print(chain.invoke(1))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
监听函数可以只接收 Run,也可以接收 Run 和 RunnableConfig。生产里建议接收两个参数,因为 config 里通常有 tags、metadata、configurable、callbacks 等运行上下文。
# Run 对象里有什么
Run 可以理解为一次 Runnable 执行的记录。它通常包含:
id:本次运行的唯一标识。name:运行名称。type:运行类型。inputs:输入。outputs:输出。error:异常信息。start_time:开始时间。end_time:结束时间。tags:标签。metadata:元数据。
这让监听器可以做很多事情:
- 计算耗时。
- 记录输入输出摘要。
- 写业务审计日志。
- 统计失败率。
- 给异常打告警。
- 把 run id 写入业务日志,方便排查。
但也正因为 Run 可能包含输入输出,生产里必须注意脱敏。不要把用户隐私、密钥、内部 prompt、完整文档内容直接写进普通日志。
# 内部运行流程
with_listeners() 并不会修改原始 Runnable,而是返回一个新的 RunnableBinding。它把 on_start、on_end、on_error 包装成一个 RootListenersTracer,再通过 config factory 合并到本次运行的 callbacks 中。
流程可以理解为:
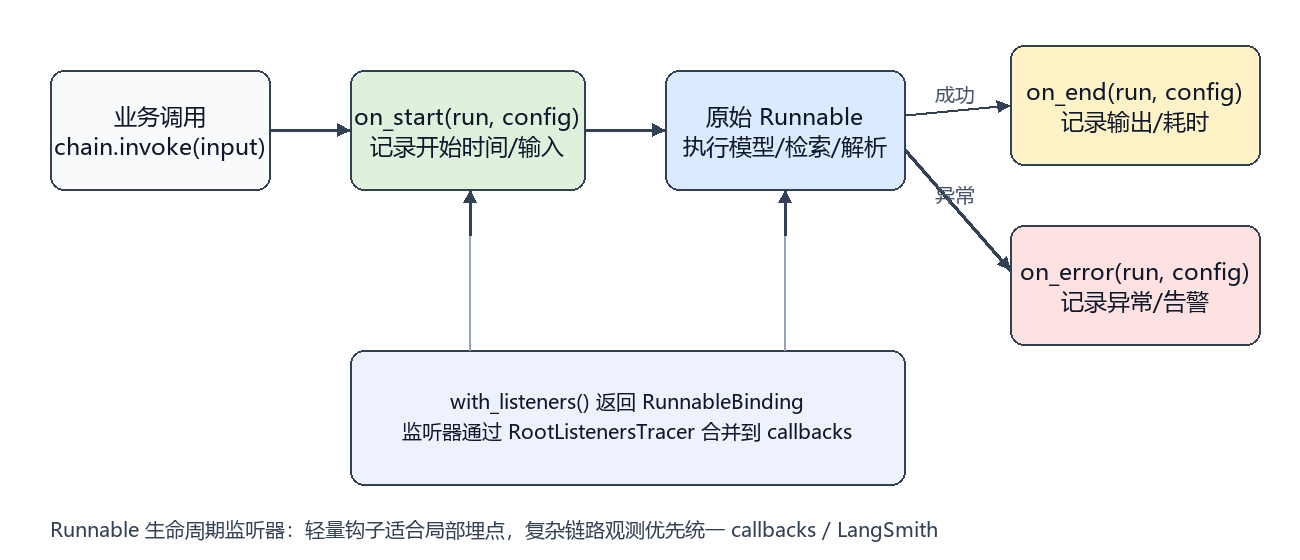
核心动作是:
- 调用
with_listeners()生成新的 Runnable。 - 新 Runnable 绑定原始 Runnable。
- 监听器被转换成 callback/tracer 进入运行配置。
- Runnable 开始时触发
on_start。 - 成功结束时触发
on_end。 - 抛出异常时触发
on_error。
所以它本质上不是另一套独立机制,而是 callbacks 体系的一种轻量封装。
# 记录耗时
最常见的监听场景是统计耗时。
import logging

from langchain_core.runnables import RunnableConfig
from langchain_core.tracers.schemas import Run


logger = logging.getLogger(__name__)


def on_end(run: Run, config: RunnableConfig) -> None:
    if run.start_time and run.end_time:
        duration_ms = (run.end_time - run.start_time).total_seconds() * 1000
    else:
        duration_ms = None

    metadata = config.get("metadata", {})

    logger.info(
        "runnable_completed",
        extra={
            "run_id": str(run.id),
            "run_name": run.name,
            "duration_ms": duration_ms,
            "tenant_id": metadata.get("tenant_id"),
            "feature": metadata.get("feature"),
        },
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
调用时把上下文放进 config:
chain.invoke(
    {"query": "解释一下 LCEL"},
    config={
        "run_name": "explain_lcel",
        "tags": ["langchain", "qa"],
        "metadata": {
            "tenant_id": "t_001",
            "feature": "doc_qa",
        },
    },
)
2
3
4
5
6
7
8
9
10
11
这类日志适合排查单次请求,也适合后续聚合分析。
# 错误告警
on_error 适合做轻量错误告警:
def on_error(run: Run, config: RunnableConfig) -> None:
    metadata = config.get("metadata", {})

    logger.exception(
        "runnable_failed",
        extra={
            "run_id": str(run.id),
            "run_name": run.name,
            "tenant_id": metadata.get("tenant_id"),
            "feature": metadata.get("feature"),
            "error": str(run.error),
        },
    )
2
3
4
5
6
7
8
9
10
11
12
13
但不要在 on_error 里做太重的事情,例如同步调用远程告警接口、写慢数据库、做复杂重试。监听器运行在链路执行路径上,太慢会拖慢用户请求。
更好的方式是:
- 监听器只记录结构化日志。
- 日志系统负责采集。
- 指标系统负责聚合。
- 告警系统基于错误率、延迟、fallback 命中率触发。
监听器可以是入口,但不应该变成完整的监控平台。
# 输入输出脱敏
生命周期监听器最容易踩的坑是把输入输出完整打出去。
LLM 链路里的输入输出可能包含:
- 用户隐私。
- 企业内部文档。
- 检索召回片段。
- Prompt 模板。
- 工具调用参数。
- 账号、订单、地址、手机号。
生产里建议只记录摘要:
def safe_preview(value: object, max_len: int = 120) -> str:
    text = str(value)
    text = text.replace("\n", " ")
    if len(text) > max_len:
        return text[:max_len] + "..."
    return text


def on_start(run: Run, config: RunnableConfig) -> None:
    logger.info(
        "runnable_started",
        extra={
            "run_id": str(run.id),
            "run_name": run.name,
            "input_preview": safe_preview(run.inputs),
        },
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
如果是金融、医疗、企业知识库场景,建议默认不记录输入输出,只记录长度、hash、文档 id、租户 id、链路步骤名。
# with_alisteners:异步监听器
如果 Runnable 走异步调用,可以使用 with_alisteners()。
import asyncio

from langchain_core.runnables import RunnableLambda
from langchain_core.tracers.schemas import Run


async def on_start(run: Run) -> None:
    await asyncio.sleep(0)
    print("async start:", run.id)


async def on_end(run: Run) -> None:
    await asyncio.sleep(0)
    print("async end:", run.id)


async def work(x: int) -> int:
    await asyncio.sleep(1)
    return x + 1


chain = RunnableLambda(work).with_alisteners(
    on_start=on_start,
    on_end=on_end,
)

result = asyncio.run(chain.ainvoke(1))
print(result)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
异步监听器不等于“不会影响性能”。如果监听器里 await 一个很慢的操作,仍然会影响链路完成时间。生产里同样建议把重活交给日志队列、消息队列或后台任务。
# 和 callbacks 的区别
with_listeners() 更像是给某个 Runnable 局部挂三个生命周期钩子。
Callbacks 更适合全局、细粒度、系统化观测。比如模型开始、模型结束、工具调用、检索器事件、链路事件、token 使用、流式输出等。
| 能力 | 适合场景 |
|---|---|
with_listeners() | 局部 Runnable 的开始、结束、异常监听 |
with_alisteners() | 异步 Runnable 的局部生命周期监听 |
config["callbacks"] | 调用时传入统一回调处理器 |
| 自定义 CallbackHandler | 全链路、多事件、可复用观测能力 |
| LangSmith | trace、评估、调试、生产可观测性 |
如果只是想给某个关键步骤加耗时日志,用 with_listeners() 很方便。
如果要建设完整观测体系,优先用 callbacks 或 LangSmith。
# 和 with_retry、with_fallbacks 的组合
监听器经常和重试、回退机制一起用。
例如监听 fallback 是否命中:
def on_error(run: Run, config: RunnableConfig) -> None:
    logger.warning(
        "primary_runnable_failed",
        extra={
            "run_id": str(run.id),
            "run_name": run.name,
            "error": str(run.error),
        },
    )


primary = primary_llm.with_listeners(on_error=on_error)
resilient_llm = primary.with_fallbacks([backup_llm])
2
3
4
5
6
7
8
9
10
11
12
13
这里要注意监听器挂在哪一层:
- 挂在
primary_llm上,只观察主模型。 - 挂在
backup_llm上,只观察备用模型。 - 挂在
primary.with_fallbacks(...)上,观察整个容错包装后的 Runnable。
不同位置看到的生命周期不同。生产排障时,这一点非常重要。
# 监听链中某一个步骤
LCEL 链里可以只监听关键步骤:
retriever = retriever.with_listeners(
    on_start=lambda run, config: logger.info("retriever_start"),
    on_end=lambda run, config: logger.info("retriever_end"),
    on_error=lambda run, config: logger.exception("retriever_error"),
)

llm = llm.with_listeners(
    on_end=lambda run, config: logger.info("llm_end"),
)

chain = {
    "context": retriever,
    "query": lambda x: x["query"],
} | prompt | llm | parser
2
3
4
5
6
7
8
9
10
11
12
13
14
这比给整条链只打一个耗时更有用。RAG 问题经常要拆开看:
- 是检索慢。
- 是 rerank 慢。
- 是模型慢。
- 是 parser 报错。
- 是工具调用失败。
监听器适合快速定位关键步骤。
# 生产实践建议
生产里使用生命周期监听器,要遵守几条原则。
第一,监听器必须轻量。不要在监听器里做慢 IO、复杂计算、同步告警风暴。
第二,日志必须结构化。不要只写自然语言字符串,要包含 run_id、run_name、tenant_id、feature、duration_ms、error_type。
第三,输入输出要脱敏。默认记录摘要、长度、hash,不记录完整内容。
第四,监听器不要改变业务结果。监听失败不应该影响主链执行,除非你明确希望它影响。
第五,统一命名。run_name、tags、metadata 要有团队约定,否则后续指标无法聚合。
第六,复杂观测用 callbacks 或 LangSmith。不要把所有监控逻辑都塞进 with_listeners()。
# 问题
生命周期监听器的问题主要有四类。
第一是性能问题。监听器里写慢日志、远程告警或数据库,会直接拖慢用户请求。
第二是隐私问题。Run 里可能包含输入和输出,随手记录会造成敏感信息泄漏。
第三是职责膨胀。监听器本来适合轻量埋点,但很多项目会把重试、补偿、状态更新都塞进去,最后让链路变得难以预测。
第四是观测碎片化。每条链都各写一套监听器,字段命名不一致,后续根本无法聚合分析。
所以监听器要克制使用,适合局部关键点,不适合替代完整可观测性体系。
# 拓展
生命周期监听器可以扩展到这些场景:
- 统计检索器耗时。
- 记录模型调用延迟。
- 观察 parser 失败率。
- 记录 fallback 命中。
- 给关键链路加审计日志。
- 在灰度实验里记录分组信息。
- 给高风险工具调用做前后记录。
- 在开发环境快速打印链路输入输出。
也可以封装成统一函数:
def attach_basic_listeners(runnable, step_name: str):
    def on_start(run: Run, config: RunnableConfig) -> None:
        logger.info("step_start", extra={"step": step_name, "run_id": str(run.id)})

    def on_end(run: Run, config: RunnableConfig) -> None:
        logger.info("step_end", extra={"step": step_name, "run_id": str(run.id)})

    def on_error(run: Run, config: RunnableConfig) -> None:
        logger.exception("step_error", extra={"step": step_name, "run_id": str(run.id)})

    return runnable.with_listeners(
        on_start=on_start,
        on_end=on_end,
        on_error=on_error,
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
这样可以避免每条链复制粘贴一堆监听逻辑。
# 实际生产是否使用
会使用,但更多用于局部补充。
适合使用的场景:
- 给某个关键 Runnable 临时加埋点。
- 给自定义 Runnable 增加业务审计。
- 在开发和调试环境快速观察生命周期。
- 对某个高风险工具调用记录开始、结束、异常。
- 在小型项目里做轻量日志。
大型生产系统通常会以 callbacks、OpenTelemetry、LangSmith、日志采集和指标平台为主。with_listeners() 可以作为局部增强,但不建议成为唯一观测方案。
# 现在是否抛弃
没有抛弃。
with_listeners() 和 with_alisteners() 仍然是当前 LangChain Runnable 体系里的正式能力。官方 API 仍然提供同步和异步两种生命周期监听方式。
不过它们的定位要摆正:这是 Runnable 层的轻量生命周期钩子,不是替代 CallbackHandler 或 LangSmith 的完整 tracing 体系。新项目可以继续使用,但要结合统一 callbacks、结构化日志和脱敏策略。
# 最新生产如何实现
最新生产实现建议按四层来做。
第一层,统一运行上下文:
config = {
    "run_name": "support_answer_chain",
    "tags": ["support", "rag", "production"],
    "metadata": {
        "tenant_id": tenant_id,
        "feature": "support_answer",
        "experiment": experiment,
    },
}
2
3
4
5
6
7
8
9
第二层,封装轻量监听器:
def build_step_listeners(step_name: str):
    def on_start(run: Run, config: RunnableConfig) -> None:
        logger.info("ai_step_start", extra={"step": step_name, "run_id": str(run.id)})

    def on_end(run: Run, config: RunnableConfig) -> None:
        logger.info("ai_step_end", extra={"step": step_name, "run_id": str(run.id)})

    def on_error(run: Run, config: RunnableConfig) -> None:
        logger.exception("ai_step_error", extra={"step": step_name, "run_id": str(run.id)})

    return on_start, on_end, on_error
2
3
4
5
6
7
8
9
10
11
第三层,只给关键步骤挂监听器:
on_start, on_end, on_error = build_step_listeners("retriever")
retriever = retriever.with_listeners(
    on_start=on_start,
    on_end=on_end,
    on_error=on_error,
)
2
3
4
5
6
第四层,完整链路使用 callbacks 或 LangSmith:
answer = chain.invoke(
    {"query": query},
    config={
        **config,
        "callbacks": callbacks,
    },
)
2
3
4
5
6
7
最终原则是:with_listeners() 用来补局部生命周期信号,callbacks 和 LangSmith 用来做全链路观测,日志和指标系统负责聚合分析,所有输入输出默认脱敏。这样生命周期监听器才会成为生产排障的助力,而不是新的复杂度来源。