# LangChain Runnable 配置运行时链内部:configurable_fields 与生产级参数治理
在真实的 LLM 应用里,链不是写完就固定不变的。不同用户、不同租户、不同业务入口、不同实验分组,可能都需要影响同一条链的执行方式:有的请求要更稳定,有的请求要更有创造性,有的请求要限制输出长度,有的请求要临时切换提示模板,有的请求要把调用记录打上不同的 trace 标签。
这类需求如果全部写成 if/else,链会很快变成一团业务配置和模型调用混在一起的代码。LangChain 的 Runnable 体系把这件事拆成两层:
RunnableConfig:描述一次运行的上下文配置,例如tags、metadata、callbacks、run_name、max_concurrency、recursion_limit、configurable。configurable_fields()/configurable_alternatives():声明哪些组件字段允许在运行时被覆盖或替换。
这篇文章重点讲第二层:当一个字段被声明为 configurable 之后,它在链内部到底是怎么生效的,以及生产环境应该怎么使用。
# bind 与 configurable_fields 的边界
上一篇已经讲过 bind():它适合把调用参数预先绑到某个 Runnable 上。
例如:
from langchain_openai import ChatOpenAI


llm = ChatOpenAI(model="gpt-4.1-mini").bind(
    temperature=0,
    stop=["\n\n"],
)
2
3
4
5
6
7
bind() 更像是“构建链时确定默认调用参数”。它返回一个新的 Runnable,后续调用时会把这些 kwargs 合并进去。
configurable_fields() 解决的是另一个问题:链已经构建好了,但某些字段允许在每次运行时根据配置覆盖。
典型差异如下:
| 能力 | 适合解决的问题 | 配置发生在什么时候 |
|---|---|---|
bind() | 给组件绑定默认调用参数,例如 stop、temperature、tools | 构建链时 |
with_config() | 绑定运行上下文,例如 tags、metadata、callbacks、run_name | 构建链时或调用前 |
configurable_fields() | 声明字段可被运行时覆盖,例如 temperature、max_tokens、template | 声明在构建链时,取值在运行时 |
configurable_alternatives() | 声明组件可被运行时替换,例如模型、提示模板、检索器 | 声明在构建链时,选择在运行时 |
一句话区分:bind() 是把参数提前塞进去,configurable_fields() 是把某些字段开放成运行时配置入口。
# configurable_fields 的基本写法
先看一个模型参数动态调整的例子。假设同一条链在普通问答里要稳定输出,在创意生成里要提高随机性。
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import ConfigurableField
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个回答简洁、结构清晰的助手。"),
        ("human", "{question}"),
    ]
)

llm = ChatOpenAI(
    model="gpt-4.1-mini",
    temperature=0.2,
).configurable_fields(
    temperature=ConfigurableField(
        id="llm_temperature",
        name="模型温度",
        description="控制模型输出的随机性",
    )
)

chain = prompt | llm | StrOutputParser()

stable_answer = chain.invoke(
    {"question": "解释什么是数据库事务"},
    config={
        "configurable": {
            "llm_temperature": 0,
        }
    },
)

creative_answer = chain.invoke(
    {"question": "用一个生活类比解释数据库事务"},
    config={
        "configurable": {
            "llm_temperature": 0.8,
        }
    },
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
这里有两个关键点:
temperature=ConfigurableField(...)里的temperature是组件真实字段名。id="llm_temperature"是对外暴露的配置键,调用时写在config["configurable"]里。
这种设计很适合生产环境。业务层不需要知道 ChatOpenAI 内部字段叫什么,只需要按你定义的稳定配置键传值。
# 在链内部如何生效
configurable_fields() 不是直接修改原始对象,而是包了一层动态 Runnable。运行时拿到 config["configurable"] 后,会根据声明过的 ConfigurableField.id 找到对应字段,再临时创建一个带覆盖参数的新组件参与本次调用。
流程可以理解为:
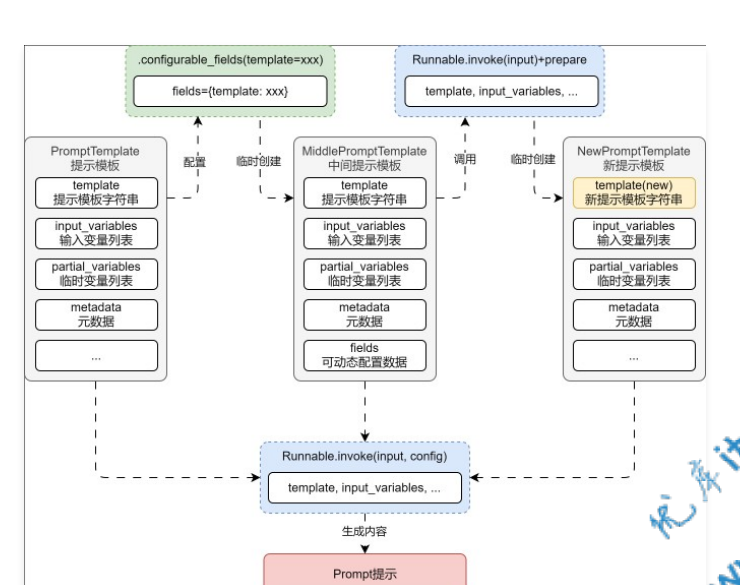
核心动作是:
- 原始组件先声明哪些字段可配置,例如
template、temperature、max_tokens。 - 调用
invoke(input, config=...)时,LangChain 读取config["configurable"]。 - 动态 Runnable 根据配置键找到字段映射。
- 使用原始参数加运行时配置生成一个临时组件。
- 本次调用使用临时组件执行,原始组件不被永久修改。
这也是它比直接改对象属性更适合并发场景的原因。线上服务里同一条链可能同时处理多个请求,如果直接修改共享对象字段,很容易出现请求之间互相污染;运行时创建临时配置对象则更可控。
# PromptTemplate 也可以动态配置
configurable_fields() 不只适用于模型。只要 Runnable 暴露了可配置字段,就可以声明运行时覆盖。
例如把 PromptTemplate.template 变成可配置字段:
from langchain_core.prompts import PromptTemplate
from langchain_core.runnables import ConfigurableField


prompt = PromptTemplate.from_template(
    "写一段关于 {subject} 的冷笑话。"
).configurable_fields(
    template=ConfigurableField(
        id="prompt_template",
        name="提示模板",
        description="运行时覆盖提示模板文本",
    )
)

content = prompt.invoke(
    {"subject": "程序员"},
    config={
        "configurable": {
            "prompt_template": "写一首关于 {subject} 的藏头诗。",
        }
    },
).to_string()

print(content)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
这个例子可以说明链内部的覆盖方式:原始 PromptTemplate 仍然存在,但这次调用会创建一个新的临时 Prompt 实例,并用新的 template 字段生成提示词。
不过在生产环境里,不建议让前端或外部调用方直接传完整 prompt 模板。提示模板属于高风险配置,容易引入 prompt injection、越权信息泄漏、审计困难和输出不可控。更常见的做法是只暴露一个策略键:
PROMPT_VARIANTS = {
    "default": "请回答用户问题:{question}",
    "strict_json": "请只输出 JSON,问题是:{question}",
    "short": "请用三句话以内回答:{question}",
}


def resolve_prompt_template(style: str) -> str:
    return PROMPT_VARIANTS.get(style, PROMPT_VARIANTS["default"])
2
3
4
5
6
7
8
9
业务层传 style=short,后端把它转换成受控模板,而不是让调用方直接传模板正文。
# configurable_alternatives:动态替换组件
如果只是改字段,用 configurable_fields();如果要替换整个组件,用 configurable_alternatives()。
例如同一条链根据运行时策略选择不同模型:
from langchain_core.runnables import ConfigurableField
from langchain_openai import ChatOpenAI


llm = ChatOpenAI(model="gpt-4.1-mini").configurable_alternatives(
    ConfigurableField(id="llm"),
    default_key="fast",
    fast=ChatOpenAI(model="gpt-4.1-mini", temperature=0.2),
    reasoning=ChatOpenAI(model="gpt-4.1", temperature=0),
)

answer = llm.invoke(
    "分析这段用户投诉背后的核心诉求。",
    config={
        "configurable": {
            "llm": "reasoning",
        }
    },
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
它常用于:
- 免费版、专业版、企业版使用不同模型。
- 简单问题走低成本模型,复杂问题走强模型。
- 多供应商容灾。
- A/B 实验。
- 不同租户有不同模型白名单。
这里同样要注意:运行时传入的应该是受控 key,而不是任意模型名。生产系统需要在后端做白名单、权限、预算和审计。
# RunnableConfig 不是业务输入
RunnableConfig 容易被误用成“什么都往里塞”的字典。它应该表达运行上下文,而不是替代业务输入。
适合放进 config 的内容:
tags:用于 trace、观测、分组统计,例如["chat", "tenant:enterprise"]。metadata:用于观测和审计的非敏感元信息,例如tenant_id、feature、experiment。callbacks:用于日志、调试、LangSmith tracing 或自定义事件处理。run_name:给链路步骤命名,方便排障。max_concurrency:控制批处理并发。recursion_limit:限制递归 Runnable 或图执行深度。configurable:传递被声明为可配置的运行时字段。
不适合放进 config 的内容:
- 用户原始问题。
- 大段业务数据。
- 密钥、token、数据库连接串。
- 需要进入 prompt 的变量。
- 需要持久化为业务状态的数据。
业务输入应该放在 invoke(input) 的 input 里;运行上下文才放在 config 里。
# 生产级配置封装
生产环境里,最好不要在接口层到处手写 config={"configurable": ...}。更好的方式是封装一个配置构造器,把权限、预算、租户策略、实验策略统一收口。
from dataclasses import dataclass


@dataclass(frozen=True)
class RequestContext:
    tenant_id: str
    user_hash: str
    plan: str
    feature: str
    experiment: str | None = None


def build_runnable_config(ctx: RequestContext) -> dict:
    if ctx.plan == "enterprise":
        temperature = 0.2
        output_tokens = 1200
        llm_profile = "reasoning"
    else:
        temperature = 0.1
        output_tokens = 600
        llm_profile = "fast"

    configurable = {
        "llm_temperature": temperature,
        "output_token_number": output_tokens,
        "llm_profile": llm_profile,
    }

    return {
        "run_name": f"{ctx.feature}_chain",
        "tags": ["ai", ctx.feature, f"plan:{ctx.plan}"],
        "metadata": {
            "tenant_id": ctx.tenant_id,
            "user_hash": ctx.user_hash,
            "feature": ctx.feature,
            "experiment": ctx.experiment,
        },
        "configurable": configurable,
        "max_concurrency": 4,
    }
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
然后调用链时保持干净:
ctx = RequestContext(
    tenant_id="t_001",
    user_hash="usr_8f4a",
    plan="enterprise",
    feature="support_answer",
    experiment="answer_v2",
)

answer = chain.invoke(
    {"question": "订单一直没有发货怎么办?"},
    config=build_runnable_config(ctx),
)
2
3
4
5
6
7
8
9
10
11
12
这类封装有几个好处:
- 配置入口集中,便于审计。
- 业务规则清晰,便于测试。
- 不同链可以复用同一套租户和实验策略。
- 不会让前端直接控制模型内部参数。
- trace 元数据一致,排查线上问题更容易。
# 多层链里的配置传递
LCEL 链通常由多个 Runnable 组成:
chain = {
    "context": retriever,
    "question": lambda x: x["question"],
} | prompt | llm | StrOutputParser()
2
3
4
当你在顶层调用时传入 config:
result = chain.invoke(
    {"question": "如何设计订单状态机?"},
    config={
        "run_name": "order_state_qa",
        "tags": ["rag", "order"],
        "metadata": {"tenant_id": "t_001"},
        "configurable": {"llm_temperature": 0},
    },
)
2
3
4
5
6
7
8
9
这些运行配置会沿着 Runnable 调用链向下传递。被声明过的配置字段会读取 configurable 中对应的值;回调、标签、元数据则用于观测链路内部每个步骤。
这也是为什么可配置字段的 id 要命名稳定。它已经不只是局部变量,而是运行时配置协议的一部分。建议使用有业务含义的 key,例如:
llm_temperatureoutput_token_numberllm_profileprompt_variantretriever_top_krerank_enabled
不要使用太泛的 key,例如 temperature、model、template。在复杂链里,同名 key 很容易冲突。
# 和 RunnableWithMessageHistory 的关系
RunnableWithMessageHistory 也依赖 config["configurable"],常见写法是传 session_id:
chain_with_history.invoke(
    {"input": "继续解释上一段"},
    config={
        "configurable": {
            "session_id": "user-123-thread-456",
        }
    },
)
2
3
4
5
6
7
8
这说明 configurable 不只用于模型参数,也可以用于 Runnable 包装器读取运行时上下文。区别在于:
configurable_fields()用它来覆盖组件字段。RunnableWithMessageHistory用它来定位会话历史。configurable_alternatives()用它来选择组件分支。
所以生产环境需要把 configurable 当成一份严肃的运行时协议来管理,而不是临时字典。
# 测试策略
这类能力最怕“看起来能跑,线上参数没生效”。建议至少覆盖以下测试:
def test_enterprise_plan_uses_reasoning_profile():
    ctx = RequestContext(
        tenant_id="t1",
        user_hash="usr_test",
        plan="enterprise",
        feature="support_answer",
    )

    config = build_runnable_config(ctx)

    assert config["configurable"]["llm_profile"] == "reasoning"
    assert config["configurable"]["output_token_number"] == 1200
    assert "plan:enterprise" in config["tags"]


def test_free_plan_uses_fast_profile():
    ctx = RequestContext(
        tenant_id="t1",
        user_hash="usr_test",
        plan="free",
        feature="support_answer",
    )

    config = build_runnable_config(ctx)

    assert config["configurable"]["llm_profile"] == "fast"
    assert config["configurable"]["output_token_number"] == 600
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
如果项目里有 LangSmith 或自定义回调,还应该验证:
run_name是否符合链路命名规范。tenant_id、feature、experiment是否进入 metadata。- 敏感字段是否没有进入 trace。
- 不同租户的模型选择是否符合权限。
- 并发调用时配置是否互不污染。
# 问题
configurable_fields() 最大的问题不是能力不够,而是容易被滥用。
常见坑有几个:
- 把所有模型参数都暴露出去,导致调用方可以绕过成本和安全策略。
- 直接暴露完整 prompt 模板,导致注入风险和审计困难。
- 配置 key 命名太随意,在复杂链里发生冲突。
- 把业务输入塞进
config,导致链路边界混乱。 - 把密钥、token、内部策略放入 metadata,最终进入 trace 或日志。
- 没有测试配置构造器,线上发现参数根本没生效。
正确姿势是:能配置,不等于应该暴露;可配置字段应该由后端策略层生成,外部请求只能影响受控选项。
# 拓展
configurable_fields() 可以继续拓展到 RAG 链路:
retriever_top_k:动态控制召回数量。rerank_enabled:控制是否启用重排。prompt_variant:选择不同提示模板。llm_profile:选择快模型或强模型。output_token_number:控制输出长度。answer_style:控制回答风格,但只允许白名单枚举。
还可以和 configurable_alternatives() 组合:
from langchain_core.runnables import ConfigurableField


retriever = vector_retriever.configurable_alternatives(
    ConfigurableField(id="retriever_profile"),
    default_key="vector",
    hybrid=hybrid_retriever,
)
2
3
4
5
6
7
8
这样同一条 RAG 链可以按租户、场景、实验分组动态选择检索策略,但业务代码仍然只调用一条链。
# 实际生产是否使用
会使用,但通常不会让它直接面对前端。
在生产系统里,它适合做“受控运行时配置”:
- 后端根据用户套餐选择模型档位。
- 后端根据场景调整
temperature和max_tokens。 - 后端根据实验分组切换 prompt 版本。
- 后端根据租户策略切换检索器或 reranker。
- 后端给链路统一打 trace 标签和 metadata。
它不适合做“用户想传什么就传什么”的自由配置入口。LLM 参数背后往往连着成本、稳定性、安全和合规,必须通过服务端策略层治理。
# 现在是否抛弃
没有抛弃。
在当前 LangChain Runnable 体系里,RunnableConfig、with_config()、configurable_fields()、configurable_alternatives() 仍然是运行时配置的重要机制。它们和 LCEL、callbacks、tracing、RunnableWithMessageHistory 都是同一套 Runnable 协议里的能力。
真正需要谨慎的是旧式 Memory 组件的选型,而不是 Runnable 配置机制本身。对于新项目,可以继续使用 configurable_fields() 管理可控参数;对于复杂 Agent 状态,优先用 LangGraph checkpointer/store 管理状态,把 RunnableConfig 保持为运行上下文。
# 最新生产如何实现
最新生产实现建议按四层拆:
第一层是链定义层,只声明能力:
llm = ChatOpenAI(
    model="gpt-4.1-mini",
    temperature=0.2,
    max_tokens=600,
).configurable_fields(
    temperature=ConfigurableField(id="llm_temperature"),
    max_tokens=ConfigurableField(id="output_token_number"),
)
2
3
4
5
6
7
8
第二层是策略层,根据租户、功能、实验、预算生成配置:
config = build_runnable_config(ctx)
第三层是调用层,只传业务输入和策略配置:
answer = chain.invoke(
    {"question": question},
    config=config,
)
2
3
4
第四层是观测层,用 tags、metadata、callbacks 或 LangSmith 追踪每次运行:
config = {
    "run_name": "support_answer_chain",
    "tags": ["support", "rag", "production"],
    "metadata": {
        "tenant_id": tenant_id,
        "feature": "support_answer",
        "experiment": experiment,
    },
    "configurable": {
        "llm_temperature": 0.1,
        "output_token_number": 800,
        "llm_profile": "fast",
    },
}
2
3
4
5
6
7
8
9
10
11
12
13
14
落到工程实践上,可以记住这条线:
业务输入走 invoke(input);运行上下文走 RunnableConfig;允许动态变化的组件字段先用 configurable_fields() 声明;可替换组件用 configurable_alternatives();所有外部可影响的值都必须经过后端白名单和策略校验。
这样写出来的链既有灵活性,也不会把生产控制权交给不可控输入。