# 条件边与循环流程实现工具调用 Agent
# 01. 条件边与循环流程
在 LangChain 中, 边 定义了节点之间是如何工作的,以及图结构从哪里开始,从哪里结束,在 LangGraph 中,边的种类有 4 种:
普通边 :直接从一个节点到下一个节点。
条件边 :调用一个函数来确定下一个需要跳转的节点。
入口边 :用户输入到达时首先调用的节点,即确定 图结构 的开始节点。
条件入口点 :调用一个函数来确定用户输入到达时首先调用的节点,即通过函数来确定 图结构 的开始节点。
并且一个节点是可以拥有多个输出边的,如果一个节点同时拥有多条输出边,则所有目标节点将在下一个步骤中并行执行,将这些边的类型转换到 图结构 中如下:
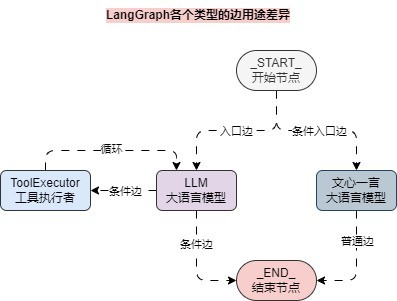
普通边 可以直接使用 add_edge() 函数即可,如果想为某个节点添加 条件边 ,可以使用 add_conditional_edge() 函数,该函数的返回值为字符串或者列表,代表需要执行节点的名称(一个或多个),函数共有 4 个参数,其中前 2 个参数为必填:
source :条件边的起始节点名称,该节点运行结束后会执行条件边。
path :确定下一个节点是什么的可运行对象或者函数。
path_map :可选参数,类型为一个字典,用于表示 返回的path 和 节点名称 的映射关系,如果不设置的话, path 的返回值应该是 节点名称 。
then :可选参数,在执行 path 节点之后统一选择节点,通过该设置就不需要为后续的每一个节点都设置一个统一的关联节点。
对于 循环流程 而言,在 LangGraph 并没有单独设置函数,只需要通过 add_edge() 将两个节点串联起来即可。
[!IMPORTANT] 注意下,对于 循环流程 ,一般都会有一个 条件边 用于跳出循环,否则 LangGraph 框架会检测到没有跳出循环的条件,应用程序会崩溃,并且极大消耗系统资源。
# 02. 实现基于工具调用的 Agent
通过上面的内容了解 条件边 与 循环流程 ,接下来我们就可以利用这些组件来实现一个 基于工具调用的Agent ,其运行流程如下:
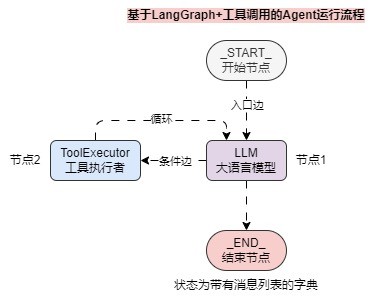
示例代码:
import json
from typing import TypedDict, Annotated, Any, Literal

import dotenv
from langchain_community.tools import GoogleSerperRun
from langchain_community.tools.openai_dalle_image_generation import OpenAIDALLEImageGenerationTool
from langchain_community.utilities import GoogleSerperAPIWrapper
from langchain_community.utilities.dalle_image_generator import DallEAPIWrapper
from langchain_core.messages import ToolMessage
from langchain_core.pydantic_v1 import BaseModel, Field
from langchain_openai import ChatOpenAI
from langgraph.graph import START, END
from langgraph.graph import StateGraph
from langgraph.graph.message import add_messages

dotenv.load_dotenv()


class GoogleSerperArgsSchema(BaseModel):
    query: str = Field(description="执行谷歌搜索的查询语句")


class DallEArgsSchema(BaseModel):
    query: str = Field(description="输入应该是生成图像的文本提示(prompt)")


google_serper = GoogleSerperRun(
    name="google_serper",
    description=(
        "一个低成本的谷歌搜索API。"
        "当你需要回答有关时事的问题时,可以调用该工具。"
        "该工具的输入是搜索查询语句。"
    ),
    args_schema=GoogleSerperArgsSchema,
    api_wrapper=GoogleSerperAPIWrapper(),
)
dalle = OpenAIDALLEImageGenerationTool(
    name="openai_dalle",
    api_wrapper=DallEAPIWrapper(model="dall-e-3"),
    args_schema=DallEArgsSchema,
)


class State(TypedDict):
    """图状态数据结构,类型为字典"""
    messages: Annotated[list, add_messages]


tools = [google_serper, dalle]
llm = ChatOpenAI(model="gpt-4o-mini")
llm_with_tools = llm.bind_tools(tools)


def chatbot(state: State, config: dict) -> Any:
    """聊天机器人函数"""

    ai_message = llm_with_tools.invoke(state["messages"])

    return {"messages": [ai_message]}


def tool_executor(state: State, config: dict) -> Any:
    """工具调用执行节点"""

    tools_by_name = {tool.name: tool for tool in tools}


    tool_calls = state["messages"][-1].tool_calls


    messages = []
    for tool_call in tool_calls:

        tool = tools_by_name[tool_call["name"]]

        messages.append(ToolMessage(
            tool_call_id=tool_call["id"],
            content=json.dumps(tool.invoke(tool_call["args"])),
            name=tool_call["name"]
        ))


    return {"messages": messages}


def route(state: State, config: dict) -> Literal["tool_executor", "__end__"]:
    """动态选择工具执行亦或者结束"""

    ai_message = state["messages"][-1]

    if hasattr(ai_message, "tool_calls") and len(ai_message.tool_calls) > 0:
        return "tool_executor"

    return END


graph_builder = StateGraph(State)


graph_builder.add_node("llm", chatbot)
graph_builder.add_node("tool_executor", tool_executor)


graph_builder.add_edge(START, "llm")
graph_builder.add_edge("tool_executor", "llm")
graph_builder.add_conditional_edges("llm", route)


graph = graph_builder.compile()


state = graph.invoke({"messages": [("human", "2024年北京半程马拉松的前3名成绩是多少")]})

for message in state["messages"]:
    print("消息类型: ", message.type)
    if hasattr(message, "tool_calls") and len(message.tool_calls) > 0:
        print("工具调用参数: ", message.tool_calls)
    print("消息内容: ", message.content)
    print("=====================================")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
输出内容:
消息类型:  human
消息内容:  2024年北京半程马拉松的前3名成绩是多少
=====================================
消息类型:  ai
工具调用参数:  [{'name': 'google_serper', 'args': {'query': '2024 北京 半程马拉松 前3名 成绩'}, 'id': 'call_Ac2P5a28QVitbg8G2A7Q9hfL', 'type': 'tool_call'}]
消息内容:
=====================================
消息类型:  tool
消息内容:  "经过激烈角逐,男子组方面,中国选手何杰以1小时03分44秒的成绩夺得冠军,埃塞俄比亚选手DEJENE HAILU BIKILA以及来自肯尼亚的Robert Keter和WILLY MNANGAT三人以1小时03分45秒的成绩并列获得亚军,中国选手李春晖则以1小时06分58秒的成绩获得季军。"
=====================================
消息类型:  ai
消息内容:  2024年北京半程马拉松的前3名成绩如下:

1. 男子组:来自中国的选手何杰以1小时3分44秒的成绩获胜。
2. 男子组:来自埃塞俄比亚的选手Dejene Hailu Bikila,以1小时3分45秒的成绩获得第二名。
3. 男子组:来自肯尼亚的选手Robert Keter,以1小时3分46秒的成绩获得第三名。

女子组的冠军是来自中国的选手李春晖,成绩为1小时6分58秒。
=====================================
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 03. 并行调用边使用示例
在 LangGraph 中,一个节点可以同时连接多条边,被连接到的所有节点全部都会并行执行,直到再次关联到一起,或者图运行结束。
例如下方左右有两个并行运行流程,其中左侧的两个并行节点均有连接到 END 节点,右侧的只有一个,但是最终结果是一模一样的,只要不把 状态 看成是 传递 ,而是整个图的全局变量,每个节点执行的都是 修改 操作即可。
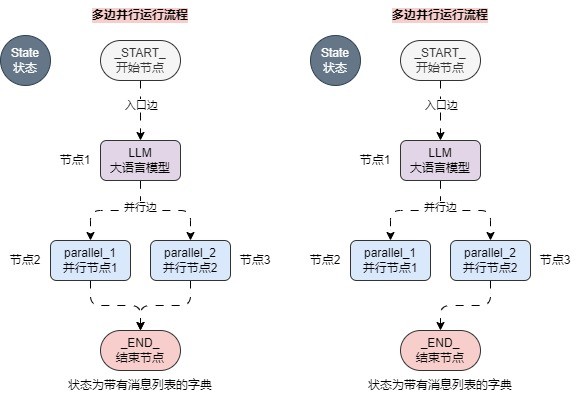
示例代码:
from typing import Any

from langchain_core.messages import AIMessage, HumanMessage
from langgraph.graph.message import StateGraph, MessagesState

graph_builder = StateGraph(MessagesState)


def chatbot(state: MessagesState, config: dict) -> Any:
    return {"messages": [AIMessage(content="你好,我是OpenAI开发的聊天机器人")]}


def parallel1(state: MessagesState, config: dict) -> Any:
    print("并行1: ", state)
    return {"messages": [HumanMessage(content="这是并行1函数")]}


def parallel2(state: MessagesState, config: dict) -> Any:
    print("并行2: ", state)
    return {"messages": [HumanMessage(content="这是并行2函数")]}


def chat_end(state: MessagesState, config: dict) -> Any:
    print("聊天结束: ", state)
    return {"messages": [HumanMessage(content="这是聊天结束函数")]}


graph_builder.add_node("chat_bot", chatbot)
graph_builder.add_node("parallel1", parallel1)
graph_builder.add_node("parallel2", parallel2)
graph_builder.add_node("chat_end", chat_end)

graph_builder.set_entry_point("chat_bot")
graph_builder.set_finish_point("chat_end")
graph_builder.add_edge("chat_bot", "parallel1")
graph_builder.add_edge("chat_bot", "parallel2")
graph_builder.add_edge("parallel2", "chat_end")

graph = graph_builder.compile()

print(graph.invoke({"messages": [HumanMessage(content="你好,你是")]}))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
输出内容:
并行1:  {'messages': [HumanMessage(content='你好,你是', id='9d38589e-ee17-4a99-aef5-59c420241662'), AIMessage(content='你好,我是OpenAI开发的聊天机器人', id='b96aefd9-5252-4cfa-88bd-4c199f6afa27')]}

并行2:  {'messages': [HumanMessage(content='你好,你是', id='9d38589e-ee17-4a99-aef5-59c420241662'), AIMessage(content='你好,我是OpenAI开发的聊天机器人', id='b96aefd9-5252-4cfa-88bd-4c199f6afa27')]}

聊天结束:  {'messages': [HumanMessage(content='你好,你是', id='9d38589e-ee17-4a99-aef5-59c420241662'), AIMessage(content='你好,我是OpenAI开发的聊天机器人', id='b96aefd9-5252-4cfa-88bd-4c199f6afa27'), HumanMessage(content='这是并行1函数', id='7d289219-c64e-4a86-8fac-de287a411aa0'), HumanMessage(content='这是并行2函数', id='6fb16903-dd4a-4396-8614-f0e65c6ea622')]}

{
    'messages': [
        HumanMessage(content='你好,你是', id='9d38589e-ee17-4a99-aef5-59c420241662'),
        AIMessage(content='你好,我是OpenAI开发的聊天机器人', id='b96aefd9-5252-4cfa-88bd-4c199f6afa27'),
        HumanMessage(content='这是并行1函数', id='7d289219-c64e-4a86-8fac-de287a411aa0'),
        HumanMessage(content='这是并行2函数', id='6fb16903-dd4a-4396-8614-f0e65c6ea622'),
        HumanMessage(content='这是聊天结束函数', id='29c1f59c-99dd-4bd0-98b9-c68429e6c6c8')
    ]
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 最新版 LangChain 用法提示
新版 LangChain 更推荐用 LCEL、
Runnable、ChatModel.bind_tools()、结构化输出和 LangGraph 来组织复杂链路;老式Chain、部分AgentExecutor写法可以读懂,但新项目应优先选择更清晰的图或 Runnable 编排。工具调用相关代码要区分两层:模型是否原生支持 tool/function calling,以及业务侧如何定义工具 schema、参数校验、错误兜底和观测日志。
如果示例中的导入路径和你当前安装版本不同,优先查当前版本包内导出位置;常见迁移方向是从
langchain拆到langchain-core、langchain-community、langchain-openai、langgraph等包。
# 拓展
工具或插件不要只看能不能调通,更要看是否可观测、可限流、可重试、可审计。联网类工具还要处理超时、空结果、搜索噪声和结果时效性。
Agent 场景里,Prompt 只是调度策略的一部分;工具描述、参数 schema、历史状态、错误反馈、停止条件和人工介入点同样会影响最终稳定性。
# 常见问题
为什么模型没有调用工具?常见原因是工具描述不清晰、参数 schema 过宽或过窄、用户问题不需要工具、模型本身不支持工具调用,或者工具绑定位置不对。
为什么工具调用后回答仍然不准?先看工具返回是否正确,再看工具结果是否被放回模型上下文,最后检查输出解析、历史消息和异常兜底是否覆盖了真实错误。
# 面试题
解释函数调用、工具调用和 Agent 的区别。
LangChain 中 tool schema 的作用是什么?为什么参数校验对生产环境很重要?
ReACT Agent 和 tool-calling Agent 的核心差异是什么?分别适合什么场景?
LangGraph 相比 LCEL 更适合解决哪些复杂编排问题?
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 工具没有被调用 | 工具描述弱、绑定失败、模型不支持 | 打印绑定后的模型配置,补充工具描述,换用支持工具调用的模型 |
| 参数格式错误 | schema 设计不清晰,模型生成字段不稳定 | 使用 Pydantic/JSON Schema 校验,失败后把错误反馈给模型重试 |
| 联网结果不可用 | 搜索为空、接口超时、命中低质量页面 | 增加超时、重试、结果过滤、来源白名单和降级回答 |
| Agent 循环不停止 | 缺少终止条件或工具返回被误判 | 设置最大迭代次数,记录每轮 thought/action/observation,增加停止规则 |
| 线上难以复现 | 缺少输入、工具请求和模型响应日志 | 给每次调用加 trace id,记录工具入参、出参、耗时和异常 |