# LangGraph 检查点实现持久化记忆功能
# 01. 检查点与线程
在 LCEL 表达式构建的链应用中,我们将 Memory组件 通过 .with_listen() 函数绑定到整个链的 运行结束生命周期 上,从而去实现链记忆功能的自动管理,在 LangGraph 中也有类似的功能,不过该功能是 检查点 ,在编程中 检查点 通常用于记录或标记程序在某个阶段的 状态 ,以便在程序运行过程中出现问题时,可以回溯到特定的状态,亦或者在图执行的过程中将任意一个节点的状态进行保存。
理解 检查点 其实很简单,想象一下你在玩一个需要多个任务的游戏,比如一个冒险游戏,你的角色需要完成许多关卡和任务。如果你在某个关卡中遇到困难或游戏崩溃,你不想从游戏的开头重新开始。于是,游戏就会在你完成每个关卡后保存一个 检查点/存档点 ,这样你就可以从不同 检查点/存档点 重新启动游戏继续玩。
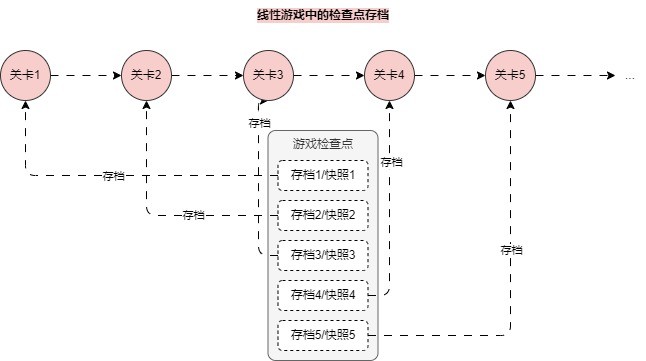
并且在很多开源项目中都可以看到 检查点 的身影,例如: TensorFlow、PyTorch、FLink、Spark、Celery 等。
在 LangGraph 中,持久化使用的就是 检查点 ,并且除了这个功能,每个 检查点 还和 线程ID 有关, 检查点 存储的并不是整个图结构应用程序的 节点状态 ,而是存储 特定线程 的 数据状态 ,这是因为 LangGraph 在设计的时候就考虑到一个应用的多次独立对话功能。
就好比游戏存档中,每个家庭成员玩同一款游戏,可以保留独属于自己的不同存档,通过不同的 线程 和 检查点 实现共用一套程序,并实现完全隔离,这个时候 LangGraph 图结构的流程就变成如下:
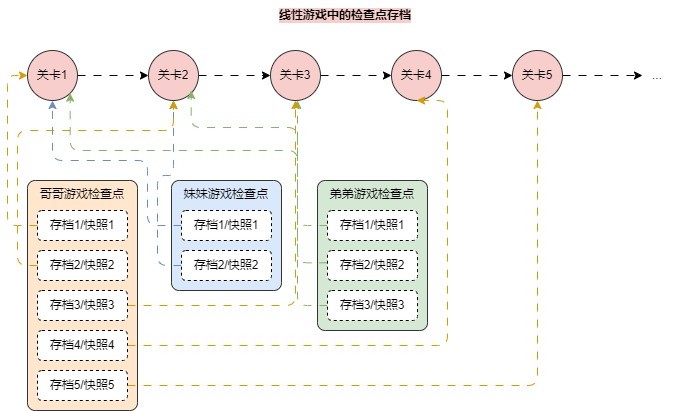
可以看到这个时候 数据状态 和 检查点 在不同 线程/游戏账号 下都是相互独立的,不会互相干扰,在 LangGraph 中于是这样设计的,例如在不添加 检查点 的情况下,在同一份程序中,对 图结构应用程序 发起多次提问,可以发现 图 并没有记忆,如下:
print(agent.invoke({"messages": [("human", "你好,我叫慕小课,我喜欢游泳打球,你喜欢什么呢?")]}))


print(agent.invoke({"messages": [("human", "你知道我叫什么吗?")]}))
2
3
4
输出内容:
{'messages': [HumanMessage(content='你好,我叫慕小课,我喜欢游泳打球,你喜欢什么呢?', id='e37d3158-f62a-4948-9f86-9ea3e646f3b0'), AIMessage(content='你好,慕小课!我喜欢帮助人们,回答问题和提供信息。游泳和打球听起来很有趣!你最喜欢的运动是什么呢?', response_metadata={'token_usage': {'completion_tokens': 39, 'prompt_tokens': 171, 'total_tokens': 210}, 'model_name': 'gpt-4o-mini', 'system_fingerprint': 'fp_80a1bad4c7', 'finish_reason': 'stop', 'logprobs': None}, id='run-f1aeb344-9ad4-4aa5-8d38-be996a2d4b01-0', usage_metadata={'input_tokens': 171, 'output_tokens': 39, 'total_tokens': 210})]}

{'messages': [HumanMessage(content='你知道我叫什么吗?', id='ab20e3fb-774e-459c-a98a-4ab0d9940b81'), AIMessage(content='我不知道你的名字,因为我没有访问个人信息的能力。不过,你可以告诉我你的名字!', response_metadata={'token_usage': {'completion_tokens': 21, 'prompt_tokens': 159, 'total_tokens': 180}, 'model_name': 'gpt-4o-mini', 'system_fingerprint': 'fp_80a1bad4c7', 'finish_reason': 'stop', 'logprobs': None}, id='run-1ab95b1f-21d1-413a-8f2d-344a3aac6282-0', usage_metadata={'input_tokens': 159, 'output_tokens': 21, 'total_tokens': 180})]}
2
3
可以发现,在没有设置 检查点 与 线程 的时候,图应用程序每次运行都会管理新的 数据状态 ,并不会持久化,要想使用 检查点 来为图提供持久化记忆,操作技巧也非常简单,共两步:
实例化一个检查点,例如 AsyncSqliteSaver 或者 MemorySaver() ,亦或者自定义检查点。
在图编译的时候传递检查点,例如 compile(checkpointer=my_checkpointer) 。
接下来在和图程序交互时传递 config ,并配置 thread_id 即可记住以往的历史记忆/存档,更新代码如下:
checkpointer = MemorySaver()
agent = create_react_agent(
    model=model,
    tools=tools,
    checkpointer=checkpointer,
)


print(agent.invoke(
    {"messages": [("human", "你好,我叫慕小课,我喜欢游泳打球,你喜欢什么呢?")]},
    config={"configurable": {"thread_id": 1}}
))


print(agent.invoke(
    {"messages": [("human", "你知道我叫什么吗?")]},
    config={"configurable": {"thread_id": 1}}
))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
输出内容:
{'messages': [HumanMessage(content='你好,我叫慕小课,我喜欢游泳打球,你喜欢什么呢?', id='44679054-e5e3-4a04-9e6e-a9db63eeac7c'), AIMessage(content='你好,慕小课!我非常高兴认识你。我喜欢帮助人们回答问题和提供信息。游泳和打球都是很有趣的运动!你最喜欢哪种类型的泳或球类运动呢?', response_metadata={'token_usage': {'completion_tokens': 51, 'prompt_tokens': 171, 'total_tokens': 222}, 'model_name': 'gpt-4o-mini', 'system_fingerprint': 'fp_80a1bad4c7', 'finish_reason': 'stop', 'logprobs': None}, id='run-caf269a0-2774-4408-b18c-ff35f83de0c9-0', usage_metadata={'input_tokens': 171, 'output_tokens': 51, 'total_tokens': 222})]}

{'messages': [HumanMessage(content='你好,我叫慕小课,我喜欢游泳打球,你喜欢什么呢?', id='44679054-e5e3-4a04-9e6e-a9db63eeac7c'), AIMessage(content='你好,慕小课!我非常高兴认识你。我喜欢帮助人们回答问题和提供信息。游泳和打球都是很有趣的运动!你最喜欢哪种类型的泳或球类运动呢?', response_metadata={'token_usage': {'completion_tokens': 51, 'prompt_tokens': 171, 'total_tokens': 222}, 'model_name': 'gpt-4o-mini', 'system_fingerprint': 'fp_80a1bad4c7', 'finish_reason': 'stop', 'logprobs': None}, id='run-caf269a0-2774-4408-b18c-ff35f83de0c9-0', usage_metadata={'input_tokens': 171, 'output_tokens': 51, 'total_tokens': 222}), HumanMessage(content='你知道我叫什么吗?', id='3c04b48f-b6ff-469b-b6e7-04e7435e349b'), AIMessage(content='当然,你叫慕小课!你还有其他想分享的吗?', response_metadata={'token_usage': {'completion_tokens': 16, 'prompt_tokens': 235, 'total_tokens': 251}, 'model_name': 'gpt-4o-mini', 'system_fingerprint': 'fp_80a1bad4c7', 'finish_reason': 'stop', 'logprobs': None}, id='run-0c337a5b-94f5-4656-9a8a-8f270a901ca9-0', usage_metadata={'input_tokens': 235, 'output_tokens': 16, 'total_tokens': 251})]}
2
3
# 02. LangGraph其他检查点
在 LangGraph 中,除了封装了 MemorySaver 基于 临时内存 的检查点,还封装了基于 Postgres 、 MongoDB 和 Redis 的检查点。
- LangGraph 持久化文档: https://langchain-ai.github.io/langgraph/how-tos/persistence/
这些检查点的运行流程都一模一样,只是持久化/存储的介质不一样而已,根据存储方式的不同使用不同的实例化方式。
例如使用 Postgres 作为存储介质时,在实例化 PostgresSaver 时,传递 postgres 的连接句柄即可,示例如下:
from psycopg_pool import ConnectionPool

pool = ConnectionPool(

    conninfo=DB_URI,
    max_size=20,
    kwargs=connection_kwargs
)
with pool.connection() as conn:
    checkpointer = PostgresSaver(conn)


    checkpointer.setup()

    graph = create_react_agent(model, tools=tools, checkpointer=checkpointer)
    config = {"configurable": {"thread_id": "1"}}
    res = graph.invoke({"messages": [("human", "旧金山的天气怎么样?")]}, config)
    checkpoint = checkpointer.get(config)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
不过在 LangGraph 中封装的检查点绝大部分场合都不太适合我们的业务,特别是 Postgres 这类持久化的 检查点 ,会在数据库中单独创建一张表(预设好特定字段),有时候这些持久化数据我们希望能够按照自定义的规则进行存储,这个时候也可以考虑实现一个 自定义检查点 ,自定义检查点总共要实现 4 种方法:
.put() :使用其配置和元数据存储检查点。
.put_writes() :存储与检查点相关联的中间写入(即挂起的写入)。
.get_tuple() :使用给定配置( thread_id 和 checkpoint_id )获取检查点元组。
.list() :列出与给定配置和筛选条件匹配的检查点。
由于 checkpoint 检查点目前在 LangGraph 下发布时间不长,并且该功能目前仍然处于 beta 状态,接口随时可能发生更改,所以自定义一个 检查点 相对麻烦,而且不稳定。
在这节课关于 自定义检查点 的使用技巧及解析先不讲解,在 LLMOps 项目开发中,等使用时再来详细讲解,降低大家的掌握难度。
感兴趣的同学可以自行阅读这篇文档了解创建 自定检查点 的相关使用技巧: https://langchain-ai.github.io/langgraph/how-tos/persistence_redis/
# 最新版 LangChain 用法提示
新版 LangChain 更推荐用 LCEL、
Runnable、ChatModel.bind_tools()、结构化输出和 LangGraph 来组织复杂链路;老式Chain、部分AgentExecutor写法可以读懂,但新项目应优先选择更清晰的图或 Runnable 编排。工具调用相关代码要区分两层:模型是否原生支持 tool/function calling,以及业务侧如何定义工具 schema、参数校验、错误兜底和观测日志。
如果示例中的导入路径和你当前安装版本不同,优先查当前版本包内导出位置;常见迁移方向是从
langchain拆到langchain-core、langchain-community、langchain-openai、langgraph等包。
# 拓展
工具或插件不要只看能不能调通,更要看是否可观测、可限流、可重试、可审计。联网类工具还要处理超时、空结果、搜索噪声和结果时效性。
Agent 场景里,Prompt 只是调度策略的一部分;工具描述、参数 schema、历史状态、错误反馈、停止条件和人工介入点同样会影响最终稳定性。
# 常见问题
为什么模型没有调用工具?常见原因是工具描述不清晰、参数 schema 过宽或过窄、用户问题不需要工具、模型本身不支持工具调用,或者工具绑定位置不对。
为什么工具调用后回答仍然不准?先看工具返回是否正确,再看工具结果是否被放回模型上下文,最后检查输出解析、历史消息和异常兜底是否覆盖了真实错误。
# 面试题
解释函数调用、工具调用和 Agent 的区别。
LangChain 中 tool schema 的作用是什么?为什么参数校验对生产环境很重要?
ReACT Agent 和 tool-calling Agent 的核心差异是什么?分别适合什么场景?
LangGraph 相比 LCEL 更适合解决哪些复杂编排问题?
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 工具没有被调用 | 工具描述弱、绑定失败、模型不支持 | 打印绑定后的模型配置,补充工具描述,换用支持工具调用的模型 |
| 参数格式错误 | schema 设计不清晰,模型生成字段不稳定 | 使用 Pydantic/JSON Schema 校验,失败后把错误反馈给模型重试 |
| 联网结果不可用 | 搜索为空、接口超时、命中低质量页面 | 增加超时、重试、结果过滤、来源白名单和降级回答 |
| Agent 循环不停止 | 缺少终止条件或工具返回被误判 | 设置最大迭代次数,记录每轮 thought/action/observation,增加停止规则 |
| 线上难以复现 | 缺少输入、工具请求和模型响应日志 | 给每次调用加 trace id,记录工具入参、出参、耗时和异常 |