# 需求转换图架构的技巧:CRAG 实现
# 01. CRAG 图结构拆解与状态管理
前文中,我们掌握了 CRAG(纠正性索引增强生成) 优化策略,在该优化策略中引入了一个轻量级的评估器用于评估检索到的文档的质量,并根据评估结果触发不同的知识检索动作,其整体运行流程如下:
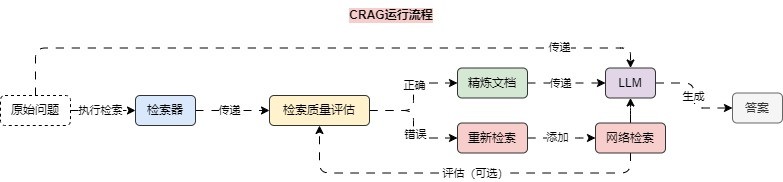
在 CRAG 优化策略中,存在 条件分支 ,即通过 检索质量评估 后,需要条件选择 精炼文档 亦或者是 网络检索 ,所以没办法利用 LCEL 表达式进行构建,判断是使用 LCEL 亦或者 LangGraph 来构建程序的标准如下:
应用是顺序线性,并且无条件分支、无循环,优先考虑 LCEL 表达式;
存在任意条件分支亦或者任意循环,则该部分可以使用 LangGraph 构建,其余部分仍然可以使用 LCEL 表达式进行拼接;
在节点组件较多,并且难以提取出 公共数据状态 的情况下,可以优先使用 LCEL 表达式,然后再使用 LangGraph 改造;
而无论是构建 LCEL 亦或者是 LangGraph 应用,其步骤都是大差不差:
分析使用 LCEL 还是使用 LangGraph 来实现,亦或者是混合使用。
确定整个程序的节点和各个边,涵盖了起点、终点、条件边、循环等。
提炼各个节点之间的公共数据,制作 数据状态 ,确定归纳函数逻辑,亦或者使用覆盖更新的方式。
完成应用程序的各个节点函数,并构建图,添加节点。
按照应用程序的流向为各个节点添加边,从起点开始,直到结束。
编译程序,检测是否需要检查点,是否需要断点等功能。
调用程序并提取输出内容。
# 02. LangGraph 实现示例
在上述的运行流程中,我们将使用 weaviate 向量数据库作为检索器,使用 google_serper 作为网络检索工具,使用 LLM(gpt-4o-mini) 作为检索质量评估器,其实现完整代码:
from typing import TypedDict, Any

import dotenv
import weaviate
from langchain_community.tools import GoogleSerperRun
from langchain_community.utilities import GoogleSerperAPIWrapper
from langchain_core.documents import Document
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.pydantic_v1 import BaseModel, Field
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain_weaviate import WeaviateVectorStore
from langgraph.graph import StateGraph
from weaviate.auth import AuthApiKey

dotenv.load_dotenv()


class GradeDocument(BaseModel):
    """文档评分Pydantic模型"""
    binary_score: str = Field(description="文档与问题是否关联,请回答yes或者no")


class GoogleSerperArgsSchema(BaseModel):
    query: str = Field(description="执行谷歌搜索的查询语句")


class GraphState(TypedDict):
    """图结构应用程序数据状态"""
    question: str
    generation: str
    web_search: str
    documents: list[str]


def format_docs(docs: list[Document]) -> str:
    """格式化传入的文档列表为字符串"""
    return "\n\n".join([doc.page_content for doc in docs])


llm = ChatOpenAI(model="gpt-4o-mini")


vector_store = WeaviateVectorStore(
    client=weaviate.connect_to_wcs(
        cluster_url="https://uiufdvagtjkaf9i4ey0a.c0.us-west3.gcp.weaviate.cloud",
        auth_credentials=AuthApiKey("zGnUn1q5oI3hQUtmqP4NiRty83LNLqDaGoqw"),
    ),
    index_name="LLMOps",
    text_key="text",
    embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
)
retriever = vector_store.as_retriever(search_type="mmr")


system = """你是一名评估检索到的文档与用户问题相关性的评估员。
如果文档包含与问题相关的关键字或语义,请将其评级为相关。
给出一个是否相关得分为yes或者no,以表明文档是否与问题相关。"""
grade_prompt = ChatPromptTemplate.from_messages([
    ("system", system),
    ("human", "检索文档: \n\n{document}\n\n用户问题: {question}"),
])
retrieval_grader = grade_prompt | llm.with_structured_output(GradeDocument)


template = """你是一个问答任务的助理。使用以下检索到的上下文来回答问题。如果不知道就说不知道,不要胡编乱造,并保持答案简洁。

问题: {question}
上下文: {context}
答案: """
prompt = ChatPromptTemplate.from_template(template)
rag_chain = prompt | llm.bind(temperature=0) | StrOutputParser()


rewrite_prompt = ChatPromptTemplate.from_messages([
    (
        "system",
        "你是一个将输入问题转换为优化的更好版本的问题重写器并用于网络搜索。请查看输入并尝试推理潜在的语义意图/含义。"
    ),
    ("human", "这里是初始化问题:\n\n{question}\n\n请尝试提出一个改进问题。")
])
question_rewriter = rewrite_prompt | llm.bind(temperature=0) | StrOutputParser()


google_serper = GoogleSerperRun(
    name="google_serper",
    description="一个低成本的谷歌搜索API。当你需要回答有关时事的问题时,可以调用该工具。该工具的输入是搜索查询语句。",
    args_schema=GoogleSerperArgsSchema,
    api_wrapper=GoogleSerperAPIWrapper(),
)


def retrieve(state: GraphState) -> Any:
    """检索节点,根据原始问题检索向量数据库"""
    print("---检索节点---")
    question = state["question"]
    documents = retriever.invoke(question)
    return {"documents": documents, "question": question}


def generate(state: GraphState) -> Any:
    """生成节点,根据原始问题+上下文内容调用LLM生成内容"""
    print("---LLM生成节点---")
    question = state["question"]
    documents = state["documents"]
    generation = rag_chain.invoke({"context": format_docs(documents), "question": question})
    return {"question": question, "documents": documents, "generation": generation}


def grade_documents(state: GraphState) -> Any:
    """文档与原始问题关联性评分节点"""
    print("---检查文档与问题关联性节点---")
    question = state["question"]
    documents = state["documents"]

    filtered_docs = []
    web_search = "no"
    for doc in documents:
        score: GradeDocument = retrieval_grader.invoke({
            "question": question, "document": doc.page_content,
        })
        grade = score.binary_score
        if grade.lower() == "yes":
            print("---文档存在关联---")
            filtered_docs.append(doc)
        else:
            print("---文档不存在关联---")
            web_search = "yes"
            continue
    return {**state, "documents": filtered_docs, "web_search": web_search}


def transform_query(state: GraphState) -> Any:
    """重写/转换查询节点"""
    print("---重写查询节点---")
    question = state["question"]
    better_question = question_rewriter.invoke({"question": question})
    return {**state, "question": better_question}


def web_search(state: GraphState) -> Any:
    """网络检索节点"""
    print("---网络检索节点---")
    question = state["question"]
    documents = state["documents"]

    search_content = google_serper.invoke({"query": question})
    documents.append(Document(
        page_content=search_content,
    ))

    return {**state, "documents": documents}


def decide_to_generate(state: GraphState) -> Any:
    """决定执行生成还是搜索节点"""
    print("---路由选择节点---")
    web_search = state["web_search"]
    if web_search.lower() == "yes":
        print("---执行Web搜索节点---")
        return "transform_query"
    else:
        print("---执行LLM生成节点---")
        return "generate"


workflow = StateGraph(GraphState)


workflow.add_node("retrieve", retrieve)
workflow.add_node("grade_documents", grade_documents)
workflow.add_node("generate", generate)
workflow.add_node("transform_query", transform_query)
workflow.add_node("web_search_node", web_search)


workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade_documents")
workflow.add_conditional_edges("grade_documents", decide_to_generate)
workflow.add_edge("transform_query", "web_search_node")
workflow.add_edge("web_search_node", "generate")
workflow.set_finish_point("generate")


app = workflow.compile()

print(app.invoke({"question": "能介绍下什么是LLMOps么?"}))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
生成内容:
---检索节点---
---检查文档与问题关联性节点---
---文档不存在关联---
---文档不存在关联---
---文档不存在关联---
---文档不存在关联---
---路由选择节点---
---执行Web搜索节点---
---重写查询节点---
---网络检索节点---
---LLM生成节点---
{'question': '什么是LLMOps,能详细解释它的定义、应用和重要性吗?', 'generation': 'LLMOps(Large Language Model Operations)是管理大型语言模型(LLMs)应用的流程和工具的集合,类似于机器掌握运维(MLOps)。它涵盖了LLMs的开发、部署、维护和优化,主要包括数据分析、实验跟踪、模型管理等功能。\n\n**应用**:LLMOps用于支持LLM的整个生命周期,包括模型的预训练、微调、部署和监测,以提高语言模型的性能和效率。\n\n**重要性**:随着LLM在各个领域的广泛应用,LLMOps的实施可以确保有效的协作、优化资源使用、提高开发效率并降低风险,从而促使LLM项目成功。', 'web_search': 'yes', 'documents': [Document(page_content='LLMOps是Large Language Model Operations的缩写,可以将LLMOps认为是LLMs的MLOps,这也意味着,LLMOps本质上是管理基于LLM的应用的一系列工具和最佳实践 ... LLMOps 的定义\u200b LLMOps 的完整定义是基于大模型的应用程序的生命周期管理平台或者工具。 大模型的构建主要分为三个阶段: 第一个阶段是预训练阶段 在预训 ... LLMOps 平台为开发人员和团队提供了一个促进协作的环境,它涵盖数据分析、实验跟踪、提示词工程和LLM 管理。它还可为LLM 提供受控的模型转换、部署和监控 ... Missing: 定义、 | Show results with:定义、. LLMOps(Large Language Model Operations)是一个涵盖了大型语言模型(如GPT系列)开发、部署、维护和优化的一整套实践和流程。LLMOps 的目标是确保 ... LLMOps是一套用于管理数据,微调和适应模型,部署解决方案,并监控性能以获得最佳语言和掌握模型(LLM)结果的全面工具。 它为数据科学家,工程师和业务用户提供了一个统一 ... 它的简短定义是LLMOps 是LLM 的MLOps。这意味着LLMOps 是一组工具和最佳实践,用于管理LLM 支持的应用程序的生命周期,包括开发、部署和维护。 悟乙己. LLMOps(Large Language Model Operations)是机器掌握运营(MLOps)的演变,专门针对大型语言模型(LLMs)的独特需求和挑战。 LLMOps 超越了MLOps的通用 ... 术语LLMOps代表大语言模型运维,其缩写LLMOps的意思是面向LLM的MLOps,这意味着LLMOps是用于管理LLM驱动的应用程序生命周期(包括开发、部署和维护)的一组 ... 利用MLOps 实现大型语言模型,即LLMOps:多年来,MLOps 已经证明了其增强ML 模型的开发、部署和维护的能力,从而带来更敏捷、更高效的机器掌握系统。 MLOps 方法可以实现 ... 一种视角认为LLMOps 是MLOps 在LLM 场景下的直接迁移。主要使用对象还是算法工作人员。这种视角里认为的LLM 全生命周期更多还是强调训练大模型的过程,对 ...')]}
2
3
4
5
6
7
8
9
10
11
12
# 最新版 LangChain 用法提示
新版 LangChain 更推荐用 LCEL、
Runnable、ChatModel.bind_tools()、结构化输出和 LangGraph 来组织复杂链路;老式Chain、部分AgentExecutor写法可以读懂,但新项目应优先选择更清晰的图或 Runnable 编排。工具调用相关代码要区分两层:模型是否原生支持 tool/function calling,以及业务侧如何定义工具 schema、参数校验、错误兜底和观测日志。
如果示例中的导入路径和你当前安装版本不同,优先查当前版本包内导出位置;常见迁移方向是从
langchain拆到langchain-core、langchain-community、langchain-openai、langgraph等包。
# 拓展
工具或插件不要只看能不能调通,更要看是否可观测、可限流、可重试、可审计。联网类工具还要处理超时、空结果、搜索噪声和结果时效性。
Agent 场景里,Prompt 只是调度策略的一部分;工具描述、参数 schema、历史状态、错误反馈、停止条件和人工介入点同样会影响最终稳定性。
# 常见问题
为什么模型没有调用工具?常见原因是工具描述不清晰、参数 schema 过宽或过窄、用户问题不需要工具、模型本身不支持工具调用,或者工具绑定位置不对。
为什么工具调用后回答仍然不准?先看工具返回是否正确,再看工具结果是否被放回模型上下文,最后检查输出解析、历史消息和异常兜底是否覆盖了真实错误。
# 面试题
解释函数调用、工具调用和 Agent 的区别。
LangChain 中 tool schema 的作用是什么?为什么参数校验对生产环境很重要?
ReACT Agent 和 tool-calling Agent 的核心差异是什么?分别适合什么场景?
LangGraph 相比 LCEL 更适合解决哪些复杂编排问题?
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 工具没有被调用 | 工具描述弱、绑定失败、模型不支持 | 打印绑定后的模型配置,补充工具描述,换用支持工具调用的模型 |
| 参数格式错误 | schema 设计不清晰,模型生成字段不稳定 | 使用 Pydantic/JSON Schema 校验,失败后把错误反馈给模型重试 |
| 联网结果不可用 | 搜索为空、接口超时、命中低质量页面 | 增加超时、重试、结果过滤、来源白名单和降级回答 |
| Agent 循环不停止 | 缺少终止条件或工具返回被误判 | 设置最大迭代次数,记录每轮 thought/action/observation,增加停止规则 |
| 线上难以复现 | 缺少输入、工具请求和模型响应日志 | 给每次调用加 trace id,记录工具入参、出参、耗时和异常 |