# Step-Back Prompting:扩大问题理解范围
先生成更抽象的后退问题,再用抽象问题辅助检索和回答。
# 01. LangChain 少量示例提示模板
在与 LLM 的对话中,提供少量的示例被称为 少量示例,这是一种简单但强大的指导生成的方式,在某些情况下可以显著提高模型性能(与之对应的是零样本),少量示例可以降低 Prompt 的复杂度,快速告知 LLM 生成内容的规范。
在 LangChain 中,针对少量示例也封装对应的提示模板——FewShotPromptTemplate,这个提示模板只需要传递 示例列表 与 示例模板 即可快速构建 少量示例提示模板,使用示例如下:
import dotenv
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, FewShotChatMessagePromptTemplate
from langchain_openai import ChatOpenAI

dotenv.load_dotenv()

# 1.构建示例模板与示例
examples = [
 {"question": "帮我计算下2+2等于多少?", "answer": "4"},
 {"question": "帮我计算下2+3等于多少?", "answer": "5"},
 {"question": "帮我计算下20*15等于多少?", "answer": "300"},
]
example_prompt = ChatPromptTemplate.from_messages([
 ("human", "{question}"),
 ("ai", "{answer}"),
])

# 2.构建少量示例提示模板
few_shot_prompt = FewShotChatMessagePromptTemplate(
 example_prompt=example_prompt,
 examples=examples,
)
print("少量示例模板:", few_shot_prompt.format())

# 3.构建最终提示模板
prompt = ChatPromptTemplate.from_messages([
 ("system", "你是一个可以计算复杂数学问题的聊天机器人"),
 few_shot_prompt,
 ("human", "{question}"),
])

# 4.创建大语言模型与链
llm = ChatOpenAI(model="gpt-3.5-turbo-16k", temperature=0)
chain = prompt | llm | StrOutputParser()

# 5.调用链获取结果
print(chain.invoke("帮我计算下14*15等于多少"))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
输出内容:
少量示例模板: Human: 帮我计算下2+2等于多少?
AI: 4
Human: 帮我计算下2+3等于多少?
AI: 5
Human: 帮我计算下20*15等于多少?
AI: 300
210
2
3
4
5
6
7
少量示例提示模板 在底层会根据传递的 示例模板 与 示例 格式化对应的 消息列表 或者 字符串,从而将对应的示例参考字符串信息添加到完整的提示模板中,简化了 Prompt 编写的繁琐程度。
对于聊天模型可以使用 FewShotChatMessagePromptTemplate,而文本补全基座模型可以使用 FewShotPromptTemplate。
# 02. Step-Back 回答回退策略的优点
对于一些复杂的问题,除了使用 问题分解 来得到子问题亦或者依赖问题,还可以为复杂问题生成一个前置问题,通过前置问题来执行相应的检索,这就是 Setp-Back 回答回退策略(后退提示),这是一种用于增强语言模型的推理和问题解决能力的技巧,它鼓励 LLM 从一个给定的问题或问题后退一步,提出一个更抽象、更高级的问题,涵盖原始查询的本质。
概念来源:https://arxiv.org/pdf/2310.06117.pdf
后退提示背后的概念是,许多复杂的问题或任务包含很多复杂的细节和约束,这使 LLM 难以直接检索和应用相关信息。通过引入一个后退问题,这个问题通常更容易回答,并且围绕一个更广泛的概念或原则,让 LLM 可以更有效地构建它们的推理。
Step-Back 回答回退策略的运行流程也非常简单,构建一个 少量示例提示模板,让 LLM 根据传递的问题生成一个后退问题,使用 后退问题 执行相应的检索,利用检索到的文档+原始问题执行 RAG 索引增强生成,运行流程如下:
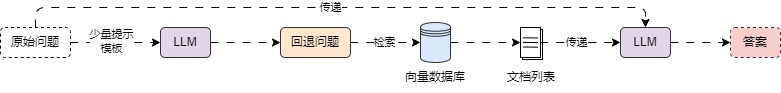
在 LangChain 中并没有封装好的 回答回退策略检索器,所以可以执行相应的封装,实现一个自定义检索器,实现代码如下:
from typing import List

import dotenv
import weaviate
from langchain_core.callbacks import CallbackManagerForRetrieverRun
from langchain_core.documents import Document
from langchain_core.language_models import BaseLanguageModel
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, FewShotChatMessagePromptTemplate
from langchain_core.retrievers import BaseRetriever
from langchain_core.runnables import RunnablePassthrough
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_weaviate import WeaviateVectorStore
from weaviate.auth import AuthApiKey

dotenv.load_dotenv()

class StepBackRetriever(BaseRetriever):
 """回答回退检索器"""
 retriever: BaseRetriever
 llm: BaseLanguageModel

 def _get_relevant_documents(
 self, query: str, *, run_manager: CallbackManagerForRetrieverRun
 ) -> List[Document]:
 """根据传递的query执行问题回退并检索"""
 # 1.构建少量提示模板
 examples = [
 {"input": "慕课网上有关于AI应用开发的内容吗?", "output": "慕课网上有哪些内容?"},
 {"input": "慕小课出生在哪个国家?", "output": "慕小课的个人经历是怎样的?"},
 {"input": "司机可以开快车吗?", "output": "司机可以做什么?"},
 ]
 example_prompt = ChatPromptTemplate.from_messages([
 ("human", "{input}"),
 ("ai", "{output}")
 ])
 few_show_prompt = FewShotChatMessagePromptTemplate(
 examples=examples,
 example_prompt=example_prompt,
 )

 # 2.构建生成回退问题提示
 system_prompt = "你是一个世界知识的专家。你的任务是回退问题,将问题改述为更一般或者前置问题,这样更容易回答,请参考示例来实现。"
 prompt = ChatPromptTemplate.from_messages([
 ("system", system_prompt),
 few_show_prompt,
 ("human", "{question}")
 ])

 # 3.构建生成回退问题的链
 chain = (
 {"question": RunnablePassthrough()}
 | prompt
 | self.llm
 | StrOutputParser()
 | self.retriever
 )

 return chain.invoke(query)

# 1.构建向量数据库与检索器
db = WeaviateVectorStore(
 client=weaviate.connect_to_wcs(
 cluster_url="https://mbakeruerziae6psyex7ng.c0.us-west3.gcp.weaviate.cloud",
 auth_credentials=AuthApiKey("ZltPVa9ZSOxUcfafelsggGyyH6tnTYQYJvBx"),
 ),
 index_name="DatasetDemo",
 text_key="text",
 embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
)
retriever = db.as_retriever(search_type="mmr")

# 2.创建回答回退检索器
step_back_retriever = StepBackRetriever(
 retriever=retriever,
 llm=ChatOpenAI(model="gpt-3.5-turbo-16k", temperature=0),
)

# 3.检索文档
documents = step_back_retriever.invoke("人工智能会让世界发生翻天覆地的变化吗?")
print(documents)
print(len(documents))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
输出内容:
[Document(metadata={'source': './项目API文档.md', 'start_index': 5818.0}, page_content='json { "code": "success", "data": { "list": [ { "id": "1550b71a-1444-47ed-a59d-c2f080fbae94", "conversation_id": "2d7d3e3f-95c9-4d9d-ba9c-9daaf09cc8a8", "query": "能详细讲解下LLM是什么吗?", "answer": "LLM 即 Large Language Model,大语言模型,是一种基于深度掌握的自然语言处理模型,具有很高的语言理解和生成能力,能够处理各式各样的自然语言任务,例如文本生成、问答、翻译、摘要等。它通过在大量的文本数据上进行训练,掌握到语言的模式、结构和语义知识'), Document(metadata={'source': './项目API文档.md', 'start_index': 6359.0}, page_content='1.7 [todo]删除特定的调试消息\n\n接口说明:用于删除 AI 应用调试对话过程中指定的消息,该删除会在后端执行软删除操作,并且只有当会话 id 和消息 id 都匹配上时,才会删除对应的调试消息。\n\n接口信息:授权+POST:/apps/:app_id/messages/:message_id/delete\n\n接口参数:\n\n请求参数:\n\napp_id -> uuid:路由参数,需要删除消息归属的应用 id,格式为 uuid。\n\nmessage_id -> uuid:路由参数,需要删除的消息 id,格式为 uuid。\n\n请求示例:\n\njson { "app_id": "1550b71a-1444-47ed-a59d-c2f080fbae94", "message_id": "2d7d3e3f-95c9-4d9d-ba9c-9daaf09cc8a8" }\n\n响应示例:\n\njson { "code": "success", "data": {}, "message": "删除调试信息成功" }'), Document(metadata={'source': './项目API文档.md', 'start_index': 490.0}, page_content='带有分页数据的接口会在 data 内固定传递 list 和 paginator 字段,其中 list 代表分页后的列表数据,paginator 代表分页的数据。\n\npaginator 内存在 4 个字段:current_page(当前页数) 、page_size(每页数据条数)、total_page(总页数)、total_record(总记录条数),示例数据如下:'), Document(metadata={'source': './项目API文档.md', 'start_index': 2042.0}, page_content='dialog_round -> int:携带上下文轮数,类型为非负整型。\n\nmemory_mode -> string:记忆类型,涵盖长记忆 long_term_memory 和 none 代表无。\n\nstatus -> string:应用配置的状态,drafted 代表草稿、published 代表已发布配置。\n\nupdated_at -> int:应用配置的更新时间。\n\ncreated_at -> int:应用配置的创建时间。\n\nupdated_at -> int:应用的更新时间。\n\ncreated_at -> int:应用的创建时间。\n\n响应示例:')]
4
2
对比 问题分解策略,回答回退策略 仅仅多调用一次 LLM,所以相应速度更快,性能更高,并且复杂度更低,对于一些参数量较小的模型,也可以实现不错的效果,对于 问题分解策略-迭代式回答,再一些极端的情况下,模型输出了有偏差的内容,每次都在有偏差的 问题+答案 生成新内容,很有可能会导致最后的输出完全偏离开始的预设。
就像早些年很火的 谷歌翻译将同一句话翻译20次,输出的内容就完全偏离了原来的预设:
原文:吕布拜义父。
使用谷歌翻译20次后:在这个世界上,还有很多儿子等着我去当。
2
本质上就是因为无论是 谷歌翻译 还是 LLM大语言模型,执行转换操作时,信息产生了丢失,并且随着迭代的增加,信息丢失得越来越多。
# 最新版 LangChain 用法提示
新项目要优先确认组件所在包名。核心抽象通常在 langchain_core,文档分割在 langchain_text_splitters,OpenAI 相关集成在 langchain_openai,大量社区组件在 langchain_community 或独立集成包中。
涉及 Retriever、Runnable、LCEL、LangGraph 的链路,建议用 invoke() / ainvoke() 作为统一调用入口,并把检索参数、路由条件、重排参数和降级策略显式配置出来。不要只照搬旧导入路径。
# 拓展
Step-Back Prompting:扩大问题理解范围 不应该孤立使用。RAG 优化通常要和评测集、召回日志、答案引用、用户反馈、成本统计一起看。只优化某一个环节,可能会让另一个环节退化。
工程上建议把 query、改写后的 query、召回文档、metadata filter、重排得分、最终 Prompt 和模型输出都记录下来。否则问题出现时,很难判断是加载、切分、Embedding、检索、重排、Prompt 还是生成阶段出了问题。
# 常见问题
什么时候需要使用这个策略?
当普通向量检索已经不能稳定命中关键证据,或者复杂问题经常漏召回、召回重复、上下文不完整时,就需要引入该类优化。
它能替代基础 RAG 链路吗?
不能。优化策略依赖基础链路。文档质量、chunk 设计、Embedding 模型、metadata 规范和 Retriever 配置没有打好,后续策略只能缓解,不能根治。
如何判断优化是否有效?
用固定评测集对比优化前后:召回命中率、答案正确率、引用正确率、拒答准确率、延迟和成本。只看单个 demo 很容易误判。
# 面试题
RAG 优化应该从哪里开始?
先定位问题阶段:文档是否解析正确、chunk 是否完整、Embedding 是否适合、检索是否命中、上下文是否可用、模型是否按证据回答。定位后再选择对应策略。
为什么复杂 RAG 系统需要可观测性?
因为答案错误可能来自任意环节。没有检索日志、重排分数、Prompt 和输出记录,就只能靠猜。
如何避免优化策略越加越乱?
每个策略都要有触发条件、输入输出、评测指标和降级方案。能用简单策略解决的问题,不要过早引入复杂链路。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 优化后更慢 | 多路检索、重排或图分支增加调用次数 | 增加超时、缓存、并行和候选裁剪 |
| 召回更多但更乱 | 多查询或混合检索没有去重和重排 | 使用 RRF、rerank、source_id 去重 |
| 答案仍然无依据 | 上下文质量低或 Prompt 没有约束证据 | 增加引用要求、拒答策略和证据检查 |
| 成本上涨明显 | 过多 LLM 改写、摘要或评估调用 | 缓存中间结果,限制触发条件 |
| 线上效果不稳定 | 缺少评测集和回归流程 | 固化 golden set,发布前跑回归 |