# LangChain 记忆持久化与第三方集成:从 ChatMessageHistory 到 Checkpointer 和 Store
记忆如果只存在进程内存里,就不能算真正可用。
本地 demo 里,一个全局变量、一个 InMemoryChatMessageHistory、一个内存 checkpointer 就能让模型回答“我刚才说过什么”。但到了 Web API、Flask 服务、多实例部署、容器重启、用户多会话并发时,这些内存状态都会变得不可靠。
记忆持久化要解决的是:会话历史、摘要、实体事实、长期偏好、Agent 中间状态,到底保存到哪里,怎么按用户和会话隔离,服务重启后怎么恢复,用户删除记忆时怎么清理。
早期 LangChain 的 Memory 组件通常通过 chat_memory 接入第三方消息历史,例如 File、Redis、Postgres、MongoDB、SQLite。当前 LangChain 的新主线则更清晰:
- 普通 LCEL 聊天链:用
ChatMessageHistory或RunnableWithMessageHistory接第三方存储。 - Agent 短期记忆:用 checkpointer 持久化
AgentState。 - 跨会话长期记忆:用 Store 的
namespace/key保存结构化数据。
# 为什么内存记忆不够
Flask 或 FastAPI 这类服务里,一次请求处理完成后,请求上下文会释放。即使进程还在,全局内存也不是可靠存储。
生产里至少会遇到这些情况:
- 服务重启后历史丢失。
- 多个 worker 进程之间内存不共享。
- 多个容器实例之间状态不一致。
- 用户同一时间发起多个请求,消息顺序可能错乱。
- 运维扩缩容后,请求落到不同实例。
- 用户清空历史时,内存和数据库状态不一致。
所以记忆必须有持久化层。这个持久化层可以是文件、Redis、Postgres、MongoDB、SQLite,也可以是 LangGraph checkpointer 或 Store。
但不同数据应该进不同存储,不要把所有东西都塞进一个“聊天历史文件”。
# 旧版 Memory 如何接第三方存储
旧版 Memory 本身不一定负责持久化,它通常把消息历史委托给 chat_memory。
以窗口缓冲记忆为例:
from langchain_classic.memory import ConversationBufferWindowMemory
from langchain_community.chat_message_histories import FileChatMessageHistory


memory = ConversationBufferWindowMemory(
    k=3,
    input_key="query",
    output_key="output",
    return_messages=True,
    chat_memory=FileChatMessageHistory("./storage/memory/chat_history.txt"),
)
2
3
4
5
6
7
8
9
10
11
这段代码的含义是:
ConversationBufferWindowMemory负责窗口策略。FileChatMessageHistory负责把消息历史落到文件。load_memory_variables读取历史并注入 Prompt。save_context把本轮输入输出写回消息历史。
换成 Redis、Postgres、MongoDB 时,整体思路类似:Memory 负责策略,ChatMessageHistory 负责存储。
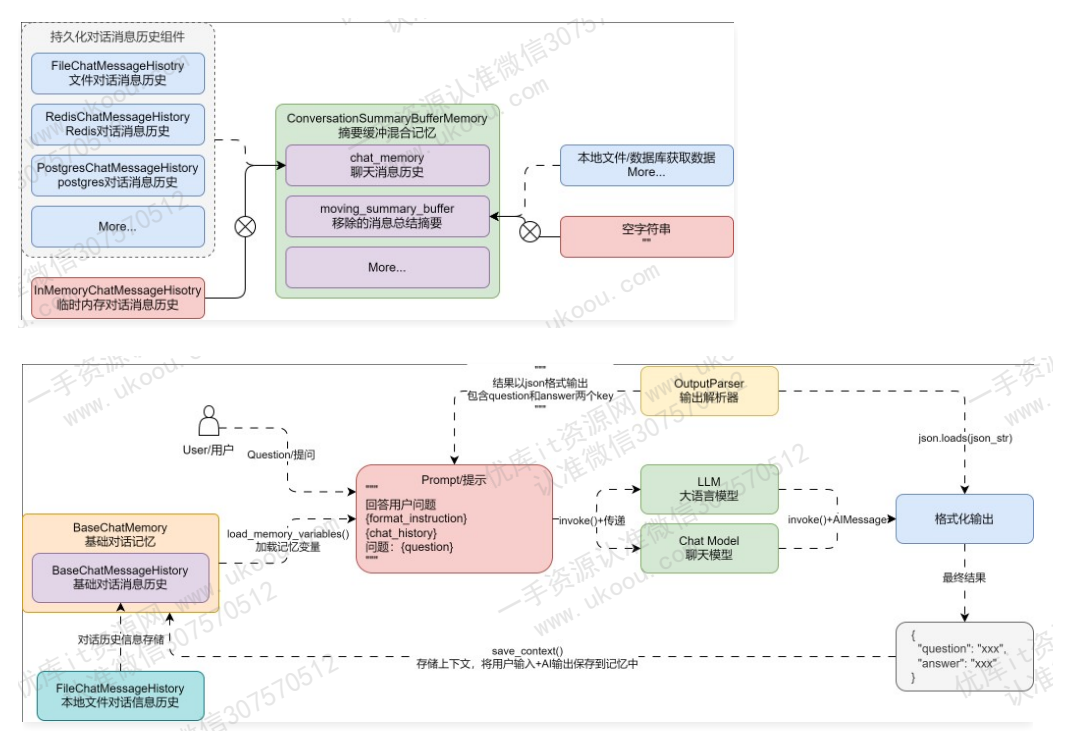
从流程图可以看到,持久化不是模型能力,而是应用层在模型调用前后做的状态读写。第三方 ChatMessageHistory 可以替换内存历史;摘要类 Memory 还需要额外保存摘要字段,例如 moving_summary_buffer。
# 文件持久化适合什么
文件持久化适合掌握、本地调试、单机小工具,不适合正式 Web 服务。
它的优点是简单:
chat_memory=FileChatMessageHistory("./storage/memory/chat_history.txt")
但问题很多:
- 多用户写同一个文件容易串线。
- 并发写入可能破坏文件内容。
- 多实例无法共享本地文件。
- 权限、删除、审计、索引都很弱。
- 不适合存工具消息和复杂 metadata。
如果只是为了理解持久化流程,可以用文件。如果是生产 API,至少用数据库或 Redis。
# Redis、Postgres、MongoDB 怎么选
不同存储适合不同场景。
| 存储 | 适合场景 | 注意点 |
|---|---|---|
| Redis | 短期会话、低延迟、可过期历史 | 持久化、容量、淘汰策略要配置好 |
| Postgres | 审计、查询、长期保存、强一致 | 表结构、索引、迁移、归档要设计 |
| MongoDB | 文档型消息、灵活 metadata | 查询边界和索引要规划 |
| SQLite | 单机工具、本地开发 | 不适合高并发 Web 服务 |
| 文件 | 本地实验 | 不适合生产 |
聊天产品、企业助手、客服系统一般更适合 Postgres 或 MongoDB。短期会话缓存可以用 Redis。Agent checkpoint 如果需要恢复执行状态,应该使用对应的 LangGraph checkpointer,而不是只存聊天消息。
# 普通链路的持久化方式
普通 LCEL 链可以使用 RunnableWithMessageHistory。
from langchain_core.runnables.history import RunnableWithMessageHistory


chain_with_history = RunnableWithMessageHistory(
    chain,
    get_session_history,
    input_messages_key="query",
    history_messages_key="history",
)

result = chain_with_history.invoke(
    {"query": "我刚才说我住在哪?"},
    config={"configurable": {"session_id": "tenant-1:user-42:chat-1001"}},
)
2
3
4
5
6
7
8
9
10
11
12
13
14
关键在 get_session_history。生产里它应该根据当前用户、租户、会话 ID 返回一个持久化 history,而不是全局 dict。
def get_session_history(session_id: str):
    session = session_repo.get_visible_session(
        tenant_id=current_tenant_id(),
        user_id=current_user_id(),
        session_id=session_id,
    )

    if session is None:
        raise PermissionError("session not found")

    return PostgresChatMessageHistory(
        pool=db_pool,
        tenant_id=session.tenant_id,
        session_id=session.session_id,
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
这里的核心不是类名,而是权限边界。前端传来的 session_id 不能直接信任。
# Agent 的最新持久化方式
如果使用 create_agent,短期记忆更推荐 checkpointer。
官方短期记忆文档的主线是:创建 agent 时传入 checkpointer,LangChain 会把短期记忆作为 Agent state 的一部分保存,核心字段是 messages。
本地测试:
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver


agent = create_agent(
    model="gpt-5.5",
    tools=[],
    checkpointer=InMemorySaver(),
)

agent.invoke(
    {"messages": [{"role": "user", "content": "我叫 Alice。"}]},
    {"configurable": {"thread_id": "tenant-1:user-42:chat-1001"}},
)
2
3
4
5
6
7
8
9
10
11
12
13
14
生产使用数据库 backed checkpointer:
from langchain.agents import create_agent
from langgraph.checkpoint.postgres import PostgresSaver


with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()

    agent = create_agent(
        model="gpt-5.5",
        tools=[],
        checkpointer=checkpointer,
    )

    result = agent.invoke(
        {"messages": [{"role": "user", "content": "继续刚才的方案。"}]},
        {"configurable": {"thread_id": "tenant-1:user-42:chat-1001"}},
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
checkpointer 保存的不只是 human/ai 消息,还可能包含工具调用、工具结果、中间状态、自定义 state 字段。复杂 Agent 不应该只靠 ChatMessageHistory 做恢复。
# 长期记忆的持久化方式
跨会话记忆不应该存进当前会话历史。
用户偏好、项目事实、组织规则、稳定画像更适合 LangGraph Store 或业务数据库。
namespace = ("tenants", tenant_id, "users")

store.put(
    namespace,
    user_id,
    {
        "preferences": {
            "answer_style": "production",
            "code_language": "python",
        },
        "facts": {
            "main_stack": "Flask + PostgreSQL",
        },
    },
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
读取时可以在工具里访问 runtime.store:
from dataclasses import dataclass
from typing import Any

from langchain.tools import ToolRuntime, tool


@dataclass
class UserContext:
    tenant_id: str
    user_id: str


@tool
def get_user_memory(runtime: ToolRuntime[UserContext]) -> dict[str, Any]:
    """读取当前用户长期记忆。"""
    assert runtime.store is not None

    namespace = ("tenants", runtime.context.tenant_id, "users")
    item = runtime.store.get(namespace, runtime.context.user_id)

    return item.value if item else {}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
长期记忆最好 schema 化,不要只保存一段自然语言摘要。结构化数据更容易更新、删除、审计和冲突处理。
# 数据分层
生产里建议把记忆数据分层保存:
| 数据 | 生命周期 | 推荐存储 |
|---|---|---|
| 原始消息 | 会话内或审计周期 | 消息表 / ChatMessageHistory |
| Agent state | 当前 thread | LangGraph checkpointer |
| 会话摘要 | 当前 thread | checkpoint state / summary 表 |
| 用户偏好 | 跨 thread | Store / profile 表 |
| 项目事实 | 跨 thread 或项目级 | Store / 业务数据库 |
| 相似历史事件 | 长期 | 向量库 + metadata |
这样做可以避免一个常见错误:用聊天历史表承载所有记忆。聊天历史是原始材料,不是事实库。
# 问题
记忆持久化最大的问题,是“能存”不等于“能生产使用”。
文件、Redis、Postgres、MongoDB 都能存消息,但生产还要解决:
- 多租户、多用户、多会话隔离。
- 并发写入顺序和幂等。
- 服务重启后的恢复。
- 删除、导出、保留周期。
- 敏感信息脱敏和加密。
- 摘要和长期记忆的版本管理。
- 某次回答用了哪些记忆的可观测性。
另外,旧版 Memory 的 chat_memory 只解决消息历史持久化,不等于持久化完整 Agent 状态。如果有工具调用、中间步骤、审批、人机协同、长任务恢复,应该用 checkpointer。
# 拓展
可以从三条线拓展。
第一,消息历史持久化。封装自己的 BaseChatMessageHistory,接 Postgres、Redis 或 MongoDB,服务普通 LCEL 链。
第二,Agent 状态持久化。使用 LangGraph checkpointer 保存完整 thread state,包括 messages、工具结果和自定义字段。
第三,长期记忆持久化。用 Store 或业务数据库保存用户偏好、项目事实、实体记忆和跨会话信息。
更完整的生产架构是:
用户请求
  -> 读取 checkpoint state
  -> 读取持久化 message history
  -> 读取长期 Store
  -> 选择上下文并控制 token
  -> 调用模型
  -> 写回 checkpoint
  -> 写回消息历史
  -> 异步抽取长期记忆
2
3
4
5
6
7
8
9
# 实际生产是否使用
会使用,而且这是记忆模块上线的必要条件。
但生产不会只用文件持久化,也不会只靠旧版 chat_memory。普通聊天链可以用第三方 ChatMessageHistory;Agent 应用要用数据库 checkpointer;用户偏好和项目事实要进 Store 或业务数据库。
文件持久化只适合本地调试。Redis 可以做短期会话和缓存。Postgres 更适合审计、查询、事务和长期保存。MongoDB 适合文档型消息和灵活 metadata。
# 现在是否抛弃
第三方 ChatMessageHistory 没有被抛弃,普通 LCEL 链仍然可以使用。
但旧版 Memory 组件通过 chat_memory 做持久化的方式,已经不是新 Agent 应用的主线。当前 LangChain 更推荐:
- Agent 短期记忆用 checkpointer。
- 长期记忆用 Store。
- 普通链路消息历史用
RunnableWithMessageHistory和BaseChatMessageHistory。
所以被弱化的是“旧 Memory 挂第三方 chat_memory 作为统一记忆方案”,不是持久化能力本身。
# 最新生产如何实现
最新版生产实现建议分三块。
普通聊天历史:
chain_with_history = RunnableWithMessageHistory(
    chain,
    get_session_history,
    input_messages_key="query",
    history_messages_key="history",
)
2
3
4
5
6
Agent 短期记忆:
from langchain.agents import create_agent
from langgraph.checkpoint.postgres import PostgresSaver


with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()

    agent = create_agent(
        model="gpt-5.5",
        tools=[],
        checkpointer=checkpointer,
    )
2
3
4
5
6
7
8
9
10
11
12
跨会话长期记忆:
store.put(
    ("tenants", tenant_id, "users"),
    user_id,
    {
        "preferences": {"answer_style": "production"},
        "facts": {"main_stack": "Flask + PostgreSQL"},
    },
)
2
3
4
5
6
7
8
生产还要补上数据库迁移、连接池、事务、幂等 ID、软删除、加密、保留周期、trace metadata 和权限校验。记忆持久化不是把数据写进去就结束,而是要能恢复、能解释、能删除、能治理。
# 总结
记忆持久化的核心,是把“会话内状态”和“跨会话长期事实”分开保存。
旧版 chat_memory 第三方集成适合理解消息历史持久化,也适合普通 LCEL 链路。当前 Agent 项目更推荐数据库 checkpointer 保存短期 state,用 Store 保存长期记忆。
可以这样记:
- 消息历史:
ChatMessageHistory。 - Agent 状态:checkpointer。
- 长期事实:Store。
- 相似历史:向量库。
- 业务审计:自己的数据库表。
参考: