# LangChain CacheBackedEmbeddings 实践:Embedding 缓存、版本治理与生产落地
在 RAG 系统里,Embedding 是一个很容易被低估的成本点。
用户提问要算查询向量,文档入库要算文档向量,增量更新要重新切分和重新向量化。如果没有缓存,同一段文本在同一个模型、同一套清洗规则下反复计算,不仅浪费钱,也会拖慢入库任务,甚至把外部 Embedding 服务打到限流。
CacheBackedEmbeddings 解决的就是这个问题:它把 Embedding 模型包一层,在真正调用模型前先查缓存。命中就直接返回向量;未命中才调用底层 Embedding 模型,并把新向量写回缓存。
注意名字:当前 LangChain 里的类名是 CacheBackedEmbeddings。有些材料会把它写成 CacheBackEmbedding,理解上问题不大,但写代码时要用复数类名。
# 它解决的核心问题
Embedding 缓存不是为了让 RAG “更聪明”,而是为了让 RAG “更稳定、更便宜、更快”。
它主要解决四类问题:
- 重复计算:同一批文档反复入库时,不必重复调用 Embedding 模型。
- 任务恢复:批处理任务中断后,已经计算过的 chunk 可以直接复用。
- 成本控制:减少外部 Embedding API 调用次数。
- 限流保护:降低批量入库时对模型服务的瞬时压力。
它不能解决这些问题:
- 文档切分不合理。
- Embedding 模型选型不适合业务语义。
- 向量数据库召回效果差。
- Prompt 没有要求模型忠实使用上下文。
- 权限过滤、租户隔离、数据版本治理缺失。
所以不要把 CacheBackedEmbeddings 当成 RAG 效果优化器。它是 Embedding 计算层的缓存包装器。
# 运行流程
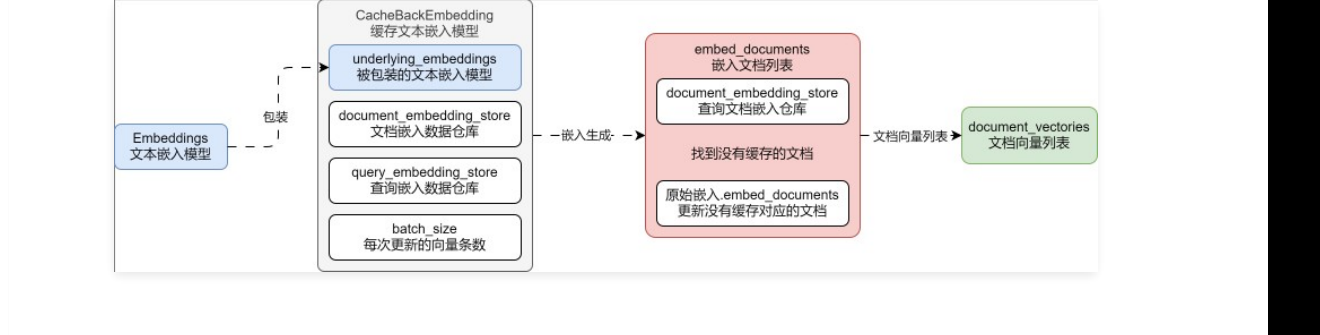
从流程上看,CacheBackedEmbeddings 包住了一个真实的 Embedding 模型,并额外持有两个可能的缓存仓库:
document_embedding_store:缓存文档向量。query_embedding_store:缓存查询向量。
当调用 embed_documents() 时,它会先根据文本生成缓存 key,再批量查询缓存。已经命中的文本直接返回缓存向量;没有命中的文本交给底层 Embedding 模型计算;计算完成后再写入缓存,最后按原始输入顺序返回完整向量列表。
当调用 embed_query() 时,要特别注意:默认不缓存 query embedding。因为用户问题往往短、变化大,而且很多业务并不希望把所有用户查询长期落盘。只有显式配置 query 缓存时,查询向量才会进入缓存。
# 当前 LangChain 的位置
当前官方文档中,Embedding 缓存仍然使用 CacheBackedEmbeddings,但包路径已经偏向 langchain_classic:
from langchain_classic.embeddings import CacheBackedEmbeddings
from langchain_classic.storage import LocalFileStore
2
这说明它仍可用,但它属于 classic 兼容体系。新项目可以使用它做 Embedding 缓存,不过不要误以为它代表 RAG 的完整生产架构。生产里通常还会额外设计数据版本、索引版本、租户隔离、向量库写入状态和回放任务。
官方推荐的初始化方式是 from_bytes_store(),它会把 ByteStore 包装成可存储向量的缓存仓库,并处理序列化、反序列化和 key 编码。
# 基础用法
本地开发可以用 LocalFileStore 快速验证缓存效果:
from langchain.embeddings import init_embeddings
from langchain_classic.embeddings import CacheBackedEmbeddings
from langchain_classic.storage import LocalFileStore


embeddings = init_embeddings("openai:text-embedding-3-small")

store = LocalFileStore("./.cache/embeddings")

cached_embeddings = CacheBackedEmbeddings.from_bytes_store(
    underlying_embedder=embeddings,
    document_embedding_cache=store,
    namespace="openai:text-embedding-3-small:chunk-v1",
    query_embedding_cache=True,
)

vectors = cached_embeddings.embed_documents(
    [
        "LangChain 可以用于构建 RAG 应用。",
        "Embedding 缓存可以减少重复计算。",
    ]
)

query_vector = cached_embeddings.embed_query("Embedding 缓存有什么用?")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
这里有三个重点:
第一,underlying_embedder 才是真正执行向量化的模型。
第二,document_embedding_cache 是缓存存储,可以是本地文件,也可以替换为更可靠的持久化存储。
第三,namespace 不要省略。它是避免缓存污染的关键。
# namespace 为什么必须认真设计
很多线上事故不是因为没加缓存,而是因为缓存 key 设计太粗。
假设你第一次用 text-embedding-3-small 生成向量,后来切到另一个模型,但缓存 key 里没有模型信息,那么同一段文本可能直接命中旧模型的向量。向量维度可能不同,语义空间也不同,轻则召回效果下降,重则写入向量库时报错。
namespace 至少应该包含:
- Embedding provider。
- 模型名。
- 模型版本或发布日期。
- 向量维度。
- 文本清洗版本。
- chunk 策略版本。
- 业务数据域或租户边界。
一个更接近生产的 namespace 可以这样构造:
def build_embedding_namespace(
    provider: str,
    model: str,
    dims: int,
    preprocess_version: str,
    chunk_version: str,
    tenant_id: str,
) -> str:
    return ":".join(
        [
            provider,
            model,
            f"dims-{dims}",
            f"preprocess-{preprocess_version}",
            f"chunk-{chunk_version}",
            f"tenant-{tenant_id}",
        ]
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
这样做的好处是:模型切换、清洗规则变化、chunk 策略变化、租户隔离,都可以通过 namespace 自然隔开。
# 文档缓存和查询缓存的区别
文档向量通常适合缓存。
因为文档入库是批处理场景,文本集合相对稳定,同一份文档可能因为任务重跑、索引重建、环境迁移而多次向量化。缓存文档向量能明显降低成本。
查询向量要谨慎缓存。
用户 query 数量大、变化碎、隐私风险更高,而且很多 query 只出现一次。是否缓存 query,要看业务场景:
| 场景 | 是否建议缓存 query |
|---|---|
| 后台评估集反复运行 | 建议 |
| FAQ 高频标准问法 | 可以 |
| 普通用户开放输入 | 谨慎 |
| 涉及隐私或敏感问题 | 不建议长期缓存 |
| 多租户企业知识库 | 必须先做好租户隔离和脱敏 |
如果只是文档入库加速,可以不打开 query_embedding_cache。如果是评估、压测、重复检索场景,可以打开 query 缓存。
# batch_size 的作用
batch_size 控制多少条文档向量化后写一次缓存。
如果不设置,可能会等一批文本全部处理完再写入。数据量小时问题不大;数据量大时,一旦任务中断,已经算出来但还没写入缓存的向量就会丢掉。
生产批处理建议设置一个合理的 batch_size:
cached_embeddings = CacheBackedEmbeddings.from_bytes_store(
    embeddings,
    store,
    namespace=namespace,
    batch_size=64,
)
2
3
4
5
6
这个值不是越小越好。太小会增加缓存写入频率,拖慢任务;太大则降低断点恢复能力。可以根据 Embedding 服务延迟、单批 chunk 数量、缓存后端吞吐来调。
# 生产里不要只依赖 LocalFileStore
LocalFileStore 很适合本地验证,但生产里通常不够。
它的问题包括:
- 多实例之间无法共享缓存。
- 容器重建后缓存容易丢失。
- 很难做统一 TTL、监控和容量治理。
- 不适合跨机器批处理任务。
生产环境更常见的选择:
- Redis:适合高频缓存、TTL、共享访问。
- PostgreSQL / MySQL:适合强治理、可审计、可查询。
- 对象存储:适合大规模离线缓存和批处理产物。
- 专门的任务表:适合把 embedding job、chunk、cache key、vector index 状态统一管理。
如果只是临时开发环境,用本地文件没问题;如果是线上 RAG 入库链路,缓存最好进入统一基础设施。
# 和向量数据库的关系
Embedding 缓存不是向量数据库。
它缓存的是“文本到向量”的计算结果。向量数据库存的是“向量、文本片段、metadata、索引结构”,用于相似度检索。
两者的关系可以拆成这样:
文档原文
  -> 清洗
  -> 切分 chunk
  -> CacheBackedEmbeddings 计算或读取向量
  -> 写入向量数据库
  -> Retriever 检索
  -> LLM 生成答案
2
3
4
5
6
7
缓存命中只代表“不用重新算向量”,不代表“向量库里已经有这条数据”。生产里还要记录向量库写入状态,否则可能出现缓存里有向量,但索引里没有数据的情况。
# 缓存失效策略
Embedding 缓存最难的不是写进去,而是知道什么时候不能再用。
这些变化都应该触发缓存隔离或失效:
- Embedding 模型变了。
- 模型维度变了。
- 文本清洗规则变了。
- chunk 大小、overlap、分隔符策略变了。
- 文档解析器变了。
- 文档权限范围变了。
- 业务要求重新生成索引。
- 发现旧向量召回质量不达标。
生产里不要依赖人工删目录。更稳的方式是用版本化 namespace,让新旧缓存并存,再通过索引版本切换完成灰度。
# 生产级封装示例
可以把缓存封装在 Embedding 工厂里,业务代码不要到处直接实例化:
from dataclasses import dataclass

from langchain.embeddings import init_embeddings
from langchain_classic.embeddings import CacheBackedEmbeddings
from langchain_classic.storage import LocalFileStore


@dataclass(frozen=True)
class EmbeddingConfig:
    provider_model: str
    dims: int
    preprocess_version: str
    chunk_version: str
    tenant_id: str
    cache_dir: str
    cache_query: bool = False


def build_cached_embeddings(config: EmbeddingConfig):
    embeddings = init_embeddings(config.provider_model)
    store = LocalFileStore(config.cache_dir)

    namespace = ":".join(
        [
            config.provider_model,
            f"dims-{config.dims}",
            f"preprocess-{config.preprocess_version}",
            f"chunk-{config.chunk_version}",
            f"tenant-{config.tenant_id}",
        ]
    )

    return CacheBackedEmbeddings.from_bytes_store(
        underlying_embedder=embeddings,
        document_embedding_cache=store,
        namespace=namespace,
        batch_size=64,
        query_embedding_cache=config.cache_query,
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
真实线上可以把 LocalFileStore 换成 Redis、MongoDB、对象存储或自研 ByteStore。关键是外层调用不变,底层缓存后端可以替换。
# 可观测性
Embedding 缓存上线后,要能回答这些问题:
- 本次入库命中率是多少?
- 有多少文本实际调用了 Embedding 模型?
- 缓存写入失败是否会影响主流程?
- 每个租户的缓存占用是多少?
- 当前索引用的是哪个 embedding namespace?
- query 缓存是否包含敏感输入?
- 缓存命中后召回质量是否下降?
建议至少记录:
embedding_modelembedding_namespacecache_hit_countcache_miss_countcache_hit_ratebatch_sizevector_dimensionindex_versiontenant_iddocument_id
没有这些指标,缓存会从优化手段变成排障黑盒。
# 问题
CacheBackedEmbeddings 最常见的问题有五个。
第一,只缓存文本,不记录模型和处理版本。这样模型切换后容易命中旧向量。
第二,把 query 缓存默认打开,却没有考虑用户隐私、租户隔离和 TTL。
第三,把 Embedding 缓存和向量库索引状态混为一谈。缓存命中不等于向量库写入成功。
第四,只在本地文件里缓存,线上多实例无法共享,容器重启后缓存丢失。
第五,没有命中率和成本指标,无法判断缓存到底有没有收益。
# 拓展
可以把 Embedding 缓存扩展成完整的索引流水线:
- 文档解析层记录 parser 版本。
- chunk 层记录 chunk 策略版本。
- Embedding 层记录模型、维度和 namespace。
- VectorStore 层记录 index version。
- Retriever 层记录召回参数。
- 评估层记录固定问题集上的召回率和答案忠实性。
这样缓存不再只是一个工具类,而是 RAG 数据工程的一部分。
# 实际生产是否使用
会使用,但不一定直接裸用 LocalFileStore + CacheBackedEmbeddings。
在小型项目或离线入库任务里,CacheBackedEmbeddings 很方便,几行代码就能减少重复计算。在大型生产系统里,团队更常见的做法是把它的思想沉到数据管道里:显式维护 chunk 表、embedding job 表、cache key、向量版本和索引状态。
也就是说,生产里一定会做 Embedding 缓存或去重,但实现形态可能不是一个简单的本地文件缓存。
# 现在是否抛弃
没有完全抛弃。
官方文档仍然保留 CacheBackedEmbeddings,并说明可以用它缓存 document embeddings,也可以显式打开 query embeddings 缓存。不过它当前位于 langchain_classic 体系,说明它更像一个兼容且实用的组件,而不是新架构里唯一推荐的 RAG 数据治理方案。
如果你已经在用它,可以继续用,但要补上 namespace、版本、隐私和观测。如果是新生产系统,不要只围绕这个类设计架构,而要把 Embedding 缓存纳入完整的 ingestion pipeline。
# 最新生产如何实现
当前更推荐的生产实现是分层治理:
第一层,Embedding 模型通过 init_embeddings() 或供应商 SDK 统一初始化,模型名、维度、供应商进入配置中心。
第二层,缓存 key 或 namespace 显式包含模型、维度、清洗版本、chunk 版本、租户和数据域。
第三层,文档向量默认缓存,query 向量按场景决定是否缓存,并设置 TTL、脱敏和租户隔离。
第四层,向量库写入状态单独记录,不用 Embedding 缓存替代索引状态。
第五层,所有批处理任务支持断点恢复、命中率统计、失败重试和索引版本回滚。
如果仍使用 LangChain 封装,可以这样落地:
from langchain.embeddings import init_embeddings
from langchain_classic.embeddings import CacheBackedEmbeddings
from langchain_classic.storage import LocalFileStore


embeddings = init_embeddings("openai:text-embedding-3-small")

cached_embeddings = CacheBackedEmbeddings.from_bytes_store(
    underlying_embedder=embeddings,
    document_embedding_cache=LocalFileStore("./.cache/embeddings"),
    namespace="openai:text-embedding-3-small:dims-1536:preprocess-v3:chunk-v2",
    batch_size=64,
    query_embedding_cache=False,
)
2
3
4
5
6
7
8
9
10
11
12
13
14
如果系统规模继续变大,就把 LocalFileStore 换成共享持久化存储,并把 namespace、索引版本、任务状态写入业务数据库。
# 总结
CacheBackedEmbeddings 的价值在于减少重复 Embedding 计算,让 RAG 入库和检索链路更省钱、更稳定、更容易恢复。
但它真正能不能在线上发挥作用,取决于缓存 key、namespace、版本治理、query 隐私、向量库状态和观测指标。只会写 from_bytes_store() 还不够;能把它放进完整的数据管道,才算真的掌握了 Embedding 缓存。
参考: