# LangChain Memory 运行流程与分类:从旧版组件到当前记忆架构
在 LLM 应用里,“记忆”听起来像一个单独组件,实际更像一套上下文读写机制。
用户发来问题之前,系统要决定从哪里加载历史;模型回答之后,系统要决定保存什么;下一轮请求到来时,系统又要把合适的历史、摘要、偏好或状态放回上下文。这个过程如果没有设计好,聊天机器人就会出现两类常见问题:该记的记不住,不该记的乱记一堆。
LangChain 早期提供过一批 Memory 组件,例如 ConversationBufferMemory、ConversationBufferWindowMemory、ConversationSummaryMemory。这些组件很适合理解记忆模式,但对新项目来说,不能再把它们当成唯一主线。当前 LangChain Agent 的短期记忆更推荐使用 LangGraph checkpointer 和 thread_id;长期记忆则使用 store、namespace 和 key 做跨会话持久化。
所以这篇会分两层讲:
- 先讲旧版 Memory 组件的运行流程和分类,因为它能帮助理解记忆系统的底层动作。
- 再讲当前生产项目里应该如何把这些模式迁移成 state、checkpointer、store、摘要、裁剪和长期记忆治理。
# Memory 到底做了什么
一次带记忆的调用,通常包含两个阶段。
第一个阶段发生在模型调用前:读取历史,把历史转换成 Prompt 变量。
第二个阶段发生在模型调用后:保存本轮输入和输出,让下一轮可以使用。
可以抽象成这样:
用户输入
  -> load memory variables
  -> Prompt
  -> Model
  -> OutputParser
  -> save context
  -> 下一轮继续使用
2
3
4
5
6
7
这也是旧版 BaseMemory 的核心思想:通过 load_memory_variables 把记忆加载到链路输入里,通过 save_context 把本轮上下文写回记忆。
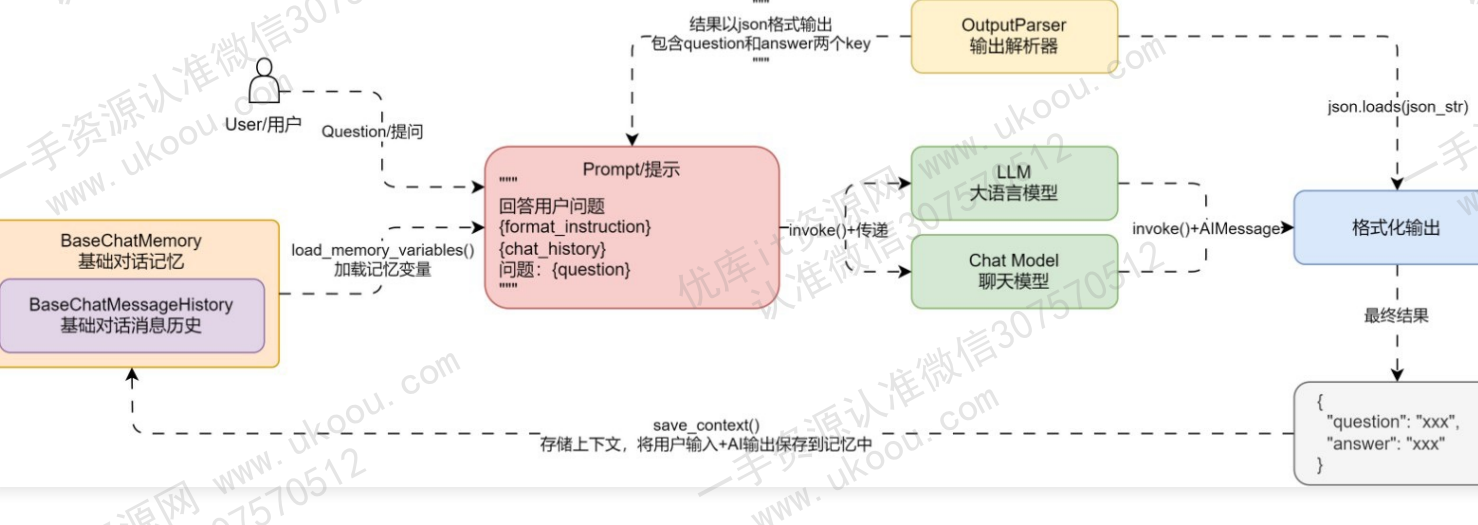
从流程图可以看到,Memory 并不是替模型“自动记住”东西,而是在模型调用前后做上下文搬运:调用前把 chat_history 等变量注入 Prompt,调用后把用户输入和模型输出保存回记忆容器。
# 旧版 Memory 的核心接口
早期 Memory 组件大多围绕几个接口工作:
memory_variables:告诉 chain 会额外注入哪些变量。load_memory_variables:在调用前加载记忆变量。save_context:在调用后保存输入输出。clear:清空记忆。- 对应异步方法:例如
aload_memory_variables、asave_context、aclear。
这些接口的设计非常直观,但也有天然局限:它更适合线性 Chain,而不是复杂 Agent 状态机。
例如一个普通问答链路可以使用:
memory_variables = ["chat_history"]

inputs = {
    "question": "我叫什么?"
}

memory_values = memory.load_memory_variables(inputs)

chain_inputs = {
    **inputs,
    **memory_values,
}

answer = chain.invoke(chain_inputs)

memory.save_context(
    inputs={"question": "我叫什么?"},
    outputs={"answer": answer},
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
这个流程说明了 Memory 的本质:它负责在 chain 输入和外部历史之间做桥接。
# 旧版组件分类视角
旧版 LangChain Memory 组件可以按职责分成几类。
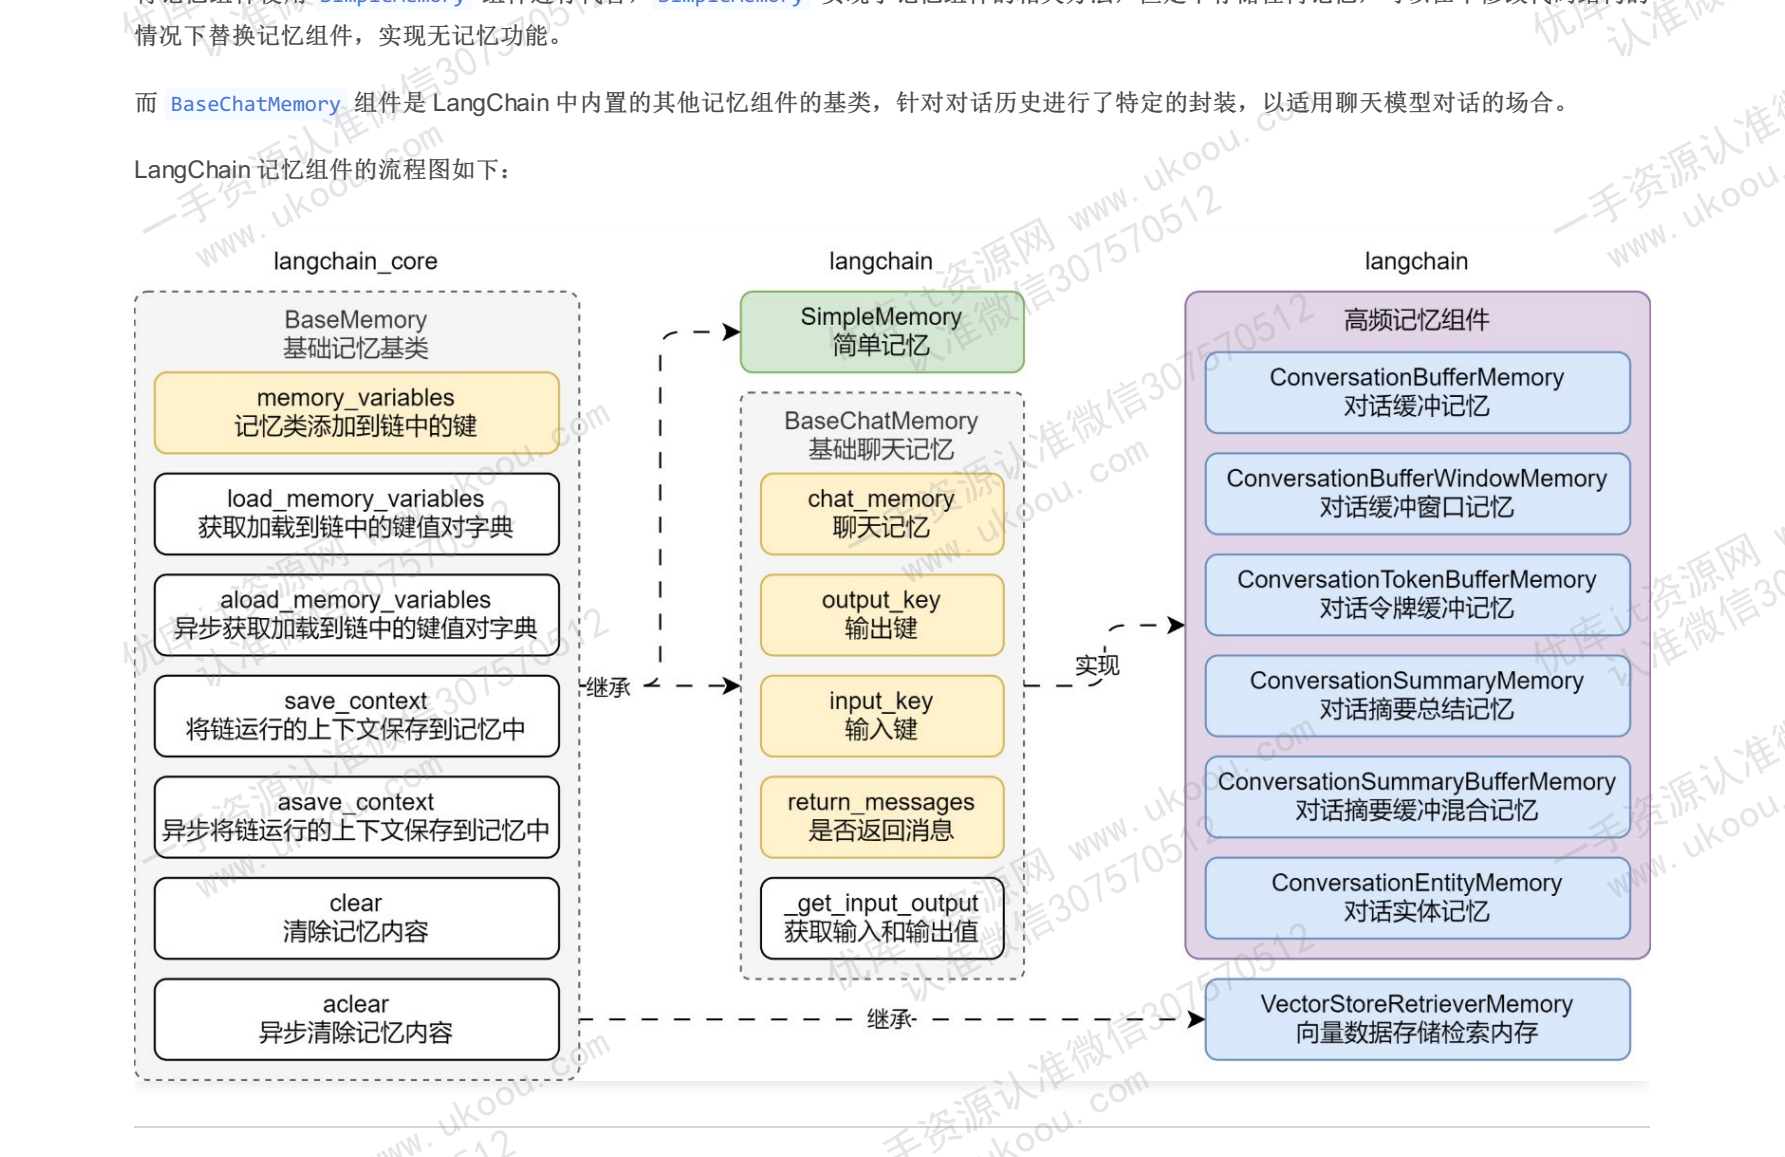
这张图适合用来理解历史 API 的分类,但新项目不要直接照着类名选型。尤其是 ConversationBufferMemory 这类组件,在当前 LangChain 体系里更应该被理解成一种“模式”,而不是默认实现。
常见模式包括:
| 模式 | 核心思路 | 适合场景 | 主要风险 |
|---|---|---|---|
| Buffer memory | 保存完整对话历史 | 短会话、本地验证 | 历史无限增长 |
| Window memory | 只保留最近 N 轮 | 普通聊天、成本敏感 | 早期关键信息被裁掉 |
| Token buffer memory | 按 token 上限裁剪 | 上下文预算明确 | 需要 token 统计 |
| Summary memory | 用摘要压缩早期历史 | 长会话、任务连续推进 | 摘要可能失真 |
| Summary buffer memory | 摘要 + 最近原文 | 较长对话 | 实现和评估复杂 |
| Entity memory | 围绕实体记录信息 | CRM、项目助手 | 实体消歧和冲突处理 |
| Vector memory | 语义检索历史片段 | 回忆相似事件 | 不适合精确偏好更新 |
这些分类现在仍然有价值,但价值在于帮助你设计记忆策略,而不是强迫你使用旧类。
# Buffer memory:最简单,也最危险
Buffer memory 会把完整对话历史保存下来,每次调用时全部塞回 Prompt。
优点是简单:
history = [
    ("human", "我叫 Alice。"),
    ("ai", "你好 Alice。"),
    ("human", "我喜欢 Python 示例。"),
]
2
3
4
5
缺点也非常明显:
- token 成本不断增长。
- 历史越长,模型越容易被无关内容干扰。
- 过期信息会持续影响回答。
- 敏感内容可能被反复带入模型调用。
生产里,Buffer memory 只适合短会话或本地验证。只要会话可能持续很多轮,就要加入窗口、摘要、裁剪或结构化状态。
# Window memory:保留最近上下文
Window memory 只保留最近 N 轮消息。
def keep_recent_turns(messages: list[dict], max_turns: int = 8) -> list[dict]:
    return messages[-max_turns * 2:]
2
这种方式适合大多数普通聊天,因为用户当前问题通常依赖最近几轮。
但它的风险是:关键背景可能出现在很早之前。例如用户第一轮说明“这个项目是金融系统,必须保守回答”,后面如果窗口裁掉这句话,模型就可能忘记重要约束。
所以 Window memory 更适合和摘要或结构化状态配合:
长期摘要 + 最近 N 轮消息 -> 当前上下文
# Token buffer memory:按预算裁剪
按轮数裁剪不够精确,因为每轮消息长度差异很大。
一条工具返回可能几千 token,一句普通回答只有几十 token。Token buffer memory 的思路是按 token 上限保留历史。
伪代码:
def trim_by_token_budget(messages, count_tokens, max_tokens: int):
    selected = []
    total = 0

    for message in reversed(messages):
        tokens = count_tokens(message.content)
        if total + tokens > max_tokens:
            break

        selected.append(message)
        total += tokens

    return list(reversed(selected))
2
3
4
5
6
7
8
9
10
11
12
13
生产里上下文预算应该拆开:
- system prompt 预算。
- 当前用户问题预算。
- RAG 上下文预算。
- 历史消息预算。
- 工具结果预算。
- 输出 token 预算。
不要让历史消息挤掉真正回答问题所需的 RAG 上下文。
# Summary memory:把历史压缩成摘要
Summary memory 会把较早对话压缩成摘要。
例如:
较早对话摘要:
用户正在开发 Flask 后端项目,使用 SQLAlchemy 和 Alembic 管理数据库。
用户偏好 Python 示例,希望回答更偏生产实践。
2
3
然后再加最近几轮原文:
较早对话摘要 + 最近 6 轮消息 + 当前问题
摘要方式适合长会话,但要注意三个问题。
第一,摘要可能丢信息。模型压缩历史时会省略一些它认为不重要、但业务上重要的细节。
第二,摘要可能带偏见。模型可能把用户临时表达误写成稳定偏好。
第三,摘要要可追踪。最好保存摘要覆盖的消息范围、生成时间、模型名和摘要版本。
生产里可以把摘要当成派生数据,而不是唯一事实来源。原始消息仍然要按保留策略归档。
# Entity memory:围绕实体组织上下文
Entity memory 不以消息轮次为中心,而是以实体为中心。
例如用户、项目、订单、系统、服务、客户都可以是实体。
{
  "entity_type": "project",
  "entity_id": "billing-service",
  "facts": {
    "language": "Python",
    "framework": "Flask",
    "database": "PostgreSQL",
    "migration_tool": "Alembic"
  }
}
2
3
4
5
6
7
8
9
10
适合:
- 企业助手。
- 项目助手。
- CRM 助手。
- 工单助手。
- 多对象、多关系场景。
难点是实体识别和冲突处理。例如“支付系统”“支付服务”“billing-service”到底是不是同一个对象,需要明确的实体消歧策略。
# Vector memory:用语义检索回忆历史
Vector memory 会把历史消息、事件摘要或处理结论写入向量库,在需要时按语义召回。
适合:
- “上次类似问题怎么处理的?”
- “之前我们讨论过的迁移方案是什么?”
- “有没有相似的故障案例?”
不适合:
- 精确用户偏好。
- 权限规则。
- 最新状态。
- 必须强一致的数据。
向量库擅长相似召回,不擅长精确更新。用户偏好、项目配置、权限状态应该放在结构化存储里,而不是只写向量库。
# 当前 LangChain 应该怎么做
当前 LangChain 里,记忆可以按 scope 拆成两类。
短期记忆是 thread-scoped memory,作用于一个会话线程。Agent 场景中,通常通过 checkpointer 保存 state。
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver


agent = create_agent(
    model="openai:gpt-4o-mini",
    tools=[],
    checkpointer=InMemorySaver(),
)

config = {"configurable": {"thread_id": "thread_001"}}

agent.invoke(
    {"messages": [{"role": "user", "content": "我叫 Alice。"}]},
    config,
)

agent.invoke(
    {"messages": [{"role": "user", "content": "我叫什么?"}]},
    config,
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
长期记忆是 cross-thread memory,作用于用户、租户、项目或组织。它应该通过 store 按 namespace 和 key 保存结构化数据。
namespace = ("user_memories", user_id)
key = "preferred_code_language"
value = {
    "language": "python",
    "source": "user_explicit",
}

store.put(namespace, key, value)
2
3
4
5
6
7
8
这和旧版 ConversationBufferMemory 不是一回事。旧版 Memory 更多关注 chain 调用前后的上下文变量;当前 Agent 记忆更关注 state、checkpoint、store、namespace 和上下文工程。
# 新旧模式怎么映射
可以这样理解迁移关系:
| 旧版模式 | 当前更推荐的设计 |
|---|---|
| ConversationBufferMemory | thread state 中的 messages |
| ConversationBufferWindowMemory | 消息裁剪 / summarization middleware |
| ConversationTokenBufferMemory | 基于 token budget 的上下文裁剪 |
| ConversationSummaryMemory | 会话摘要字段或 summary middleware |
| EntityMemory | 结构化 store / 数据库实体表 |
| VectorStoreRetrieverMemory | 长期记忆向量检索 / 事件回忆 |
| CombinedMemory | 多来源 context engineering |
如果你维护的是旧项目,可以逐步迁移,不需要一刀切重写。
迁移顺序建议:
- 先把记忆读写封装到自己的模块里,不让业务代码直接依赖旧类。
- 再区分短期会话历史和长期用户记忆。
- Agent 链路改用 checkpointer 管理 thread state。
- 长期偏好和事实迁入结构化 store。
- 相似历史事件再接向量检索。
- 最后加上摘要、裁剪、冲突检测和删除能力。
# 生产运行流程
生产里的记忆流程可以拆成读路径和写路径。
读路径:
收到请求
  -> 识别用户、租户、thread
  -> 读取短期 state
  -> 读取长期偏好和事实
  -> 检索相关历史事件
  -> 做 token 预算和排序
  -> 注入模型上下文
2
3
4
5
6
7
写路径:
模型完成回答
  -> 保存 thread state
  -> 抽取候选长期记忆
  -> 过滤敏感信息
  -> 做冲突检测
  -> 写入 store 或等待用户确认
2
3
4
5
6
读路径要快,不能拖慢用户请求。写路径可以异步,尤其是长期记忆抽取和冲突检测,不一定要阻塞本次回答。
# 记忆分类的生产边界
做分类时,不要只按组件名分,而要按业务边界分。
| 分类 | 生命周期 | 存储 | 注入方式 |
|---|---|---|---|
| 最近消息 | 当前 thread | checkpointer / message table | 直接作为 messages |
| 会话摘要 | 当前 thread | state / summary table | system 或上下文字段 |
| 用户偏好 | 跨 thread | structured store | 按 key 读取 |
| 项目事实 | 跨 thread / project | database | 按 project_id 读取 |
| 历史事件 | 跨 thread | vector store + metadata | 语义召回 |
| 团队流程 | 长期 | config / store | 按任务类型读取 |
这样分类比“用了哪个 Memory 类”更接近生产。
# 常见坑
# 把历史消息等同于记忆
历史消息只是原始材料。真正的长期记忆应该经过抽取、确认、去重和更新。
# 每轮都把全部记忆注入 Prompt
记忆召回要按任务相关性和 token 预算控制。无关记忆越多,模型越容易分心。
# 用向量库保存所有东西
向量库不是万能记忆库。偏好、权限、配置、最新状态更适合结构化存储。
# 不处理冲突
用户偏好会变,项目事实会变,历史结论也可能被推翻。只追加不更新,会让记忆越来越脏。
# 没有删除能力
用户要求清空记忆时,系统必须能做到。没有删除能力的记忆系统不适合生产。
# 还在新项目里直接照搬旧 Memory 类
旧类适合理解模式和维护旧项目。新 Agent 应用应优先使用 checkpointer、state、store 和上下文工程。
# 生产 Checklist
上线前至少检查:
- 是否区分短期记忆和长期记忆。
- 是否区分 messages、summary、preferences、events、procedures。
- 是否有 thread_id / user_id / tenant_id 隔离。
- 是否有 token 预算和裁剪策略。
- 是否有摘要生成和摘要版本。
- 是否有长期记忆写入白名单。
- 是否有敏感信息过滤。
- 是否有冲突检测和更新策略。
- 是否支持删除和过期。
- 是否能追踪某次回答使用了哪些记忆。
- 是否能统计记忆命中率、错误率和成本。
这些做好以后,记忆模块才不是一个“把历史拼进去”的小功能,而是一套可治理的上下文系统。
# 小结
LangChain 旧版 Memory 组件的核心流程,是在模型调用前加载记忆变量,在模型调用后保存上下文。Buffer、Window、Token Buffer、Summary、Entity、Vector 等模式,仍然适合理解记忆系统的设计空间。
但当前生产项目不能只停在旧类上。Agent 短期记忆更适合用 checkpointer 管理 thread state;长期记忆更适合用 store、namespace、key、向量检索和结构化数据库协同实现。
真正好的记忆系统,不是“记得越多越好”,而是能在合适的时间读取合适的上下文,并且能更新、删除、审计和解释。这样 AI 助手才会越用越顺,而不是越记越乱。
# 问题
旧版 Memory 分类的问题,是它容易让人按类名选型,而不是按业务边界设计。
ConversationBufferMemory、ConversationSummaryMemory、ConversationEntityMemory 这些名字看起来像可直接拼装的模块,但生产系统真正要解决的是:消息怎么保存、上下文怎么裁剪、摘要怎么评估、长期事实怎么治理、用户如何删除记忆、某次回答到底用了哪些记忆。
如果只套旧组件,常见问题包括:
- 短期历史和长期事实混在一起。
- 全量历史进入 Prompt,成本和干扰不断上升。
- 摘要、实体、向量记忆缺少更新和冲突处理。
- 多用户、多租户、多 thread 隔离不清晰。
- 记忆写入不可解释,出了错很难回放。
所以 1-6 这篇的重点不是“哪个类怎么调用”,而是理解记忆读写流程和分类边界。
# 拓展
可以把 Memory 分类拓展成一套上下文系统:
messages:当前 thread 的原始消息。summary:当前 thread 的滚动摘要。facts:跨 thread 的结构化事实。preferences:用户稳定偏好。events:可检索的历史事件。procedures:团队流程、回答风格、业务规则。
新版架构里,这些内容不一定由一个 Memory 类管理,而是由 checkpointer、Store、数据库、向量库、middleware 和业务服务共同完成。
更接近生产的流程是:
请求进入
  -> 读取 thread state
  -> 读取长期 Store
  -> 检索相关事件
  -> 做 token 预算和上下文选择
  -> 调用模型
  -> 保存 checkpoint
  -> 异步抽取长期记忆
2
3
4
5
6
7
8
# 实际生产是否使用
会使用这些记忆模式,但不会按旧版 Memory 类原样堆系统。
生产里仍然会有 Buffer、Window、Token Buffer、Summary、Entity、Vector 这些策略,只是实现位置变了:短期状态交给 checkpointer,长对话压缩交给 middleware,长期事实交给 Store 或业务数据库,相似历史交给向量检索。
换句话说,生产使用的是这些“模式”,不是依赖这些旧“类”。
# 现在是否抛弃
没有完全抛弃,但旧版 Memory 组件已经不是新项目主线。
当前 LangChain v1 的官方主线是:
- 短期记忆:
create_agent + checkpointer + thread_id。 - 消息裁剪:
before_modelmiddleware、trim_messages、RemoveMessage。 - 摘要压缩:
SummarizationMiddleware。 - 长期记忆:Store 的
namespace/keyJSON 数据。
旧版 Memory 类更多适合掌握原理、维护老项目和迁移过渡。
# 最新生产如何实现
最新版生产实现应该先拆 scope。
短期记忆:
from langchain.agents import create_agent
from langgraph.checkpoint.postgres import PostgresSaver


with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    checkpointer.setup()

    agent = create_agent(
        model="gpt-5.5",
        tools=[],
        checkpointer=checkpointer,
    )

    agent.invoke(
        {"messages": [{"role": "user", "content": "我正在做 Flask 项目。"}]},
        {"configurable": {"thread_id": "tenant-1:user-42:chat-1001"}},
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
长期记忆:
namespace = ("tenants", tenant_id, "users")
store.put(
    namespace,
    user_id,
    {
        "preferences": {"answer_style": "production"},
        "facts": {"main_stack": "Python Flask"},
    },
)
2
3
4
5
6
7
8
9
上下文治理放在 middleware 或业务编排层:裁剪 messages、生成 summary、召回 Store、过滤敏感内容、记录 trace。这样记忆系统才可扩展、可删除、可观测。
参考: