# 向量数据库是什么:从语义搜索到 AI 应用存储
# 原始图示
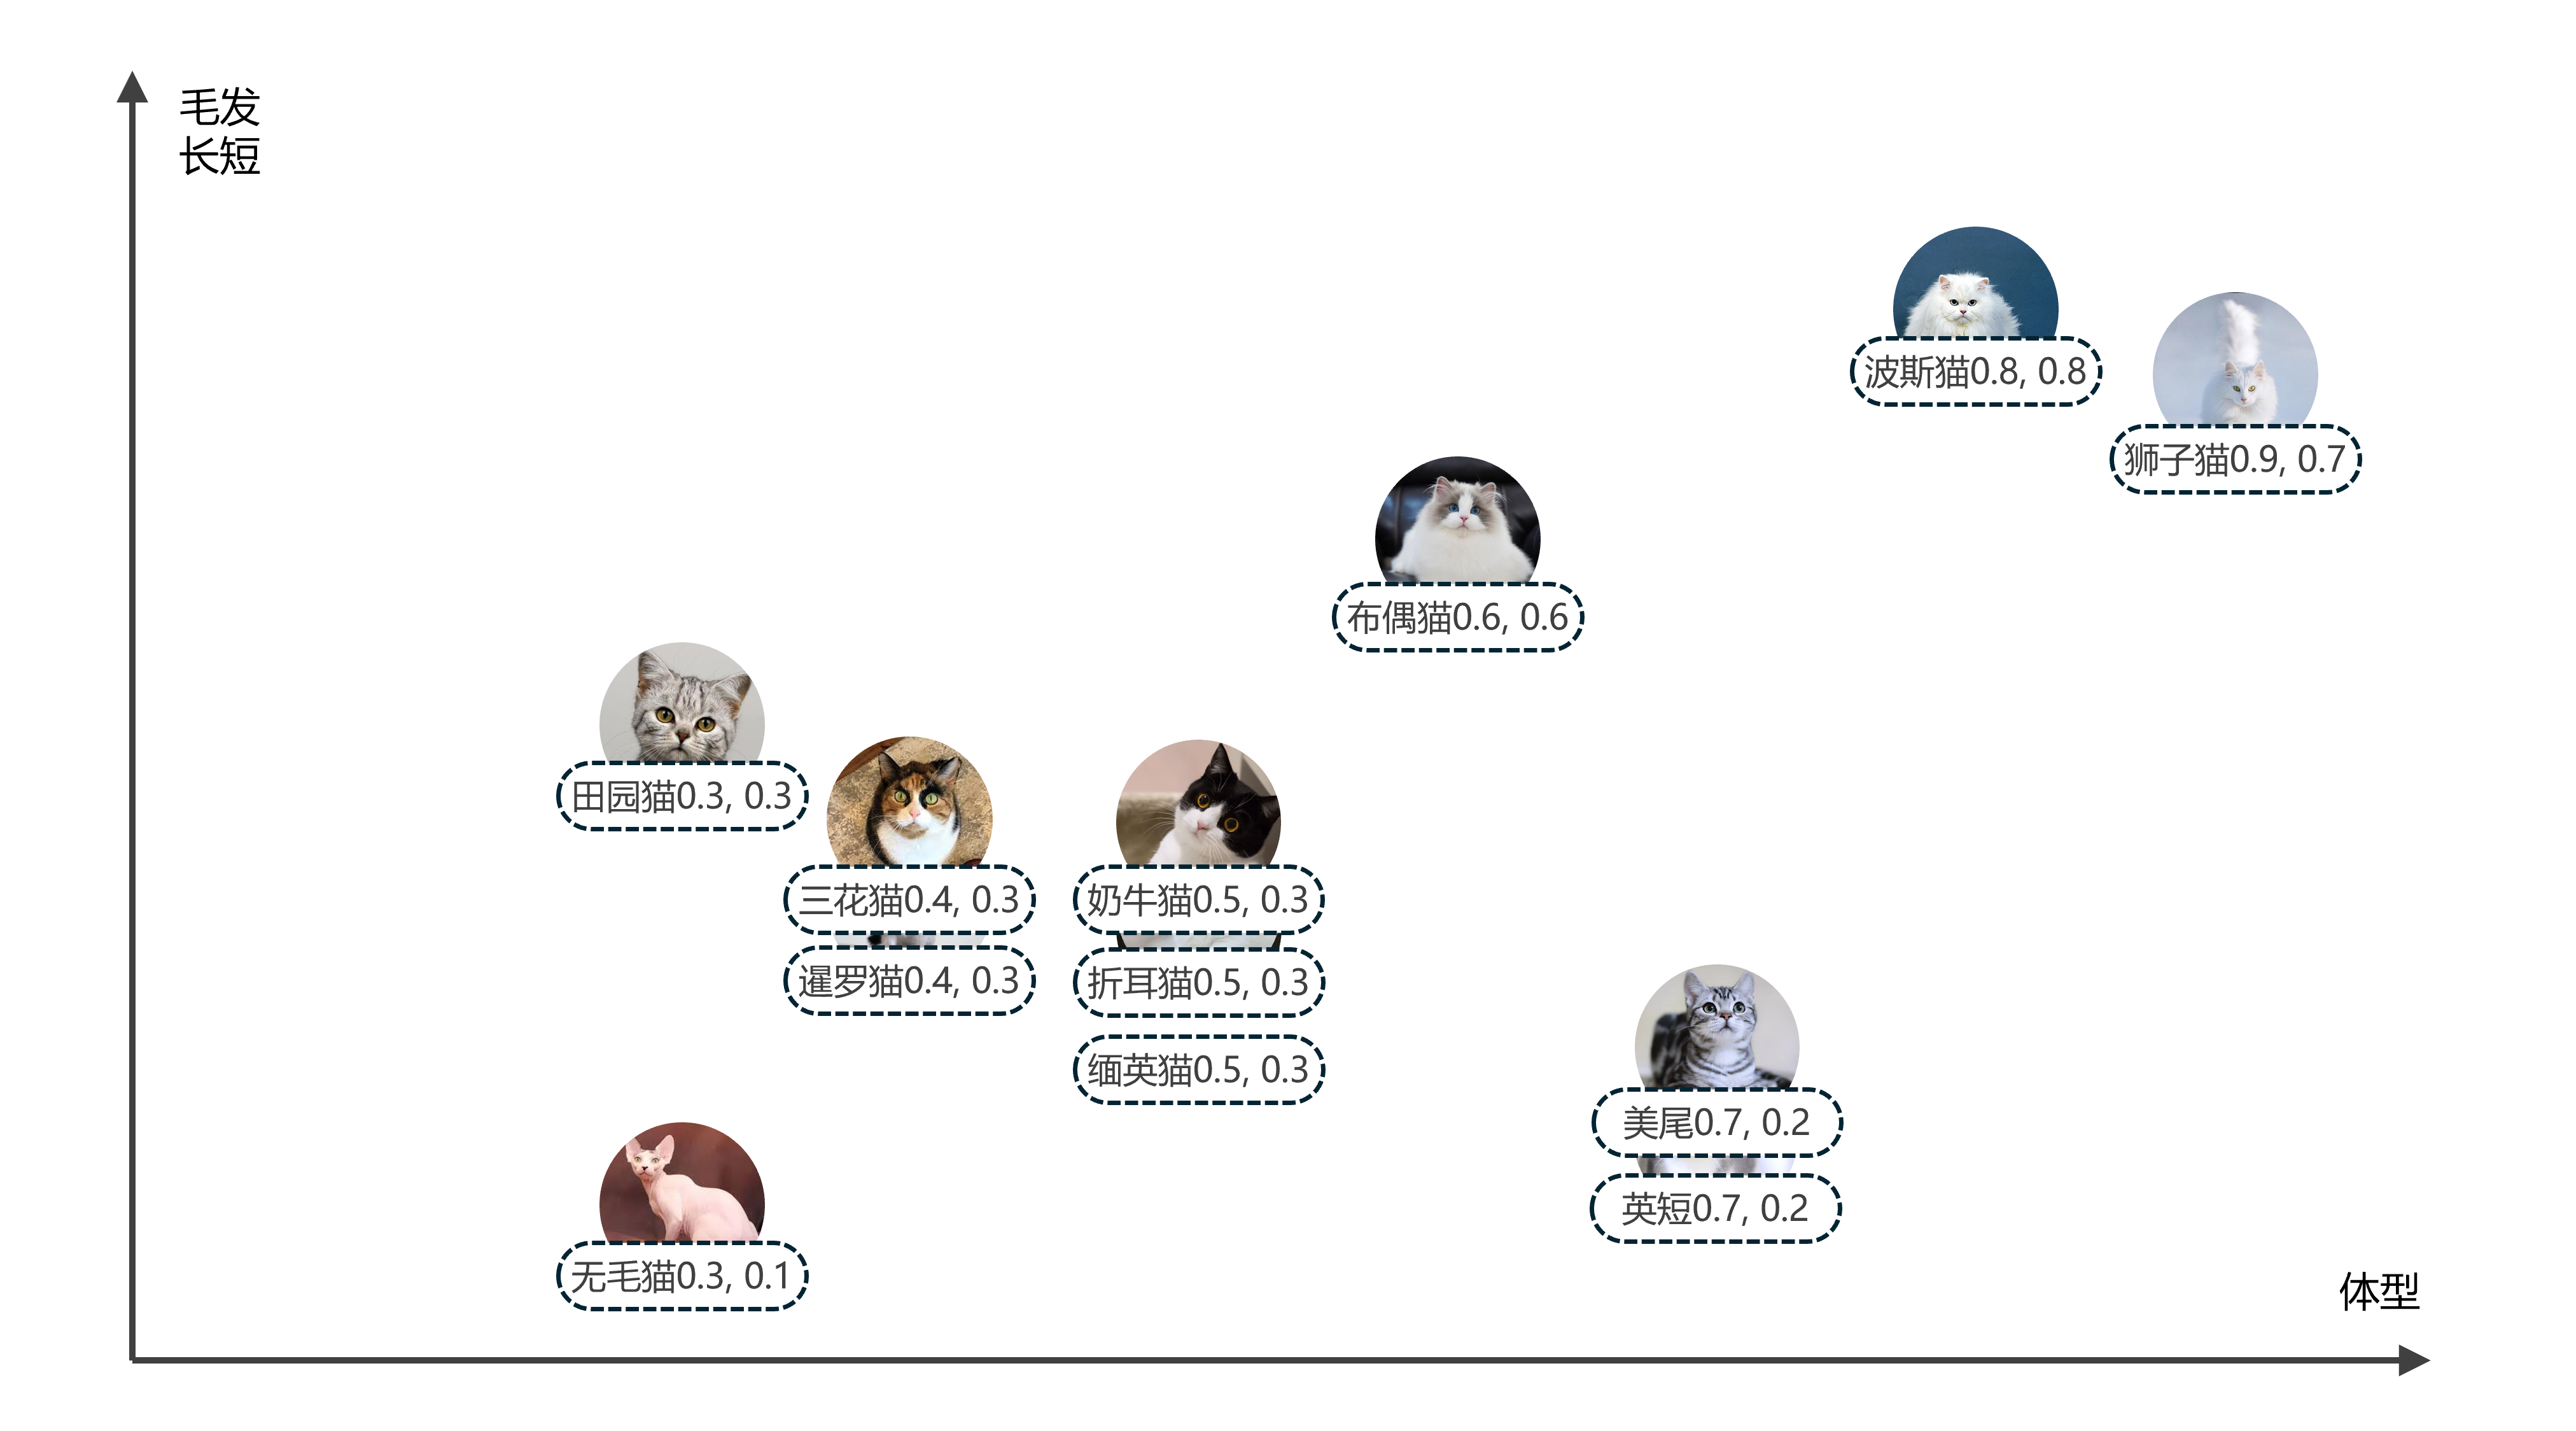
用可视化方式理解:维度越丰富,越容易表达对象之间的差异。
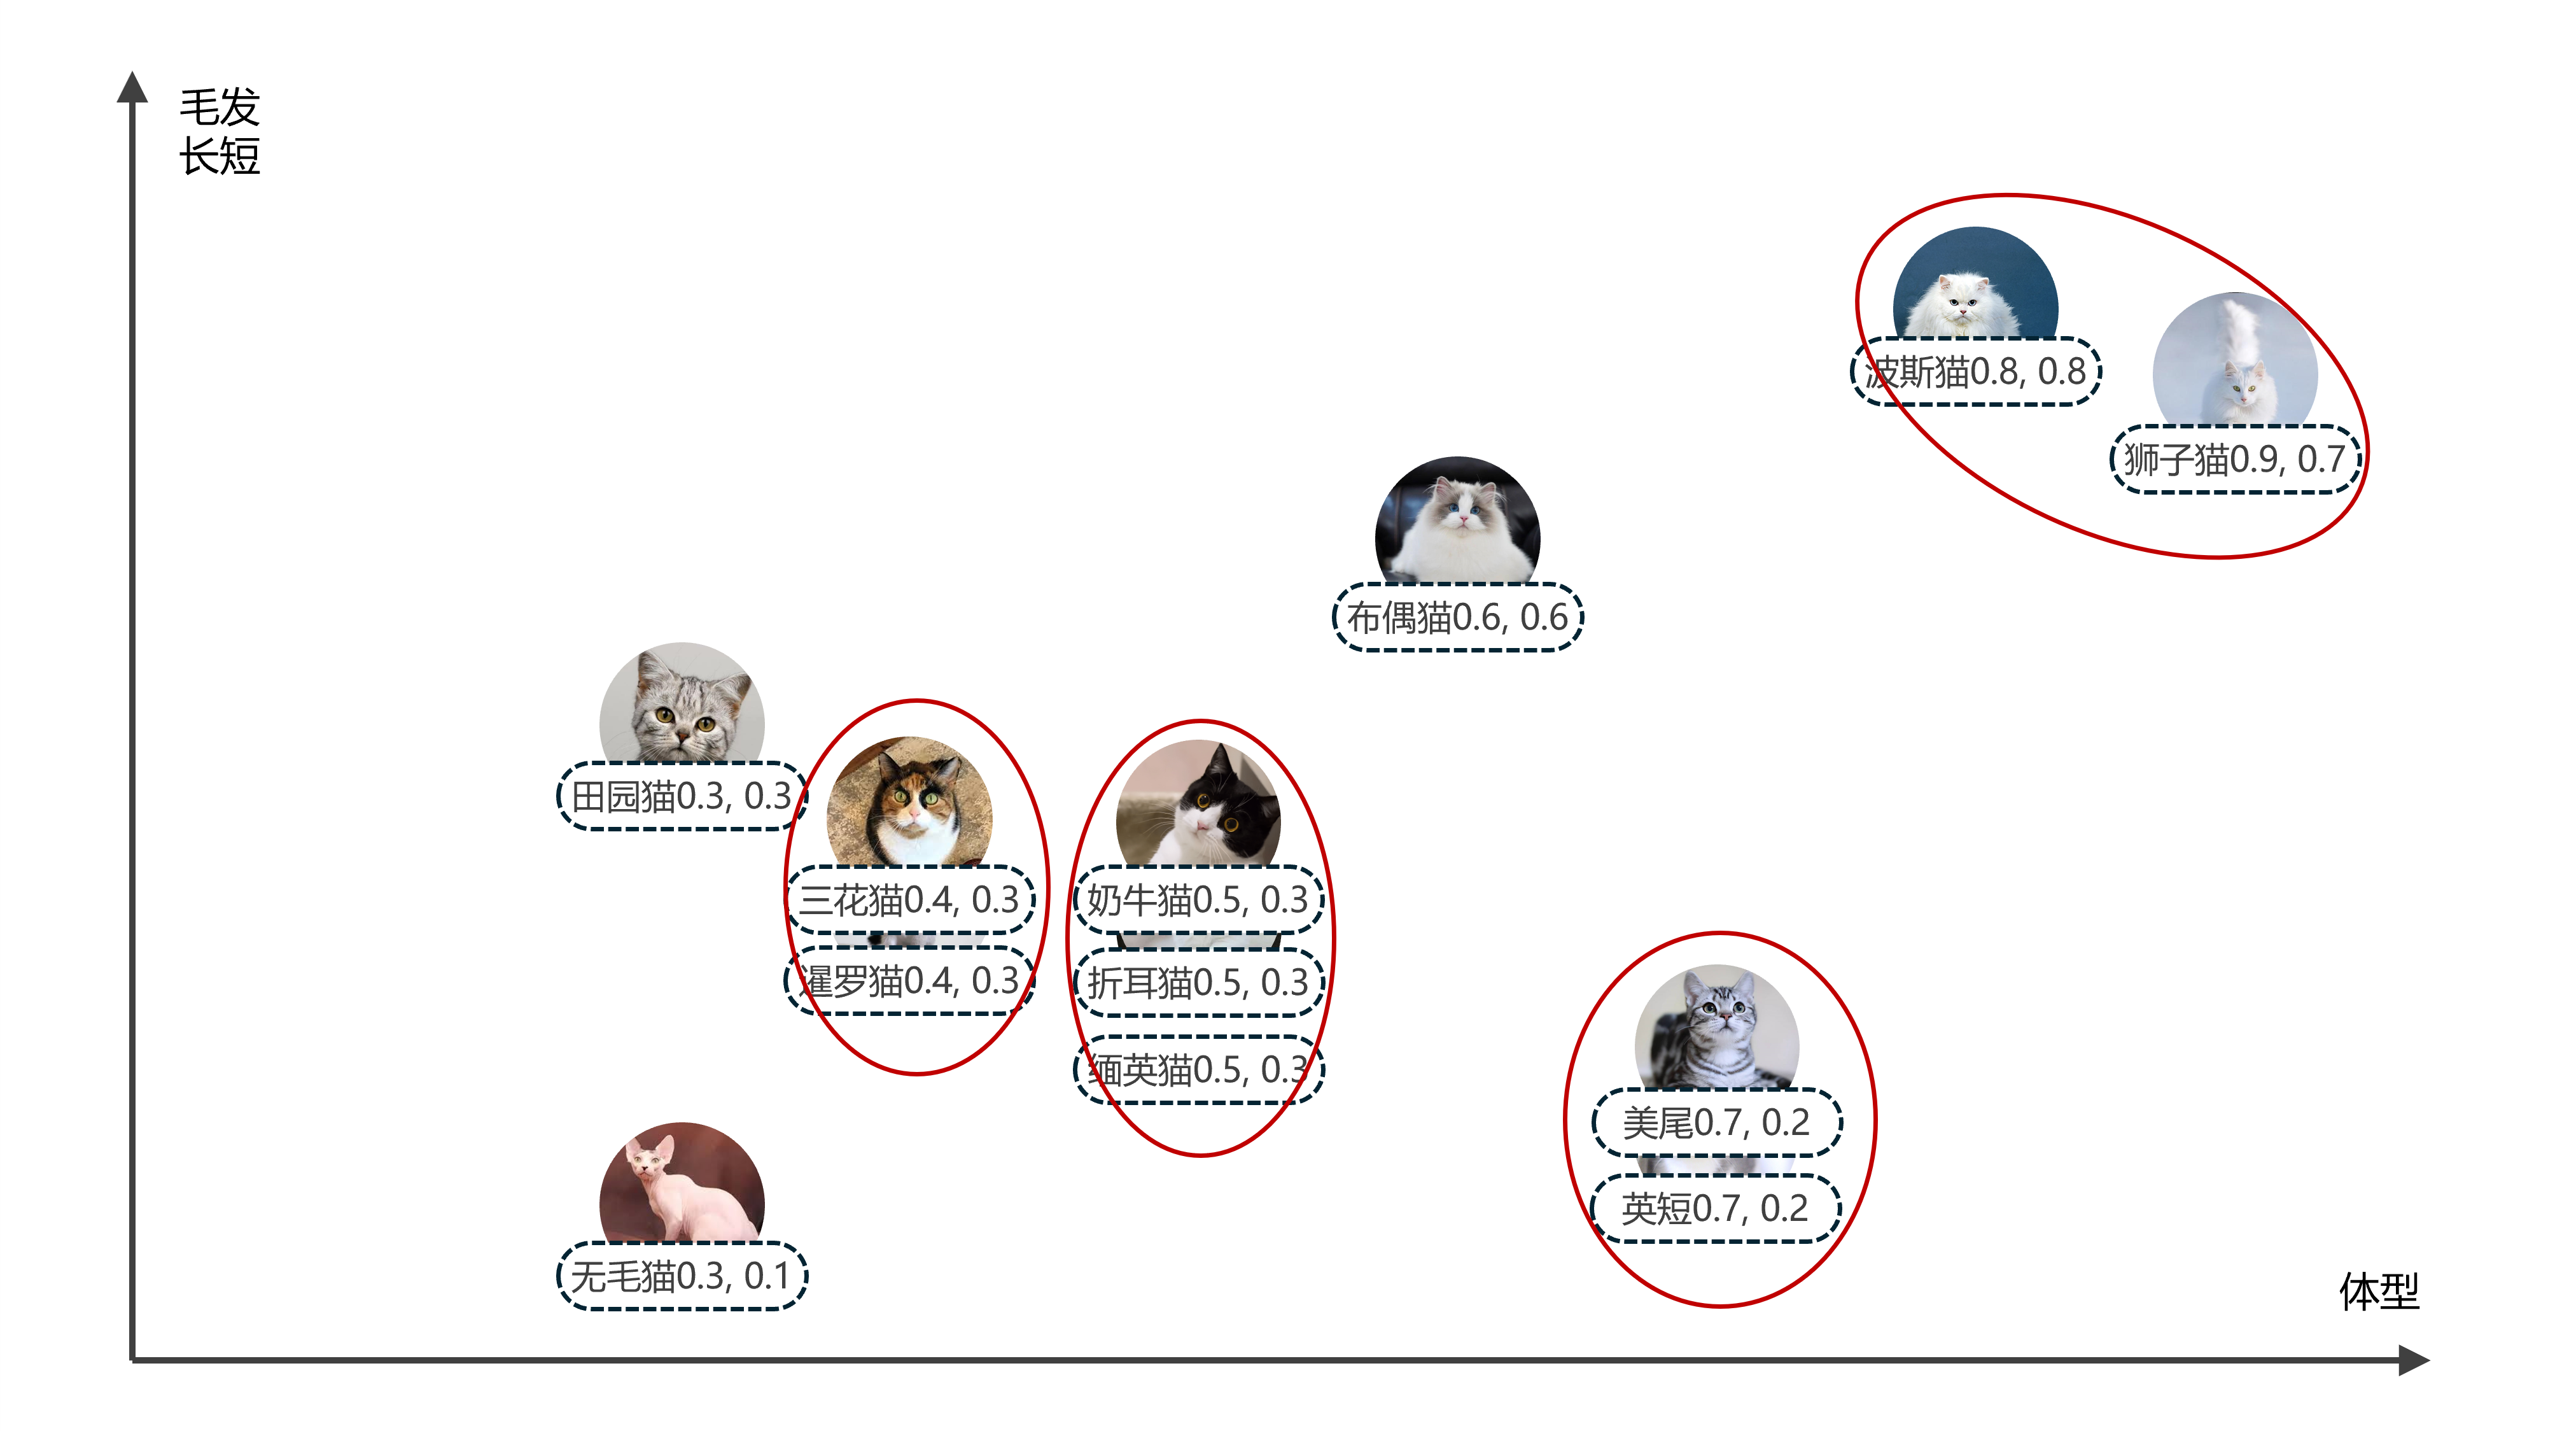
查询向量会在向量空间中寻找最接近的候选内容。
# 向量数据库解决什么问题
传统数据库擅长精确查询:id 等于多少、状态是否发布、时间是否在某个范围内。但很多 AI 应用的问题不是精确匹配,而是语义相似。例如用户问“报销飞机票需要什么”,文档里可能写的是“差旅交通票据提交规范”。两句话字面不同,但语义接近。
向量数据库把文本、图片、音频等内容转换成向量,再用向量距离表示相似度。Embedding 模型负责把原始内容映射到向量空间,向量数据库负责存储向量并快速找到距离最近的 Top K 结果。
在 RAG 中,向量数据库通常保存三类信息:原文片段、片段向量、metadata。原文用于回答,向量用于检索,metadata 用于权限过滤、来源展示、版本管理和业务条件约束。
# 从猫的例子理解向量空间
可以用猫的品种来理解向量空间。只用“体型大小”一个维度时,某些猫很难区分;增加“毛发长度”后,可以形成二维空间;再增加“耳朵长度”等维度,就能表达更多差异。真实 Embedding 向量也是类似思想,只是维度可能是几百到几千,并且每个维度不一定能用人类语言直接解释。
向量空间里的距离越近,通常代表语义越相似。对于文本来说,模型会把“退款规则”“退费说明”“取消订单后钱多久到账”映射到相近区域,而把“如何部署数据库”映射到较远区域。
# 典型用途
向量数据库常见用途包括知识库问答、相似案例检索、推荐系统、图片搜索、语义去重、客服工单匹配、代码片段检索和多模态检索。它不是只服务 RAG,而是所有“按相似度找内容”的应用都可能用到。
不过向量数据库不能替代传统数据库。订单状态、用户余额、权限关系、审计日志仍然应该放在事务型数据库中。更常见的架构是传统数据库存业务真相,向量数据库存可检索语义表示,两者通过业务 id 和 metadata 关联。
# 源码示例
query = "报销飞机票需要什么材料?"
query_vector = embeddings.embed_query(query)

results = vector_db.search(
    vector=query_vector,
    top_k=5,
    filter={
        "tenant_id": "acme",
        "doc_type": "policy",
        "status": "published",
    },
)

for item in results:
    print(item.score, item.metadata["source"], item.text[:80])
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 拓展
可以从三个方向继续扩展:第一,把当前组件放回完整 RAG 链路中观察,不只看单点能力;第二,为每次参数变化建立固定问题集,避免凭感觉判断效果;第三,把来源、版本、权限、时间和评估结果写入 metadata 或日志,让线上问题能追溯。
这类基础能力越早规范,后面接入多查询、重排、混合检索、父文档检索和权限隔离时越省力。
# 最新版 LangChain 用法提示
最新版 LangChain 把很多集成拆到独立包中。通用抽象来自 langchain_core,社区向量库多在 langchain_community,云厂商向量库可能在独立包里。新项目要优先查看对应集成包的当前 API,并使用 as_retriever()、invoke() 等 Runnable 风格接口。
# 常见问题
# 这类组件应该先在什么规模上验证?
先用一小批真实文档和真实问题验证,而不是直接全量入库。验证时至少观察三类结果:检索是否命中正确片段、返回片段是否包含足够上下文、最终回答是否严格基于证据。
# 只看相似度分数够不够?
不够。相似度分数只能说明向量距离,不代表答案一定正确。还要看 chunk 是否完整、metadata 是否正确、过滤条件是否过严或过松,以及 Prompt 是否要求模型只根据上下文回答。
# 参数应该怎么调?
先固定评测问题集,再一次只改一个变量,例如 chunk 大小、overlap、top_k、Embedding 模型或过滤条件。每次改动都记录召回命中率、答案准确率、延迟和成本。
# 面试题
# 1. RAG 链路里最容易被忽略的工程点是什么?
最容易被忽略的是数据处理和评估。很多问题不是 LLM 不会答,而是文档解析错误、chunk 切坏、metadata 丢失、向量版本混乱、检索过滤条件错误,导致模型拿不到正确证据。
# 2. 为什么不能只依赖 LLM 自身参数记忆?
参数记忆存在知识过期、领域知识缺失、事实边界不清和不可追踪的问题。RAG 通过检索外部证据,把回答范围约束在可追踪内容上,适合企业知识库、产品文档和实时资料问答。
# 3. 如何判断一个 RAG 系统的问题出在检索还是生成?
先直接查看检索返回的文档。如果返回内容已经不相关,问题在加载、切分、Embedding、向量库或 Retriever;如果返回内容正确但回答错误,问题多半在 Prompt、上下文压缩、引用组织或模型输出约束。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 回答看起来合理但没有依据 | Prompt 没要求基于上下文,或检索片段不相关 | 增加拒答策略、引用来源、检索结果抽样检查 |
| 召回结果经常跑偏 | chunk 过短、Embedding 模型不适合、query 表达不完整 | 调整切分策略,评估 Embedding,必要时做查询改写 |
| 命中了旧内容 | 文档更新后没有重新入库,或缓存没有区分版本 | 使用文档 hash、版本号、更新时间和重建任务 |
| 多租户数据串库 | metadata filter 缺失或字段设计不严谨 | 强制 tenant_id / dataset_id 过滤,并做权限测试 |
| 成本增长明显 | 重复 Embedding、top_k 过大、无缓存 | 增加缓存、批处理、限流和调用统计 |
| 延迟不稳定 | 向量库网络抖动、LLM 响应慢、检索链路串行 | 并行化可并行步骤,增加超时、重试和降级策略 |