# 大语言模型幻觉的原因与缓解方案
# 原始图示
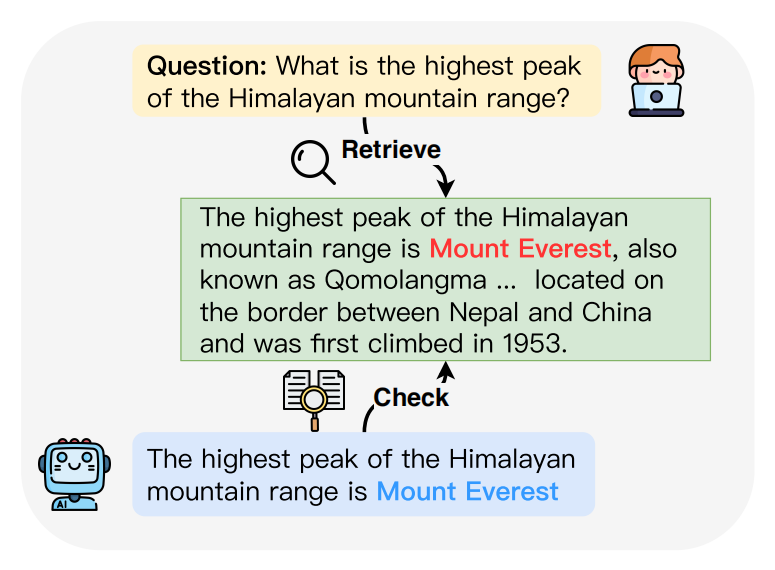
这些方法可以分别从事实重叠、分类判断、问答一致性、不确定性和提示式评估角度检测幻觉。
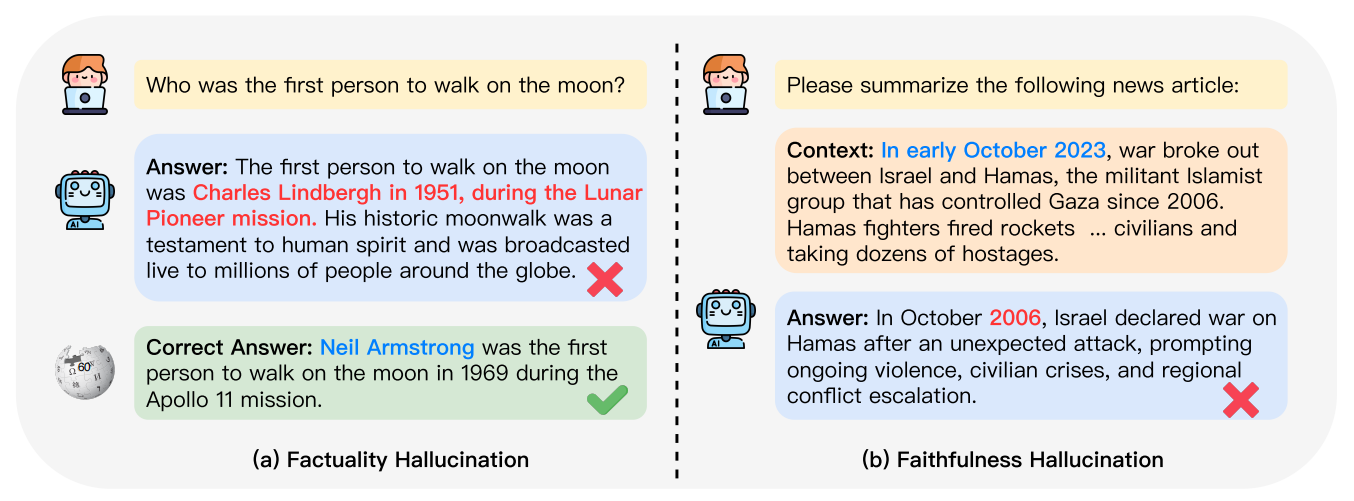
事实性幻觉和忠实性幻觉要分开治理,否则容易把检索问题和生成问题混在一起。
# 问题背景
大语言模型生成文本时,有时会给出看似流畅、语气肯定、结构完整,但事实并不可靠的回答,这类现象通常被称为幻觉。幻觉不是一个单点 bug,而是由数据、训练、推理、Prompt、上下文和应用链路共同造成的结果。
幻觉可以粗略分成两类:事实性幻觉和忠实性幻觉。事实性幻觉指回答内容与可验证事实不一致,例如把第一个登上月球的人说成 Charles Lindbergh。忠实性幻觉指回答不忠于用户给定的指令或上下文,例如要求概括某个时间范围内的内容,模型却混入了范围外的信息。
在 RAG 场景中,幻觉治理的目标不是让模型永远不会犯错,而是尽量让模型的回答建立在可检索、可引用、可校验的证据上。只要能把“回答从哪里来”变得可追踪,很多幻觉问题就能被发现、拒答或修正。
# 幻觉来源
从数据角度看,训练语料可能包含错误、重复、偏见和过时知识。模型会把训练数据中的统计相关性压缩进参数,但它并不知道哪些内容是最新事实、哪些内容已经被纠正、哪些内容只是网络中的错误说法。
从训练角度看,预训练任务通常是预测下一个 token,这让模型擅长延续文本模式,却不等同于具备事实数据库。对齐阶段会让模型更符合人类偏好,但如果奖励更偏向“回答得像样”,模型也可能在不知道答案时继续给出自信表达。
从推理角度看,采样温度、上下文长度、注意力分布、Prompt 表达都会影响输出。上下文太长时,模型可能忽略关键事实;上下文太短时,模型又只能依赖参数记忆。Prompt 如果没有要求“只根据证据回答”,模型也更容易补全缺失信息。
从应用角度看,检索结果错误、chunk 切分不完整、metadata 过滤失误、旧向量未更新、引用未校验,都会把错误证据送给模型。此时即使模型完全忠于上下文,最终答案仍然可能错。
# 检测方式
事实性幻觉通常需要外部事实校验。可以把模型生成的实体、时间、数值、关系抽取出来,再和权威知识库、业务数据库、搜索结果或人工标注答案比对。对于企业知识库问答,最可靠的方式是建立固定问题集,每个问题都绑定可接受答案和来源片段。
忠实性幻觉更关注回答是否遵守上下文和指令。可以检查回答中的声明是否都能在检索片段中找到依据,也可以使用 NLI、问答一致性、LLM-as-judge 等方式辅助评估。评估时要区分“模型答错”和“检索没召回”,否则排查方向会错。
不确定性估计也很重要。可以观察模型多次采样的一致性、答案中关键事实的稳定性、检索相似度分布、Top K 文档之间是否互相支持。如果模型回答波动大,或者证据片段互相矛盾,就应该降低自动回答置信度。
# 缓解方案
RAG 是缓解幻觉最常用的工程方案之一。它把外部知识先检索出来,再把证据放进 Prompt,让模型基于证据组织答案。这样可以缓解知识过期、领域知识缺失和答案不可追踪的问题。
除了 RAG,还需要拒答策略。没有检索到足够证据时,系统应该明确告诉用户当前资料不足,而不是让模型自由发挥。拒答条件可以结合相似度阈值、文档数量、来源可信度、metadata 过滤结果和答案自检结果。
引用来源也很关键。回答中附带文档标题、页码、段落、URL 或 chunk id,可以让用户回看原文,也方便线上排查。引用不是装饰,而是把生成结果和证据链绑定起来。
生产环境还应加入离线评估和线上监控。离线评估用于比较不同切分参数、Embedding 模型、Retriever 和 Prompt;线上监控用于发现低置信度问题、拒答比例异常、命中旧文档、用户追问纠错等信号。
# 源码示例
def should_answer(retrieved_docs, min_score=0.45):
    if not retrieved_docs:
        return False
    best_score = max(doc.metadata.get("score", 0.0) for doc in retrieved_docs)
    return best_score >= min_score


def build_answer(question, retrieved_docs, llm, prompt):
    if not should_answer(retrieved_docs):
        return {
            "answer": "当前知识库中没有足够依据回答这个问题。",
            "sources": [],
        }

    context = "\n\n".join(doc.page_content for doc in retrieved_docs)
    message = prompt.invoke({"question": question, "context": context})
    answer = llm.invoke(message)
    return {
        "answer": answer,
        "sources": [doc.metadata for doc in retrieved_docs],
    }
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
# 拓展
可以从三个方向继续扩展:第一,把当前组件放回完整 RAG 链路中观察,不只看单点能力;第二,为每次参数变化建立固定问题集,避免凭感觉判断效果;第三,把来源、版本、权限、时间和评估结果写入 metadata 或日志,让线上问题能追溯。
这类基础能力越早规范,后面接入多查询、重排、混合检索、父文档检索和权限隔离时越省力。
# 最新版 LangChain 用法提示
最新版 LangChain 更推荐把检索、Prompt、模型调用和输出解析拆成可组合 Runnable,而不是依赖旧式一体化 Chain。幻觉治理上,可以把 Retriever 的结果先显式检查,再把 context 注入 Prompt。若需要评估,可结合 LangSmith 或自建评测集记录每次检索片段、回答和来源。
# 常见问题
# 这类组件应该先在什么规模上验证?
先用一小批真实文档和真实问题验证,而不是直接全量入库。验证时至少观察三类结果:检索是否命中正确片段、返回片段是否包含足够上下文、最终回答是否严格基于证据。
# 只看相似度分数够不够?
不够。相似度分数只能说明向量距离,不代表答案一定正确。还要看 chunk 是否完整、metadata 是否正确、过滤条件是否过严或过松,以及 Prompt 是否要求模型只根据上下文回答。
# 参数应该怎么调?
先固定评测问题集,再一次只改一个变量,例如 chunk 大小、overlap、top_k、Embedding 模型或过滤条件。每次改动都记录召回命中率、答案准确率、延迟和成本。
# 面试题
# 1. RAG 链路里最容易被忽略的工程点是什么?
最容易被忽略的是数据处理和评估。很多问题不是 LLM 不会答,而是文档解析错误、chunk 切坏、metadata 丢失、向量版本混乱、检索过滤条件错误,导致模型拿不到正确证据。
# 2. 为什么不能只依赖 LLM 自身参数记忆?
参数记忆存在知识过期、领域知识缺失、事实边界不清和不可追踪的问题。RAG 通过检索外部证据,把回答范围约束在可追踪内容上,适合企业知识库、产品文档和实时资料问答。
# 3. 如何判断一个 RAG 系统的问题出在检索还是生成?
先直接查看检索返回的文档。如果返回内容已经不相关,问题在加载、切分、Embedding、向量库或 Retriever;如果返回内容正确但回答错误,问题多半在 Prompt、上下文压缩、引用组织或模型输出约束。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 回答看起来合理但没有依据 | Prompt 没要求基于上下文,或检索片段不相关 | 增加拒答策略、引用来源、检索结果抽样检查 |
| 召回结果经常跑偏 | chunk 过短、Embedding 模型不适合、query 表达不完整 | 调整切分策略,评估 Embedding,必要时做查询改写 |
| 命中了旧内容 | 文档更新后没有重新入库,或缓存没有区分版本 | 使用文档 hash、版本号、更新时间和重建任务 |
| 多租户数据串库 | metadata filter 缺失或字段设计不严谨 | 强制 tenant_id / dataset_id 过滤,并做权限测试 |
| 成本增长明显 | 重复 Embedding、top_k 过大、无缓存 | 增加缓存、批处理、限流和调用统计 |
| 延迟不稳定 | 向量库网络抖动、LLM 响应慢、检索链路串行 | 并行化可并行步骤,增加超时、重试和降级策略 |