# LangChain OutputParser 组件实践:从模型文本到可靠业务数据
LLM 默认输出的是自然语言,而生产系统需要的是稳定的数据契约。
用户看到一段回答没有问题,但后端服务通常还要继续做入库、调用接口、生成工单、驱动页面状态、触发自动化流程。如果模型返回的是一段不可控文本,业务代码就只能靠字符串匹配、正则和各种兜底逻辑硬拆,时间久了会变成非常脆弱的隐性协议。
OutputParser 要解决的就是这个问题:把模型输出从“看起来像答案”变成“程序可以消费的数据”。它既可以把 AIMessage 转成字符串,也可以把 JSON 文本转成 dict,把输出校验成 Pydantic 对象,或者把模型结果清洗成业务需要的格式。
不过在当前 LangChain 里,OutputParser 不是结构化输出的唯一方案。新项目要先判断场景:如果模型和 provider 支持原生 structured output,优先使用 with_structured_output 或 Agent 的 response_format;如果你在做传统 LCEL chain、轻量文本转换、兼容不支持结构化输出的模型,OutputParser 仍然非常有价值。
# OutputParser 的位置
一个典型 LangChain 调用链路可以这样看:
用户输入 -> Prompt -> Model -> OutputParser -> 业务对象
Prompt 负责告诉模型要做什么,Model 负责生成结果,OutputParser 负责把结果变成业务代码能继续处理的形态。
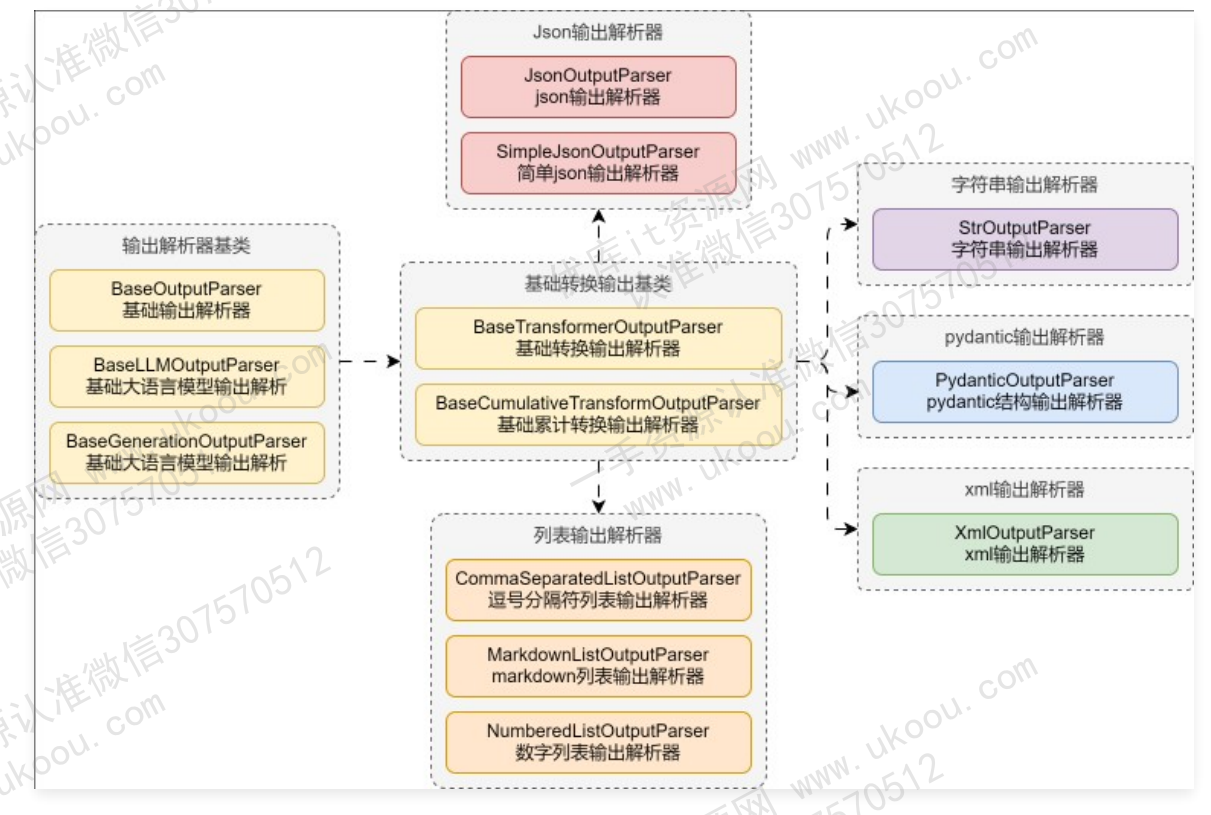
从类型关系上看,OutputParser 不是只有 JSON 解析这一种用法。字符串输出、JSON、Pydantic、XML、列表解析都属于不同场景下的输出处理方式。生产里真正要判断的是:当前链路需要自然语言、轻量 dict、强 schema 对象,还是应该直接使用模型原生结构化输出。
例如最常见的 LCEL 写法:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个严谨的 Python 后端工程师。"),
    ("human", "{question}"),
])

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

chain = prompt | model | StrOutputParser()

answer = chain.invoke({
    "question": "为什么 LLM 应用需要 OutputParser?"
})

print(answer)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
这里的 StrOutputParser 看起来很简单,但它把模型返回的 AIMessage 转成了字符串,让后续业务只处理 str,不用关心 message 对象里的 metadata、tool calls 或 provider 差异。
# 不要把 OutputParser 当成万能保险
OutputParser 不是魔法。它能解析和校验输出,但不能保证模型一定按要求生成。
生产里要把 OutputParser 放在更完整的输出治理体系中:
- Prompt 里明确输出格式。
- 使用模型原生结构化能力或 tool calling。
- 使用 Pydantic 做类型和业务校验。
- 对解析失败做可观测记录。
- 对关键链路设计重试、降级和人工兜底。
- 用评估集验证格式稳定性。
如果只是写一句“请返回 JSON”,然后指望 parser 永远成功,线上一定会遇到奇怪输出:多余解释、Markdown 代码块、缺字段、字段类型错误、枚举值不合法、语言混杂、甚至返回空内容。
# 当前更推荐的结构化输出方式
对强结构化场景,优先看模型或 Agent 的结构化输出能力。
# 模型级结构化输出
如果只是一次模型调用,希望直接得到 Pydantic 对象,可以使用 with_structured_output:
from pydantic import BaseModel, Field
from langchain_openai import ChatOpenAI


class TicketIntent(BaseModel):
    intent: str = Field(description="用户意图,例如 create_ticket、query_status、other")
    priority: str = Field(description="优先级:low、medium、high")
    summary: str = Field(description="20 字以内的问题摘要")


model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
structured_model = model.with_structured_output(TicketIntent)

result = structured_model.invoke(
    "客户反馈线上系统无法登录,整个财务团队都没法报销。"
)

print(result.intent)
print(result.priority)
print(result.summary)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
这种方式比“模型输出 JSON 字符串,再手动解析”更适合生产,因为 schema 是显式的,模型调用和结构化约束在同一层完成。
# Agent 级结构化输出
如果你已经在使用 create_agent,可以通过 response_format 定义最终输出结构:
from pydantic import BaseModel, Field
from langchain.agents import create_agent


class SupportAnswer(BaseModel):
    answer: str = Field(description="给用户的回答")
    need_human: bool = Field(description="是否需要转人工")
    confidence: float = Field(description="0 到 1 之间的置信度")


agent = create_agent(
    model="openai:gpt-4o-mini",
    tools=[],
    system_prompt="你是企业客服助手,回答要准确、克制,不确定时转人工。",
    response_format=SupportAnswer,
)

result = agent.invoke({
    "messages": [
        {"role": "user", "content": "我的订单扣款了但页面显示未支付。"}
    ]
})

structured = result["structured_response"]

print(structured.answer)
print(structured.need_human)
print(structured.confidence)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
Agent 场景里,response_format 更自然,因为最终答案可能经历多轮工具调用、状态更新和中间推理。你真正关心的是 Agent 最终返回给业务系统的数据,而不是某一次中间模型调用的文本。
# OutputParser 仍然适合哪些场景
虽然结构化输出能力越来越重要,OutputParser 仍然有清晰的使用边界。
适合使用 OutputParser 的场景:
- 简单 LCEL chain,需要把
AIMessage转成字符串。 - 做摘要、改写、翻译这类文本任务。
- 模型或 provider 不支持原生 structured output。
- 需要解析轻量 JSON、列表、日期等文本格式。
- 希望把 parser 作为 chain 的最后一步,保持组合风格统一。
- 对模型输出做二次清洗、兼容旧接口或适配下游协议。
不适合只依赖 OutputParser 的场景:
- 金融、支付、权限变更等强一致链路。
- 枚举和数值校验非常严格的业务。
- 输出结构会直接驱动高风险工具调用。
- 需要 provider 原生 JSON schema 保证的场景。
- 需要完整审计、重放和评估的复杂 Agent。
换句话说,OutputParser 是输出治理的一层,不是输出治理的全部。
# StrOutputParser:把消息变成文本
StrOutputParser 是最常用的 parser。它适合最终结果就是一段文本的场景。
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_template(
    "请用三句话解释:{topic}"
)

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
chain = prompt | model | StrOutputParser()

result = chain.invoke({
    "topic": "OutputParser 在 LangChain 中的作用"
})

print(type(result))
print(result)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
适合场景:
- 问答。
- 摘要。
- 翻译。
- 文案生成。
- 代码解释。
- RAG 最终回答。
生产中即使只是返回字符串,也建议把模型响应的 metadata 记录到 trace 或日志中。StrOutputParser 只保留文本内容,如果你在 parser 之后才记录日志,就拿不到完整的 token、模型名、finish reason 等信息。
更稳妥的做法是在模型调用层或 LangSmith trace 中记录元数据,而不是指望业务层从最终字符串里反推。
# JsonOutputParser:解析 JSON
当你希望模型返回 JSON dict,但暂时不需要完整 Pydantic 校验时,可以使用 JsonOutputParser。
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


parser = JsonOutputParser()

prompt = ChatPromptTemplate.from_messages([
    (
        "system",
        """
你是工单分类器。
只返回 JSON,不要返回 Markdown,不要返回额外解释。

{format_instructions}
""",
    ),
    ("human", "{user_input}"),
]).partial(format_instructions=parser.get_format_instructions())

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
chain = prompt | model | parser

result = chain.invoke({
    "user_input": "线上系统登录失败,影响整个财务团队报销。"
})

print(result)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
JsonOutputParser 的优势是轻量,返回普通 dict,适合临时结构化、内部脚本、低风险自动化。
它的风险也很明显:dict 不是业务 schema。模型可能返回多字段、少字段、字段名不稳定,或者把数字返回成字符串。只要这个结果要进入核心业务,就应该继续做校验。
# PydanticOutputParser:把输出校验成对象
如果你明确需要字段、类型、描述和校验,PydanticOutputParser 更合适。
from pydantic import BaseModel, Field
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


class IncidentReport(BaseModel):
    title: str = Field(description="一句话标题")
    severity: str = Field(description="严重级别:p0、p1、p2、p3")
    affected_system: str = Field(description="受影响系统")
    summary: str = Field(description="事件摘要")


parser = PydanticOutputParser(pydantic_object=IncidentReport)

prompt = ChatPromptTemplate.from_messages([
    (
        "system",
        """
你是故障工单分析助手。
请根据用户描述抽取故障信息。

{format_instructions}
""",
    ),
    ("human", "{content}"),
]).partial(format_instructions=parser.get_format_instructions())

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
chain = prompt | model | parser

report = chain.invoke({
    "content": "支付系统从 10:03 开始大量超时,用户无法完成订单付款。"
})

print(report.title)
print(report.severity)
print(report.affected_system)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
这里有一个关键点:Pydantic 校验只能证明“模型输出可以被解析成这个对象”,不能证明“模型判断一定正确”。比如 severity 合法地返回了 p2,但真实业务规则可能应该是 p0。所以结构化输出之后还要接业务规则校验。
更严格一点,可以使用枚举约束:
from enum import Enum
from pydantic import BaseModel, Field


class Severity(str, Enum):
    p0 = "p0"
    p1 = "p1"
    p2 = "p2"
    p3 = "p3"


class IncidentReport(BaseModel):
    title: str
    severity: Severity
    affected_system: str
    summary: str = Field(max_length=200)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
这样模型如果返回了 high、严重、P1 这类不符合枚举的值,解析阶段就会失败,业务代码不会拿到一个看似可用但实际不合规的对象。
# 列表、日期和轻量格式
有些输出不需要复杂 schema,只需要把文本变成列表或日期。
例如关键词提取:
from langchain_core.output_parsers import CommaSeparatedListOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


parser = CommaSeparatedListOutputParser()

prompt = ChatPromptTemplate.from_template(
    "从下面文本中提取 5 个关键词,用逗号分隔:{text}\n{format_instructions}"
).partial(format_instructions=parser.get_format_instructions())

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
chain = prompt | model | parser

keywords = chain.invoke({
    "text": "LangChain 可以帮助开发者构建可组合、可观测、可评估的 LLM 应用。"
})

print(keywords)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
这种 parser 适合低风险场景。只要结果会进入数据库、参与检索召回、驱动权限或工作流,就不要停在“解析成 list”这一步,还要做去重、长度限制、敏感词过滤和业务校验。
# 解析失败怎么处理
生产里一定要假设解析会失败。
常见失败原因包括:
- 模型返回了 Markdown 代码块。
- 模型在 JSON 前后加了解释。
- 字段缺失。
- 字段类型不对。
- 枚举值不合法。
- 输出被截断。
- 模型拒答或返回安全提示。
- 上游 prompt 变量为空,导致输出格式偏移。
最简单的处理方式是捕获异常,并把原始输出、prompt 版本、模型名、输入摘要记录下来。
from langchain_core.exceptions import OutputParserException


def parse_with_observability(chain, payload: dict):
    try:
        return chain.invoke(payload)
    except OutputParserException as exc:
        # 真实项目里应写入结构化日志或 trace,而不是只 print。
        raise ValueError("模型输出格式不符合预期") from exc
2
3
4
5
6
7
8
9
不过只捕获异常还不够。你需要按业务风险决定下一步:
- 低风险任务:返回兜底文案。
- 中风险任务:换更强模型重试一次。
- 高风险任务:进入人工处理队列。
- 离线任务:记录失败样本,稍后批量修复。
- API 场景:返回稳定错误码,不把 parser 异常直接暴露给前端。
不要无限重试。解析失败通常说明 prompt、schema、模型能力或输入质量存在问题,无限制重试只会放大成本和延迟。
# Prompt 和 Parser 要一起设计
OutputParser 通常会提供 get_format_instructions(),把格式要求注入 Prompt。
但这不代表 Prompt 可以只写格式说明。Prompt 还要说明业务语义。
一个比较稳的结构是:
角色:你是什么助手
任务:你要抽取或生成什么
边界:不知道时怎么处理
字段:每个字段的含义
格式:由 parser 注入
输入:用户内容或业务上下文
2
3
4
5
6
例如工单抽取不能只告诉模型“返回 JSON”,还要说明严重级别如何判断、哪些信息不足时应该返回什么、是否允许推测、是否可以生成默认值。
Parser 负责结构,Prompt 负责语义。两者缺一不可。
# 和流式输出的关系
流式输出和强结构化解析天然有张力。
如果你要把回答逐字显示给用户,StrOutputParser 很适合,因为文本 chunk 可以持续向前端推送。但如果你要得到一个完整 Pydantic 对象,通常需要等模型输出结束后才能校验。
实践中可以拆成两类接口:
- 聊天展示接口:优先流式文本,前端消费 token 或 message chunk。
- 业务决策接口:优先完整结构化对象,不追求逐字流式。
不要为了“看起来更实时”把强结构化 JSON 半截半截推给前端,再让前端猜对象何时完整。更好的方式是:过程事件可以流式,最终业务对象完整返回。
# API 层应该返回什么
不要把 LangChain parser 的对象直接泄漏成外部 API 契约。
内部可以使用 Pydantic 模型约束 LLM 输出,但对外接口最好定义自己的响应模型:
from pydantic import BaseModel


class TicketIntentResult(BaseModel):
    intent: str
    priority: str
    summary: str
    model: str
    prompt_version: str


def to_api_response(parsed: IncidentReport) -> TicketIntentResult:
    return TicketIntentResult(
        intent="create_ticket",
        priority=parsed.severity.value,
        summary=parsed.summary,
        model="gpt-4o-mini",
        prompt_version="ticket-intent-2026-08-06-v1",
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
这样做有几个好处:
- 内部 Prompt 和 parser 可以迭代。
- 外部 API 契约保持稳定。
- 可以补充模型、版本、置信度、降级状态等元信息。
- 可以避免把模型中间字段暴露给调用方。
LLM 输出模型和业务响应模型最好分开。前者服务于模型约束,后者服务于系统边界。
# 生产封装建议
不要在业务函数里到处散落 parser。推荐按场景集中管理:
internal/
  ai/
    models.py
    prompts/
      ticket.py
      summary.py
    parsers/
      ticket.py
      summary.py
    chains/
      ticket.py
      summary.py
    schemas/
      ticket.py
2
3
4
5
6
7
8
9
10
11
12
13
14
示例:
# internal/ai/schemas/ticket.py
from enum import Enum
from pydantic import BaseModel, Field


class Priority(str, Enum):
    low = "low"
    medium = "medium"
    high = "high"


class TicketIntent(BaseModel):
    intent: str = Field(description="用户意图")
    priority: Priority = Field(description="工单优先级")
    summary: str = Field(description="20 字以内摘要")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# internal/ai/chains/ticket.py
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import ChatPromptTemplate
from internal.ai.models import get_default_chat_model
from internal.ai.schemas.ticket import TicketIntent


TICKET_INTENT_PROMPT_VERSION = "ticket-intent-2026-08-06-v1"

parser = PydanticOutputParser(pydantic_object=TicketIntent)

prompt = ChatPromptTemplate.from_messages([
    (
        "system",
        """
你是工单意图识别助手。
请根据用户输入判断意图、优先级,并生成摘要。
不要编造用户没有提供的信息。

{format_instructions}
""",
    ),
    ("human", "{user_input}"),
]).partial(format_instructions=parser.get_format_instructions())


def build_ticket_intent_chain():
    return prompt | get_default_chat_model() | parser
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
业务层调用:
# internal/services/ticket_service.py
from internal.ai.chains.ticket import build_ticket_intent_chain


def classify_ticket(user_input: str):
    chain = build_ticket_intent_chain()
    return chain.invoke({"user_input": user_input})
2
3
4
5
6
7
这个结构的重点不是目录名字,而是职责隔离:schema、prompt、model、parser、chain、service 各自有边界。后续要替换成 with_structured_output,也只需要改 AI 模块,不会影响 route 层和业务服务层。
# 测试 OutputParser
Parser 测试不一定每次都调用模型。至少应该覆盖三类测试。
第一类是纯解析测试:
from internal.ai.chains.ticket import parser


def test_parse_ticket_intent():
    result = parser.parse(
        '{"intent": "create_ticket", "priority": "high", "summary": "无法登录系统"}'
    )

    assert result.intent == "create_ticket"
    assert result.priority == "high"
2
3
4
5
6
7
8
9
10
第二类是非法输出测试:
import pytest


def test_parse_ticket_intent_rejects_invalid_priority():
    with pytest.raises(Exception):
        parser.parse(
            '{"intent": "create_ticket", "priority": "urgent", "summary": "无法登录系统"}'
        )
2
3
4
5
6
7
8
第三类是端到端样本测试:
def test_ticket_intent_chain_golden_case(fake_chat_model):
    chain = prompt | fake_chat_model | parser

    result = chain.invoke({
        "user_input": "生产支付接口大量超时,用户无法下单。"
    })

    assert result.intent == "create_ticket"
    assert result.priority in {"high", "medium"}
2
3
4
5
6
7
8
9
纯 parser 测试负责格式,端到端样本测试负责模型链路。两者都需要,不能互相替代。
# 观测字段
结构化输出失败时,排查需要足够上下文。建议记录:
- trace id
- user id / tenant id
- model name
- prompt version
- parser name
- schema version
- latency
- token usage
- raw output 摘要
- parser error type
- fallback strategy
不要把完整用户输入和完整模型输出无脑打进日志。真实系统可能包含个人信息、商业数据或密钥片段。日志要做脱敏、截断和权限控制。
# 常见坑
# 把 JSON 当成可靠协议
模型能返回 JSON,不代表字段语义正确。JSON 只解决语法问题,业务还要做类型、枚举、范围、权限和状态校验。
# Prompt 中 JSON 示例没有转义
如果在 ChatPromptTemplate 里写 JSON 示例,大括号可能被当成模板变量。需要写成双大括号:
prompt = ChatPromptTemplate.from_template("""
请返回如下 JSON:
{{
  "answer": "...",
  "confidence": 0.9
}}
问题:{question}
""")
2
3
4
5
6
7
8
# schema 一次设计得太复杂
字段越多,模型越容易漏字段或填错字段。复杂输出可以拆成多个步骤:先分类,再抽取,再生成详情。每一步的 schema 更小,稳定性往往更好。
# 枚举值没有业务定义
只写 priority: str,模型可能返回 高、high、urgent、P1。生产里应该用枚举,并在 Prompt 里解释每个枚举的判断规则。
# 解析失败只返回 500
对用户来说,“格式解析失败”不是可理解错误。API 层应该返回稳定错误码和可理解提示,内部再记录 parser 异常和原始输出摘要。
# 选型建议
可以按下面方式选择:
| 场景 | 推荐方式 |
|---|---|
| 最终答案是一段文本 | StrOutputParser |
| 轻量 JSON,低风险内部使用 | JsonOutputParser |
| 需要 Python 对象和类型校验 | PydanticOutputParser 或 with_structured_output |
| provider 支持原生结构化输出 | 优先 with_structured_output |
| Agent 最终返回结构化结果 | create_agent(response_format=...) |
| 高风险业务决策 | 结构化输出 + 业务规则校验 + 人工兜底 |
对于新项目,我的默认建议是:
- 普通文本链路用
StrOutputParser。 - 强结构化模型调用优先
with_structured_output。 - Agent 结果优先
response_format。 - 兼容旧模型或轻量链路时再使用 JSON / Pydantic parser。
- 无论哪种方式,都要有 schema、测试、观测和降级。
# 小结
OutputParser 的核心价值不是“把字符串转成 JSON”,而是把模型输出纳入工程契约。
在生产系统里,模型输出不能只看是否“像答案”,还要看是否可解析、可校验、可追踪、可回放、可降级。OutputParser 正好处在模型世界和业务世界的交界处:向前承接 Prompt 和 Model,向后交给服务、数据库、接口和工作流。
当前 LangChain 已经把结构化输出能力前移到 Model 和 Agent 层,所以新项目不要机械地所有场景都套 parser。正确做法是:文本结果用 parser 简化链路,强结构化结果优先使用模型或 Agent 的结构化输出能力,再用业务校验守住系统边界。