# LangChain Model 组件实践:模型初始化、消息协议与生产调用技巧
Model 是 LangChain 应用里最核心的组件之一。Prompt 负责组织上下文,Retriever 负责补充外部知识,Tool 负责连接外部能力,但真正产生推理和生成结果的,仍然是模型。
不过在 LangChain 里,Model 不是简单的“某个 SDK 客户端”。它是一层统一抽象,用来屏蔽不同模型供应商在调用方式、消息格式、流式输出、工具调用、结构化输出、响应元数据等方面的差异。
理解 Model 组件,不能只停留在“怎么调一次模型”。生产项目里更重要的问题是:如何初始化模型、如何设计消息、如何批处理和流式输出、如何拿到 token 用量、如何处理超时重试、如何在多个模型之间切换,以及如何避免模型参数散落在业务代码里。
# Model 组件解决什么问题
直接使用 provider SDK 时,代码往往会和某个供应商强绑定:
from openai import OpenAI


client = OpenAI()

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": "你是一个技术助手。"},
        {"role": "user", "content": "解释一下 LangChain 的 Model 组件。"},
    ],
)

print(response.choices[0].message.content)
2
3
4
5
6
7
8
9
10
11
12
13
14
这段代码没问题,但它把业务和 OpenAI 的接口细节绑在了一起。如果后面要切到 Anthropic、Gemini、Bedrock、OpenRouter 或企业内部 OpenAI-compatible 网关,就要改调用方式、参数名、响应结构和错误处理。
LangChain 的 Model 抽象主要解决这些问题:
- 统一模型调用方式。
- 统一消息对象。
- 统一同步、异步、批处理、流式接口。
- 统一工具调用与结构化输出的接入方式。
- 统一响应内容和响应元数据读取方式。
- 方便与 Prompt、Parser、Retriever、Agent 组合。
也就是说,Model 组件是 LangChain 把“模型能力”接入应用编排的边界。
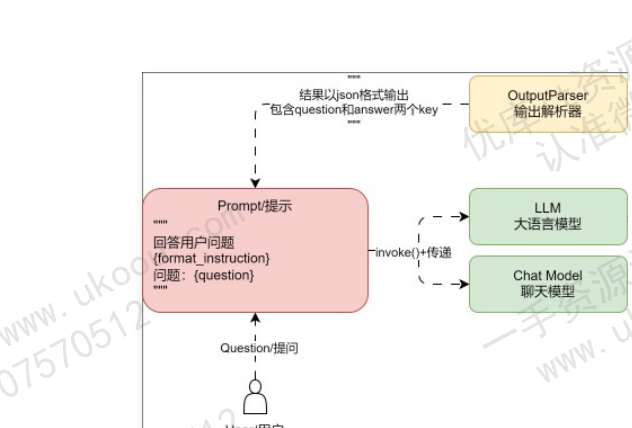
从链路上看,用户问题通常先进入 Prompt,被格式化成模型输入;随后由 LLM 或 Chat Model 生成结果;最后再交给 OutputParser 转成业务代码需要的文本或结构化数据。Model 处在中间,它既要接住 Prompt 生成的上下文,也要为后面的解析、工具调用、trace 和成本统计提供稳定输出。
# LLM 与 Chat Model
早期大模型接口常见的是文本输入、文本输出,也就是传统 LLM:
input: "请解释什么是 ORM"
output: "ORM 是对象关系映射..."
2
现在主流应用更常用 Chat Model。Chat Model 使用消息列表作为输入,每条消息都有角色和内容:
[
    ("system", "你是一个严谨的 Python 后端工程师。"),
    ("human", "SQLAlchemy Session 应该在哪里 commit?"),
]
2
3
4
Chat Model 更适合生产应用,原因是它天然支持:
- 多轮对话。
- system / user / assistant 角色分离。
- 工具调用。
- 多模态消息。
- 结构化输出。
- 响应元数据。
新项目里,除非你明确需要老式文本模型,否则优先使用 Chat Model。
# 安装 provider 包
当前 LangChain 推荐按模型供应商安装对应 integration package。以 OpenAI 为例:
pip install -U langchain langchain-openai
使用 Anthropic:
pip install -U langchain-anthropic
使用 Google Gemini:
pip install -U langchain-google-genai
这种拆包方式的好处是:LangChain 核心包保持轻量,不同 provider 的依赖、版本和能力可以独立演进。
# 初始化模型的两种方式
# 方式一:直接使用 provider 类
如果项目明确只使用某个 provider,直接实例化 provider 类最清晰。
from langchain_openai import ChatOpenAI


model = ChatOpenAI(
    model="gpt-4o-mini",
    temperature=0,
    timeout=30,
    max_retries=6,
)

response = model.invoke("用一句话解释 LangChain 的 Model 组件")
print(response.content)
2
3
4
5
6
7
8
9
10
11
12
这种方式适合大多数应用。参数直观,IDE 类型提示也比较友好。
# 方式二:使用 init_chat_model
如果你希望通过统一入口初始化不同 provider,可以使用 init_chat_model。
from langchain.chat_models import init_chat_model


model = init_chat_model(
    "openai:gpt-4o-mini",
    temperature=0,
)

response = model.invoke("LangChain 的 Chat Model 有什么价值?")
print(response.content)
2
3
4
5
6
7
8
9
10
init_chat_model 更适合模型可配置、可切换的场景。例如不同租户、不同环境、不同任务类型选择不同模型。
from langchain.chat_models import init_chat_model


def build_model(model_name: str):
    return init_chat_model(
        model_name,
        temperature=0,
        timeout=30,
        max_retries=6,
    )


model = build_model("openai:gpt-4o-mini")
2
3
4
5
6
7
8
9
10
11
12
13
无论使用哪种方式,都要先安装对应 provider package,并配置好 API Key。
# Message 组件
LangChain 里的 Chat Model 输入输出都围绕 Message 展开。常见消息类型包括:
SystemMessage:系统指令,定义助手角色、边界和风格。HumanMessage:用户输入。AIMessage:模型输出。ToolMessage:工具调用结果。
示例:
from langchain_core.messages import HumanMessage, SystemMessage
from langchain_openai import ChatOpenAI


model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

messages = [
    SystemMessage(content="你是一个专业的 Python 后端工程师。"),
    HumanMessage(content="Flask 项目里为什么需要数据库迁移?"),
]

response = model.invoke(messages)

print(type(response))
print(response.content)
print(response.response_metadata)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
AIMessage 不只有 content。在生产排查里,下面这些字段也很重要:
content:模型生成内容。response_metadata:模型名、完成原因、token 使用等 provider 返回信息。usage_metadata:LangChain 标准化后的 token 用量。tool_calls:模型决定调用的工具列表。
不要在业务里只拿 content 就结束。至少在日志或 trace 中记录模型名、token、耗时和请求 ID。
# invoke:单次调用
invoke 是最基础的调用方式。它接收字符串、消息列表、PromptValue 等输入,返回模型响应。
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个简洁、准确的技术助手。"),
    ("human", "{question}"),
])

model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

prompt_value = prompt.invoke({
    "question": "什么是 LangChain 的 Runnable?"
})

response = model.invoke(prompt_value)

print(response.content)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
在真实项目里,更常见的是把 Prompt、Model、Parser 组合成 chain:
from langchain_core.output_parsers import StrOutputParser


chain = prompt | model | StrOutputParser()

answer = chain.invoke({
    "question": "Model 组件和 Prompt 组件如何协作?"
})
2
3
4
5
6
7
8
这比把每一步手动串起来更容易扩展,也更方便后续接入 trace、stream、batch 和 async。
# batch:批处理调用
当你需要一次处理多个输入时,可以使用 batch。
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_template("请用一句话解释:{subject}")
model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

chain = prompt | model

responses = chain.batch([
    {"subject": "LangChain"},
    {"subject": "LangGraph"},
    {"subject": "LangSmith"},
])

for response in responses:
    print(response.content)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
批处理适合离线任务、评估任务、批量生成摘要、批量打标签等场景。
生产中要注意:
- 批量大小不能无限大。
- 要考虑 provider rate limit。
- 要对单条失败做隔离处理。
- 要记录每条输入和输出,方便追踪。
- 不要在用户实时请求里盲目做大批量模型调用。
如果是大规模批处理,建议使用队列、任务系统和限速器,而不是在 Web 请求里同步跑完。
# stream:流式输出
聊天产品里,流式输出非常重要。它能显著降低用户体感等待时间。
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI


prompt = ChatPromptTemplate.from_template("请简要介绍:{subject}")
model = ChatOpenAI(model="gpt-4o-mini", temperature=0)

chain = prompt | model

for chunk in chain.stream({"subject": "LangChain Model 组件"}):
    print(chunk.content, end="", flush=True)
2
3
4
5
6
7
8
9
10
11
流式输出要注意几个工程问题:
- 前端一般用 SSE 或 WebSocket 接收。
- 后端要处理客户端断开连接。
- 中途失败时要返回可理解的错误事件。
- 如果要记录完整回答,需要在服务端聚合 chunk。
- 结构化输出和流式输出同时使用时要谨慎设计解析策略。
简单文本聊天适合流式输出;严格 JSON 输出、工具调用链路、复杂 Agent 执行过程,则需要设计更清晰的事件协议。
# 异步调用
在 FastAPI、异步任务或高并发服务里,可以使用异步接口。
from langchain_openai import ChatOpenAI


model = ChatOpenAI(model="gpt-4o-mini", temperature=0)


async def answer(question: str) -> str:
    response = await model.ainvoke(question)
    return response.content
2
3
4
5
6
7
8
9
对应地,也有:
ainvokeabatchastream
异步不是万能加速器。它主要提升高并发 I/O 等待场景下的资源利用率。模型本身的生成速度、provider rate limit、网络延迟仍然是关键瓶颈。
# 模型参数怎么配置
常见参数包括:
| 参数 | 作用 | 建议 |
|---|---|---|
model | 模型名称 | 从配置读取,不要散落在业务代码 |
temperature | 随机性 | 严谨任务设低,创意任务可提高 |
timeout | 请求超时 | 生产必须设置 |
max_retries | 失败重试次数 | 结合幂等和限流设计 |
max_tokens / provider 对应参数 | 最大输出长度 | 防止成本失控 |
streaming | 是否流式 | 聊天 UI 常用 |
当前 LangChain 的 OpenAI 集成默认会做多次重试。生产里不要盲目把重试次数调得很低,否则临时网络抖动、限流或 5xx 容易直接暴露给用户。更重要的是区分“模型请求重试”和“外部工具重试”:模型请求通常可以重试,但付款、发消息、改权限这类工具执行必须单独做幂等和确认。
一个更接近生产的封装:
import os
from langchain_openai import ChatOpenAI


def build_chat_model() -> ChatOpenAI:
    return ChatOpenAI(
        model=os.getenv("LLM_MODEL", "gpt-4o-mini"),
        temperature=float(os.getenv("LLM_TEMPERATURE", "0")),
        timeout=float(os.getenv("LLM_TIMEOUT", "30")),
        max_retries=int(os.getenv("LLM_MAX_RETRIES", "6")),
    )
2
3
4
5
6
7
8
9
10
11
这样做可以让模型选择和参数配置从业务代码里抽出去,便于多环境部署和灰度。
# 结构化输出
生产应用往往不只需要一段自然语言,而是需要结构化数据。例如意图识别:
{
  "intent": "create_ticket",
  "priority": "high",
  "summary": "用户无法登录"
}
2
3
4
5
可以使用 Pydantic 定义输出结构:
from pydantic import BaseModel, Field
from langchain_openai import ChatOpenAI


class TicketIntent(BaseModel):
    intent: str = Field(description="用户意图")
    priority: str = Field(description="优先级:low、medium、high")
    summary: str = Field(description="一句话摘要")


model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
structured_model = model.with_structured_output(TicketIntent)

result = structured_model.invoke(
    "客户说线上系统无法登录,影响整个财务团队报销。"
)

print(result.intent)
print(result.priority)
print(result.summary)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
结构化输出的生产建议:
- schema 字段要少而明确。
- 枚举值要写清楚。
- 对结果继续做业务校验。
- 失败时要有重试或降级。
- 不要把复杂业务规则完全交给模型判断。
模型的结构化输出能力因 provider 和模型版本而异,关键链路要用测试集评估稳定性。
# Tool Calling
支持工具调用的 Chat Model 可以返回 tool_calls,让应用根据模型决策执行外部函数。
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI


@tool
def get_order_status(order_id: str) -> str:
    """查询订单状态。"""
    return f"订单 {order_id} 已发货"


model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
model_with_tools = model.bind_tools([get_order_status])

response = model_with_tools.invoke(
    "帮我查一下订单 A1001 的状态"
)

print(response.tool_calls)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
工具调用是 Agent 的基础,但工具调用本身不等于完整 Agent。工具执行、权限校验、错误处理、结果回传、循环控制,都需要额外编排。
敏感工具一定要分级:
- 只读工具:查询、搜索、读取文档。
- 低风险写工具:创建草稿、生成报告。
- 高风险写工具:删除数据、发消息、付款、修改权限。
高风险工具不能只靠模型决定,必须有确认、审计和幂等设计。
# 响应元数据与成本统计
模型响应里通常包含元数据。不同 provider 细节不同,但 LangChain 会尽量标准化。
response = model.invoke("解释一下 token usage 为什么重要")

print(response.content)
print(response.response_metadata)
print(response.usage_metadata)
2
3
4
5
生产系统建议记录:
- model name
- prompt tokens
- completion tokens
- total tokens
- latency
- finish reason
- request id
- error type
- user id / tenant id
- prompt version
这些信息对成本分析、性能优化和问题排查非常关键。没有 token 和耗时记录,就无法判断某个功能是否具备商业上的可持续性。
# 模型切换策略
LangChain 能降低模型切换成本,但不能消除模型差异。
模型切换时要重点评估:
- 上下文长度。
- 工具调用能力。
- 结构化输出稳定性。
- 多语言能力。
- 延迟和吞吐。
- 价格。
- 内容安全策略。
- 是否支持流式。
- 是否支持多模态。
可以把模型封装成配置:
from langchain.chat_models import init_chat_model


MODEL_BY_TASK = {
    "chat": "openai:gpt-4o-mini",
    "reasoning": "openai:gpt-4o",
    "cheap_summary": "openai:gpt-4o-mini",
}


def get_model(task: str):
    return init_chat_model(
        MODEL_BY_TASK[task],
        temperature=0,
        timeout=30,
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
但真正上线前,要用同一批测试集比较不同模型的输出质量,而不是只看价格和跑分。
# 生产封装建议
不要在业务代码里到处写:
ChatOpenAI(model="...", temperature=...)
更推荐集中封装:
# internal/ai/models.py
import os
from langchain_openai import ChatOpenAI


def get_default_chat_model() -> ChatOpenAI:
    return ChatOpenAI(
        model=os.getenv("LLM_MODEL", "gpt-4o-mini"),
        temperature=0,
        timeout=30,
        max_retries=6,
    )
2
3
4
5
6
7
8
9
10
11
12
业务链路使用:
# internal/ai/chains.py
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from internal.ai.models import get_default_chat_model


prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个严谨的技术助手。"),
    ("human", "{question}"),
])


def build_qa_chain():
    return prompt | get_default_chat_model() | StrOutputParser()
2
3
4
5
6
7
8
9
10
11
12
13
14
这样做的好处:
- 模型参数统一管理。
- 方便按环境切换模型。
- 方便统一加入 trace、retry、fallback。
- 方便做 A/B 实验。
- 方便控制成本。
# 常见坑
# 把 temperature 设置得过高
知识问答、代码生成、数据抽取、意图识别这类任务通常需要稳定性,temperature 应该偏低。创意写作、脑暴、营销文案可以适当提高。
# 不设置 timeout
生产服务必须设置超时。否则模型调用卡住会占住 worker,最终拖垮接口。
# 在接口里做无限重试
重试要有限制,并且要考虑 provider rate limit。对非幂等工具调用,不能简单重试。
# 只看 content,不记录元数据
没有 token、模型名、耗时和 finish reason,后续很难排查成本和质量问题。
# 以为 LangChain 能抹平所有模型差异
LangChain 统一的是接口和组合方式,不是模型能力。不同模型在工具调用、结构化输出、多模态、上下文长度上的差异仍然需要测试。
# 小结
LangChain 的 Model 组件是模型能力进入应用工程的入口。它统一了模型调用、消息协议、批处理、流式输出、结构化输出、工具调用和响应元数据,让模型可以和 Prompt、Parser、Retriever、Tool、Agent 组合起来。
生产项目里,Model 组件不要散落在业务函数中,而应该集中封装、配置化、可观测。模型参数要可控,调用要有超时和重试,输出要校验,成本要记录,模型切换要经过评估。
写 demo 时,model.invoke() 就够了;做系统时,Model 组件背后要有配置、治理、观测和评估。这个差别,就是 LangChain 从“能跑”走向“可维护”的关键。