# LangChain RAG 应用实践:从向量库检索到可上线问答链
前面已经分别讲过 FAISS、Pinecone、TCVectorDB、Weaviate 和自定义 VectorStore。到这一步,向量数据库不再是孤立工具,而是要进入完整 RAG 应用。
一个最小 RAG 应用看起来很简单:用户提问,Retriever 找文档,Prompt 拼上下文,LLM 生成答案。真正上线后,问题会多很多:向量库连接放在哪里、检索结果怎么格式化、权限过滤怎么传入、答案如何带来源、历史消息是否参与检索、失败时怎么降级、怎么评估回答是否忠实。
所以这篇不写“能跑就行”的示例,而是按生产服务拆分来写第一个 LangChain RAG 应用。
# RAG 链路图
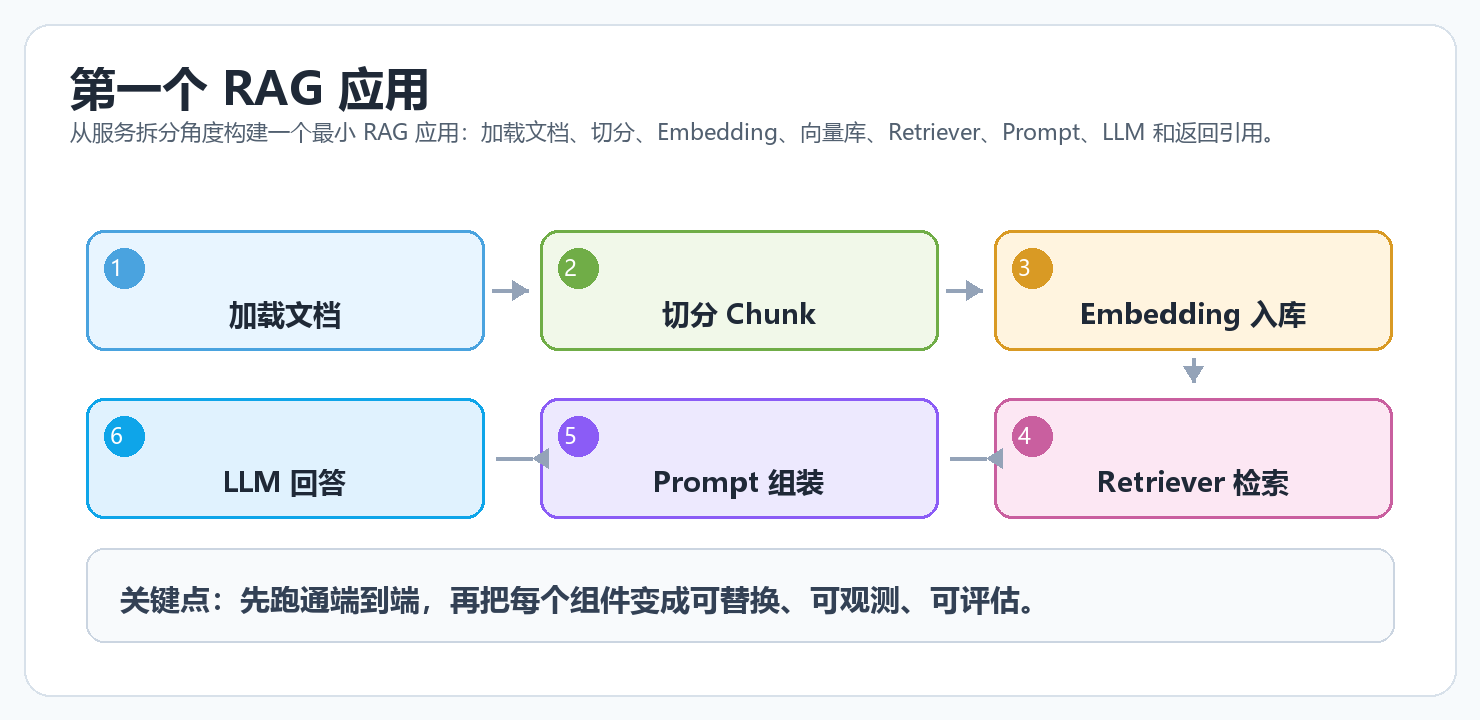
# 架构协作图
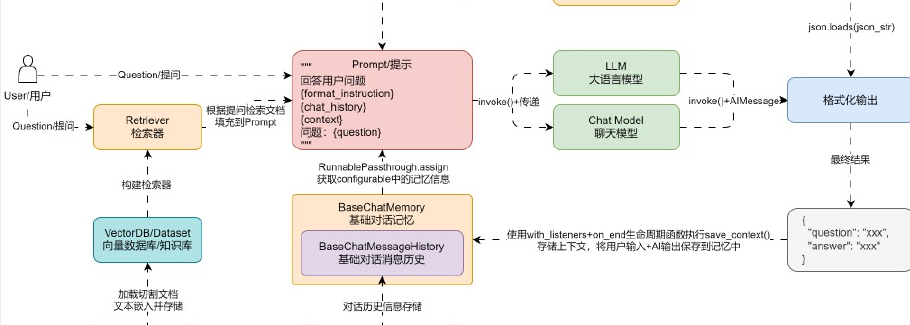
这条链路可以拆成两段。
第一段是离线入库:文档解析、文本切分、Embedding、写入向量数据库。
第二段是在线问答:用户提问、检索相关 chunk、填充 Prompt、调用模型、解析答案、返回引用和 trace。
不要把这两段混在一个接口里。入库链路是数据工程,问答链路是在线服务,它们的吞吐、错误处理、重试策略和监控指标都不一样。
# 当前推荐写法
早期 LangChain RAG 示例经常使用 RetrievalQA 或 create_retrieval_chain。这些写法在旧项目里还能见到,但新项目更建议理解 LCEL 和 Runnable,把检索、格式化、Prompt、模型、解析显式串起来。
这样做有几个好处:
- 每个节点都能单独测试。
- 权限过滤、历史消息、重排、引用返回更容易插入。
- trace 更清晰。
- 后续切换向量库或模型更容易。
最小链路可以概括为:
{
    "context": itemgetter("query") | retriever | format_documents,
    "query": itemgetter("query"),
} | prompt | llm | parser
2
3
4
生产版会在这条链路外面再加上权限、记忆、日志、评估、异常处理和引用结构化返回。
# 安装依赖
以 Weaviate 做示例:
pip install -U langchain-core langchain-openai langchain-weaviate weaviate-client
环境变量:
export OPENAI_API_KEY="your-openai-api-key"
export WEAVIATE_HOST="localhost"
export WEAVIATE_PORT="8080"
export WEAVIATE_GRPC_PORT="50051"
export WEAVIATE_COLLECTION="Dataset"
2
3
4
5
生产里这些配置不要散落在业务代码里,应该由配置中心、环境变量或密钥管理系统统一注入。
# 封装向量数据库服务
向量库 client 不应该每次请求都创建。它和数据库连接类似,应该在服务启动时初始化,然后复用。
import os
from dataclasses import dataclass

import weaviate
from langchain_openai import OpenAIEmbeddings
from langchain_weaviate import WeaviateVectorStore


@dataclass(frozen=True)
class VectorDatabaseSettings:
    host: str
    port: int
    grpc_port: int
    collection_name: str
    text_key: str = "text"
    embedding_model: str = "text-embedding-3-small"


class VectorDatabaseService:
    def __init__(self, settings: VectorDatabaseSettings) -> None:
        self.settings = settings
        self.client = weaviate.connect_to_local(
            host=settings.host,
            port=settings.port,
            grpc_port=settings.grpc_port,
        )
        self.embeddings = OpenAIEmbeddings(model=settings.embedding_model)
        self.vector_store = WeaviateVectorStore(
            client=self.client,
            index_name=settings.collection_name,
            text_key=settings.text_key,
            embedding=self.embeddings,
        )

    def as_retriever(self, *, k: int = 5, filters=None):
        return self.vector_store.as_retriever(
            search_kwargs={
                "k": k,
                "filters": filters,
            }
        )

    def close(self) -> None:
        self.client.close()


def build_vector_database_service() -> VectorDatabaseService:
    settings = VectorDatabaseSettings(
        host=os.environ["WEAVIATE_HOST"],
        port=int(os.environ.get("WEAVIATE_PORT", "8080")),
        grpc_port=int(os.environ.get("WEAVIATE_GRPC_PORT", "50051")),
        collection_name=os.environ["WEAVIATE_COLLECTION"],
    )
    return VectorDatabaseService(settings)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
这层只负责连接和暴露 Retriever,不负责拼 Prompt,也不负责业务权限。边界越清晰,后面越好维护。
# 格式化检索结果
Retriever 返回的是 Document 列表。模型不能直接理解 Python 对象,需要把它格式化成上下文字符串。
from langchain_core.documents import Document


def format_documents(documents: list[Document]) -> str:
    blocks = []

    for index, document in enumerate(documents, start=1):
        source = document.metadata.get("source", "unknown")
        page = document.metadata.get("page", "unknown")
        content = document.page_content.strip()

        blocks.append(
            f"[{index}] source={source} page={page}\n{content}"
        )

    return "\n\n".join(blocks)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
格式化时建议保留来源、页码、文档 id、chunk id。RAG 不是只要答案,还要能追溯答案来自哪里。
# Prompt 设计
一个朴素但可上线前继续扩展的 Prompt:
from langchain_core.prompts import ChatPromptTemplate


prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            """你是一个严谨的知识库问答助手。
只能根据给定上下文回答问题。
如果上下文不足以回答,直接说明无法从当前知识库确认。
回答后给出使用到的来源编号。""",
        ),
        (
            "human",
            """问题:
{query}

上下文:
{context}

请输出:
1. 答案
2. 来源编号""",
        ),
    ]
)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
这里最重要的是约束模型不要自由发挥。RAG 的目标不是让模型“更会编”,而是让答案被可检索证据约束。
# 构建 LCEL 问答链
使用 LCEL 把检索、格式化、Prompt、模型和解析串起来:
from operator import itemgetter

from langchain.chat_models import init_chat_model
from langchain_core.output_parsers import StrOutputParser


llm = init_chat_model("gpt-5-mini", model_provider="openai")
parser = StrOutputParser()


def build_generation_chain():
    return prompt | llm | parser


def build_rag_chain(retriever):
    return (
        {
            "context": itemgetter("query") | retriever | format_documents,
            "query": itemgetter("query"),
        }
        | prompt
        | llm
        | parser
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
调用:
vector_database_service = build_vector_database_service()
retriever = vector_database_service.as_retriever(k=5)
chain = build_rag_chain(retriever)

answer = chain.invoke(
    {
        "query": "企业用户如何申请发票?",
    }
)
2
3
4
5
6
7
8
9
这就是最小 RAG 闭环:query 进入 Retriever,检索结果变成 context,context 和 query 填入 Prompt,模型生成答案。
# 加入权限过滤
生产 RAG 必须考虑权限。不能只根据语义相似度召回,也要保证用户只能看到自己有权限的文档。
以 Weaviate filter 为例:
from weaviate.classes.query import Filter


def build_acl_filter(auth_context, knowledge_base_id: str):
    if knowledge_base_id not in auth_context.allowed_knowledge_base_ids:
        raise PermissionError("knowledge base not allowed")

    return (
        Filter.by_property("tenant_id").equal(auth_context.tenant_id)
        & Filter.by_property("knowledge_base_id").equal(knowledge_base_id)
        & Filter.by_property("status").equal("published")
    )
2
3
4
5
6
7
8
9
10
11
12
查询时创建带权限过滤的 retriever:
filters = build_acl_filter(auth_context, knowledge_base_id="kb-help-center")
retriever = vector_database_service.as_retriever(k=5, filters=filters)
chain = build_rag_chain(retriever)
2
3
注意,权限过滤必须由服务端根据认证态生成。不要把客户端传来的过滤条件直接交给向量库。
# 返回答案和引用
只返回字符串不利于排查。生产接口建议返回结构化结果:
from dataclasses import dataclass


@dataclass(frozen=True)
class RagAnswer:
    answer: str
    sources: list[dict]
    trace_id: str
2
3
4
5
6
7
8
为了返回引用,可以把“检索”和“生成”拆开执行:
import uuid


def answer_question(query: str, retriever, generation_chain) -> RagAnswer:
    trace_id = str(uuid.uuid4())
    documents = retriever.invoke(query)
    context = format_documents(documents)

    answer = generation_chain.invoke(
        {
            "query": query,
            "context": context,
        }
    )

    sources = [
        {
            "source": doc.metadata.get("source"),
            "page": doc.metadata.get("page"),
            "document_id": doc.metadata.get("document_id"),
            "chunk_id": doc.metadata.get("id"),
        }
        for doc in documents
    ]

    return RagAnswer(answer=answer, sources=sources, trace_id=trace_id)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
这段结构比“一条 LCEL 到底”更啰嗦,但生产里经常更好用,因为你能明确拿到检索文档、引用和 trace。
# 和记忆结合
聊天机器人通常还需要历史消息。这里要分清两件事:
- 历史消息用于理解用户当前问题。
- 检索结果用于提供事实依据。
不要把所有历史消息都塞进检索 query,也不要把历史消息直接当知识库证据。
更稳的结构是:
- 根据历史消息和当前问题改写一个独立 query。
- 用改写后的 query 检索知识库。
- 把检索结果和必要历史摘要一起放入 Prompt。
- 生成答案并保存当前轮对话。
如果只是第一版应用,可以先不做问题改写,直接用当前用户问题检索。等评估发现多轮追问召回差,再加 query rewrite。
# 常见失败链路
RAG 失败通常不是“模型不行”四个字能解释的。
| 现象 | 优先排查 |
|---|---|
| 完全答不上 | 文档是否入库、切分是否合理、Embedding 是否一致 |
| 答案像编的 | Prompt 是否要求基于上下文、上下文是否为空 |
| 有正确文档但没召回 | chunk 粒度、top_k、filter、Embedding 模型 |
| 召回了但答案错 | 上下文太长、噪声太多、模型未被约束 |
| 用户看到无权限内容 | filter 是否由服务端生成,metadata 是否完整 |
| 偶发延迟高 | 向量库延迟、模型延迟、重排延迟、网络抖动 |
生产排障一定要保留 trace:原始 query、改写 query、filter、retrieved docs、score、prompt、model、answer、latency。
# 评估第一版 RAG
上线前至少准备一组评估问题。
| 指标 | 看什么 |
|---|---|
| Recall@K | 正确 chunk 是否被召回 |
| MRR | 正确 chunk 排名是否靠前 |
| Groundedness | 答案是否被上下文支持 |
| Answer correctness | 答案是否正确 |
| Citation accuracy | 引用是否真的支持答案 |
| Latency | 检索和生成耗时 |
没有评估集时,RAG 优化很容易变成“试几个问题感觉还行”。生产里每次调整 chunk、Embedding、top_k、filter、Prompt、模型都应该跑一次回归。
# 上线前检查清单
- 向量库 client 是否复用,而不是每次请求创建。
- Retriever 是否带权限过滤。
- metadata 是否包含租户、知识库、文档 id、chunk id、状态、来源。
- Prompt 是否明确要求基于上下文回答。
- 空检索结果是否有兜底回复。
- 是否返回 sources 和 trace_id。
- 是否记录 query、filter、k、score、latency、answer。
- 是否有固定评估集。
- 是否区分离线入库任务和在线问答请求。
- 是否有索引版本切换和回滚策略。
# 问题
第一个 RAG 应用最容易犯的错误有几个。
第一,把向量库连接写在请求函数里。每次请求重新连接会带来延迟和资源浪费。
第二,只返回答案,不返回来源。短期看省事,长期无法排查和建立信任。
第三,权限过滤靠前端传参。真正的权限条件必须由服务端认证态生成。
第四,把历史消息和知识库上下文混在一起。历史消息帮助理解问题,知识库上下文提供事实依据。
第五,不做评估集。没有评估集,就不知道一次改动是提升还是退化。
# 拓展
第一,加入 query rewrite,让多轮追问能变成独立检索问题。
第二,加入 reranker,对向量召回结果重排,提高上下文质量。
第三,加入混合检索,把关键词、向量和业务规则结合起来。
第四,加入引用校验,确认答案中的关键结论确实被来源支持。
第五,加入 LangSmith 或自研 trace,把检索和生成过程完整记录下来。
# 实际生产是否使用
会使用。
这种 2-step RAG 是企业知识库、智能客服、文档问答、内部助手最常见的生产形态。它执行路径固定、延迟可控、排查简单,适合第一版上线。
但生产里不会只写一条 retriever | prompt | llm。真正可用的系统还要有入库流水线、权限过滤、metadata schema、引用返回、trace、评估集、灰度发布和回滚。
# 现在是否抛弃
没有抛弃。
RAG 仍然是解决模型静态知识、私有知识和可追溯回答的重要方案。需要更新的是实现方式:旧的 RetrievalQA 类和一些 langchain.chains 写法已经不适合作为新项目主路径。
新项目更推荐使用当前 LangChain 的 Runnable、LCEL、VectorStore、Retriever 和显式服务拆分。如果要做复杂工具调用和多步推理,再考虑 Agentic RAG 或 LangGraph。
# 最新生产如何实现
当前更推荐这样落地:
第一,离线入库和在线问答分离。入库负责解析、切分、Embedding、写向量库、评估和发布。
第二,在线服务启动时初始化向量库 client 和 VectorStore,按请求构造带权限 filter 的 Retriever。
第三,RAG 链路使用 LCEL 显式组合:query、retriever、format_documents、prompt、model、parser。
第四,答案接口返回 answer、sources、trace_id,而不是只返回字符串。
第五,保留空检索兜底:没有上下文时不要硬答。
第六,所有检索和生成过程进入 trace,并用评估集做回归。
一个更接近生产的入口:
def run_rag_query(query: str, auth_context, knowledge_base_id: str):
    filters = build_acl_filter(auth_context, knowledge_base_id)
    retriever = vector_database_service.as_retriever(k=5, filters=filters)

    documents = retriever.invoke(query)
    if not documents:
        return RagAnswer(
            answer="当前知识库中没有检索到足够信息,无法确认答案。",
            sources=[],
            trace_id=str(uuid.uuid4()),
        )

    generation_chain = build_generation_chain()
    return answer_question(
        query=query,
        retriever=retriever,
        generation_chain=generation_chain,
    )
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
这段代码只是入口骨架。真实上线时,还要把 vector_database_service 做成应用级单例,把 trace 写入日志系统,把异常降级和评估回放接好。
# 总结
第一个 LangChain RAG 应用的重点不是“把几个组件串起来”,而是把链路边界想清楚:入库归入库,检索归检索,生成归生成,权限和观测贯穿全程。
能跑的 RAG 很快就能写出来;能维护、能排查、能评估、能回滚的 RAG,才是真正能进生产的版本。
参考: