# 父文档检索器:平衡小块检索与大块上下文
小 chunk 用于精准召回,父文档用于提供完整上下文。
# 01. 拆分文档与检索的冲突
在 RAG 应用开发中,文档拆分 和 文档检索 通常存在相互冲突的愿望,例如:
- 我们可能希望拥有小型文档,以便它们的嵌入可以最准确地反映它们的含义,如果太长,嵌入/向量没法记录太多文本特征。
- 但是又希望文档足够长,这样能保留每个块的上下文。
这个时候就可以考虑通过 拆分子文档块,检索 父文档块 的策略来实现这种平衡,即在检索中,首先获取小块,然后再根据小块元数据中存储的 id,使用 id 来查找这些块的父文档,并返回那些更大的文档,该策略适合一些不是特别能拆分的文档,或者是文档上下文关联性很强的场景。
[!IMPORTANT] 请注意,这里的“父文档”指的是小块来源的文档,可以是整个原始文档,也可以是切割后比较大的文档块。
子文档->父文档 的运行流程也非常简单,其实和 多向量检索器 一模一样,如下:
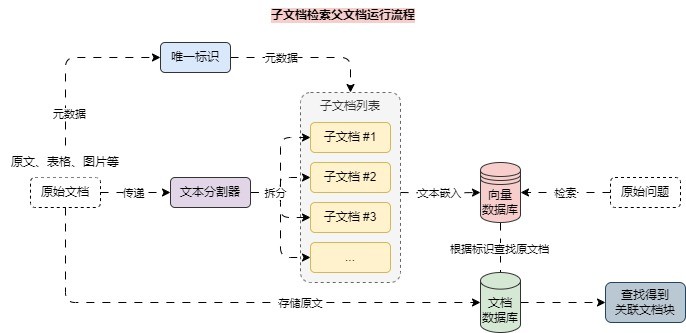
除了使用 MultiVectorRetriever 来实现该运行流程,在 LangChain 中,还封装了 ParentDocumentRetriever,可以更加便捷地完成该功能,使用技巧也非常简单,传递 向量数据库、文档数据库 和 子文档分割器 即可。
代码示例:
import dotenv
import weaviate
from langchain.retrievers import ParentDocumentRetriever
from langchain.storage import LocalFileStore
from langchain_community.document_loaders import UnstructuredFileLoader
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_weaviate import WeaviateVectorStore
from weaviate.auth import AuthApiKey

dotenv.load_dotenv()

# 1.创建加载器与文档列表,并加载文档
loaders = [
 UnstructuredFileLoader("./电商产品数据.txt"),
 UnstructuredFileLoader("./项目API文档.md"),
]
docs = []
for loader in loaders:
 docs.extend(loader.load())

# 2.创建文本分割器
text_splitter = RecursiveCharacterTextSplitter(
 chunk_size=500,
 chunk_overlap=50,
)

# 3.创建向量数据库与文档数据库
vector_store = WeaviateVectorStore(
 client=weaviate.connect_to_wcs(
 cluster_url="https://mbakeruerziae6psyex7ng.c0.us-west3.gcp.weaviate.cloud",
 auth_credentials=AuthApiKey("ZltPVa9ZSOxUcfafelsggGyyH6tnTYQYJvBx"),
 ),
 index_name="ParentDocument",
 text_key="text",
 embedding=OpenAIEmbeddings(model="text-embedding-3-small"),
)
store = LocalFileStore("./parent-document")

# 4.创建父文档检索器
retriever = ParentDocumentRetriever(
 vectorstore=vector_store,
 byte_store=store,
 child_splitter=text_splitter,
)

# 5.添加文档
retriever.add_documents(docs, ids=None)

# 6.检索并返回内容
search_docs = retriever.invoke("分享关于LLMOps的一些应用配置")
print(search_docs)
print(len(search_docs))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
输出内容会返回完整的文档片段,而不是拆分后的片段(但是在向量数据库中存储的是分割后的片段):
[Document(metadata={'source': './项目API文档.md'}, page_content='LLMOps 项目 API 文档\n\n应用 API 接口统一以 JSON 格式返回,并且包含 3 个字段:code、data 和 message,分别代表业务状态码、业务数据和接口附加信息。\n\n业务状态码共有 6 种,其中只有 success(成功) 代表业务操作成功,其他 5 种状态均代表失败,并且失败时会附加相关的信息:fail(通用失败)、not_found(未找到)、unauthorized(未授权)、forbidden(无权限)和validate_error(数据验证失败)。\n\n接口示例:\n\njson\n{\n "code": "success",\n "data": {\n "redirect_url": "https://github.com/login/oauth/authorize?client_id=f69102c6b97d90d69768&redirect_uri=http%3A%2F%2Flocalhost%3A5001%2Foauth%2Fauthorize%2Fgithub&scope=user%3Aemail"\n },\n "message":...')]
1
2
# 02. 父文档检索器检索较大块
在上面的示例中,我们使用拆分的文档块检索数据原文档,但是有时候完整文档可能太大,我们不希望按原样检索它们。在这种情况下,我们真正想要做的是先将原始文档拆分成较大的块(例如 1000-2000 个 Token),然后将其拆分为较小块,接下来索引较小块,但是检索时返回较大块(非原文档)。
运行流程变更如下:
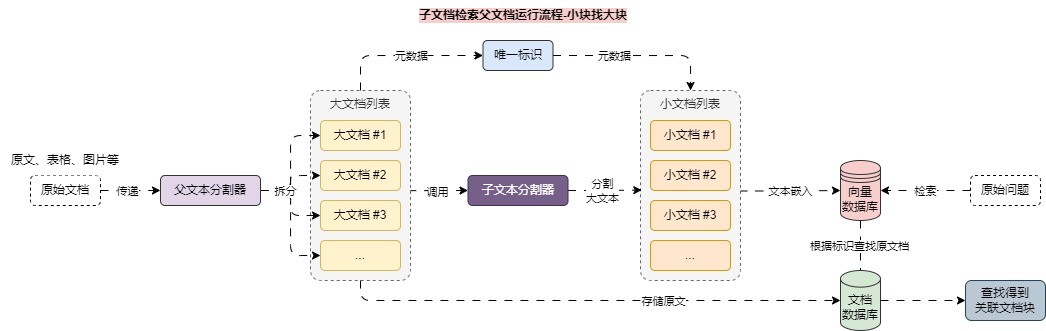
在 ParentDocumentRetriever 中,只需要传递多一个 父文档分割器 即可,其他流程无需任何变化,更新后的部分代码如下:
parent_splitter = RecursiveCharacterTextSplitter(chunk_size=2000)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)

retriever = ParentDocumentRetriever(
 vectorstore=vector_store,
 byte_store=store,
 parent_splitter=parent_splitter,
 child_splitter=child_splitter,
)
2
3
4
5
6
7
8
9
# 最新版 LangChain 用法提示
新项目要优先确认组件所在包名。核心抽象通常在 langchain_core,文档分割在 langchain_text_splitters,OpenAI 相关集成在 langchain_openai,大量社区组件在 langchain_community 或独立集成包中。
涉及 Retriever、Runnable、LCEL、LangGraph 的链路,建议用 invoke() / ainvoke() 作为统一调用入口,并把检索参数、路由条件、重排参数和降级策略显式配置出来。不要只照搬旧导入路径。
# 拓展
父文档检索器:平衡小块检索与大块上下文 不应该孤立使用。RAG 优化通常要和评测集、召回日志、答案引用、用户反馈、成本统计一起看。只优化某一个环节,可能会让另一个环节退化。
工程上建议把 query、改写后的 query、召回文档、metadata filter、重排得分、最终 Prompt 和模型输出都记录下来。否则问题出现时,很难判断是加载、切分、Embedding、检索、重排、Prompt 还是生成阶段出了问题。
# 常见问题
什么时候需要使用这个策略?
当普通向量检索已经不能稳定命中关键证据,或者复杂问题经常漏召回、召回重复、上下文不完整时,就需要引入该类优化。
它能替代基础 RAG 链路吗?
不能。优化策略依赖基础链路。文档质量、chunk 设计、Embedding 模型、metadata 规范和 Retriever 配置没有打好,后续策略只能缓解,不能根治。
如何判断优化是否有效?
用固定评测集对比优化前后:召回命中率、答案正确率、引用正确率、拒答准确率、延迟和成本。只看单个 demo 很容易误判。
# 面试题
RAG 优化应该从哪里开始?
先定位问题阶段:文档是否解析正确、chunk 是否完整、Embedding 是否适合、检索是否命中、上下文是否可用、模型是否按证据回答。定位后再选择对应策略。
为什么复杂 RAG 系统需要可观测性?
因为答案错误可能来自任意环节。没有检索日志、重排分数、Prompt 和输出记录,就只能靠猜。
如何避免优化策略越加越乱?
每个策略都要有触发条件、输入输出、评测指标和降级方案。能用简单策略解决的问题,不要过早引入复杂链路。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 优化后更慢 | 多路检索、重排或图分支增加调用次数 | 增加超时、缓存、并行和候选裁剪 |
| 召回更多但更乱 | 多查询或混合检索没有去重和重排 | 使用 RRF、rerank、source_id 去重 |
| 答案仍然无依据 | 上下文质量低或 Prompt 没有约束证据 | 增加引用要求、拒答策略和证据检查 |
| 成本上涨明显 | 过多 LLM 改写、摘要或评估调用 | 缓存中间结果,限制触发条件 |
| 线上效果不稳定 | 缺少评测集和回归流程 | 固化 golden set,发布前跑回归 |