# CRAG:纠错式检索增强生成优化策略
对召回文档进行可信度判断,不足时改写查询、补充检索或降级处理。
# 01. 纠正性检索增强生成简介
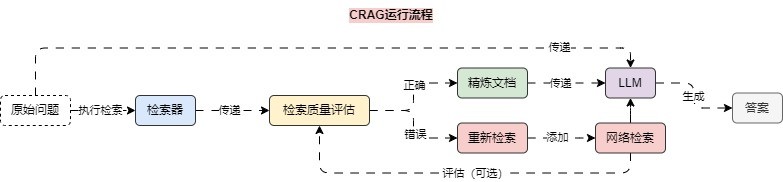
纠正性检索增强生成(Corrective Retrieval-Augmented Generation,CRAG)是一种先进的自然语言处理技术,旨在提高检索的生成方法的鲁棒性和准确性。在 CRAG 中引入了一个轻量级的检索评估器来评估检索到的文档的质量,并根据评估结果触发不同的知识检索动作,以确保生成结果的准确性。
CRAG 的工作流程包含了以下几个步骤:
- 检索文档:首先,基于用户的查询,系统执行检索操作以获取相关的文档或信息。
- 评估检索质量:CRAG 使用一个轻量级的检索评估器对检索到的每个文档进行质量评估,计算出一个量化的置信度分数。
- 触发知识检索动作:根据置信度分数,CRAG 将触发以下二个动作之一: 正确:如果评估器认为文档与查询高度相关,将采用该文档进行知识精炼。 错误:如果文档被评估为不相关或误导性,CRAG将利用网络搜索寻找更多知识来源。
- 知识精炼:对于评估为正确的文档,CRAG将进行知识精炼,抽取关键信息并过滤掉无关信息。
- 网络搜索:在需要时,CRAG会执行网络搜索以寻找更多高质量的知识来源,以纠正或补充检索结果。
- 分解-重组:CRAG采用一种分解-重组算法,将检索到的文档解构为关键信息块,筛选重要信息,并重新组织成结构化知识。
- 生成文本:最后,利用经过优化和校正的知识,传递给 LLM,生成对应文本。
运行流程如下:
# 02. 组件构成与 LCEL 表达式缺陷
在上述的 CRAG 运行流程中,需要的组件涵盖了:检索器、评估组件、判断组件(路由组件)、重检索、网络搜索工具 等,并且该链的运行并不是线性运行的,而是存在 条件判断 与 循环(可选) 迭代多步的可能,对于 LCEL 表达式构建的单链应用来说,要实现这个功能难度非常大,亦或者说代码会非常臃肿。
这就是 LCEL 表达式构建链应用的缺陷,其实在 问题分解策略 时,就已经可以感受到,例如 问题分解策略-迭代式回答运行流程 中,每一次子问题生成的回复要传递给下一次子问题作为上下文,如下:
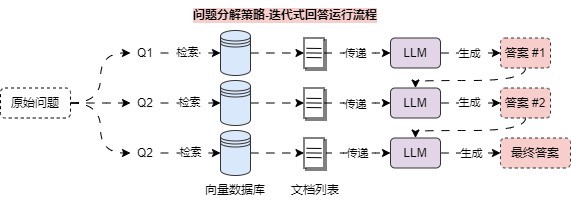
该功能本身是 链应用 的一部分,但是在代码中,我们只能通过循环来完成该过程,核心代码如下:
qa_pairs = ""
for sub_question in sub_questions:
 answer = chain.invoke({"question": sub_question, "qa_pairs": qa_pairs})
 qa_pair = format_qa_pair(sub_question, answer)
 qa_pairs += "\n---\n" + qa_pair
 print(f"问题: {sub_question}")
 print(f"答案: {answer}")
2
3
4
5
6
7
而且涉及到工具类的调用,也没法在 LCEL 表达式构建的链应用中判断是否需要执行工具,并自动将工具的处理结果返回给 LLM(无法回退,只能从前往后流动),对于这类涵盖了单代理、多代理、多LLM集成、多智能体、分层、顺序、循环等复杂场景的应用,一般的 LCEL 表达式就无法实现了,这个时候可以考虑使用 LangGraph 来构建 循环图结构 类型的应用。
LangGraph 官网:https://www.langchain.com/langgraph。
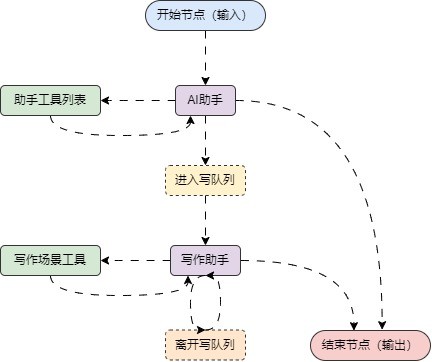
LangGraph 是 LCEL 表达式的扩充/超集,旨在克服传统 LangChain 链条运行时无法循环的限制,LangGraph 以 循环图(一个数学概念) 作为 Agent 应用的框架基础,对比单条链顺序执行,在 图结构 中可以轻松引入循环。
例如下方就是一张 LangGraph 循环图示例(有向无环/有环图):
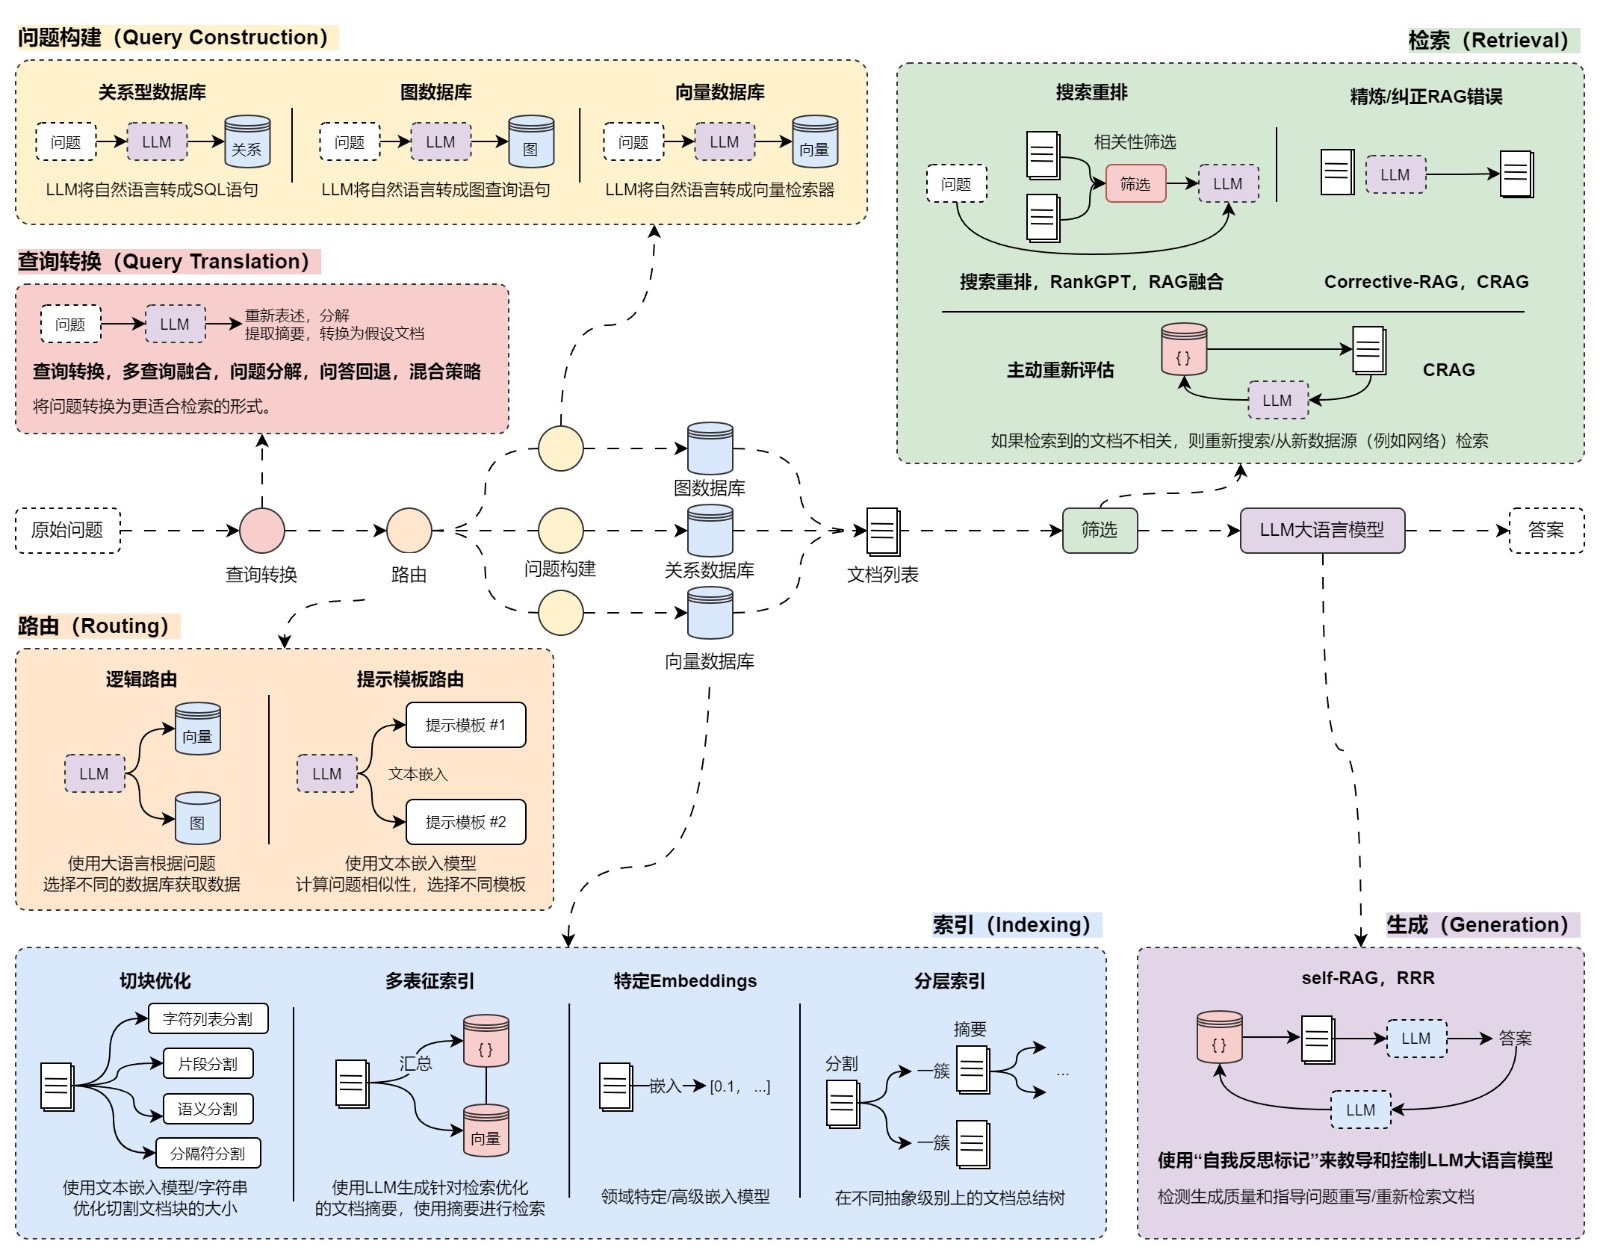
最后,CRAG 这个优化策略会涉及到 循环调用 与 工具回调 两个我们目前还没有掌握到的 LangChain 组件,在下一章我们讲解并深入掌握 LangGraph 时,再回过头来一起实现。
# 最新版 LangChain 用法提示
新项目要优先确认组件所在包名。核心抽象通常在 langchain_core,文档分割在 langchain_text_splitters,OpenAI 相关集成在 langchain_openai,大量社区组件在 langchain_community 或独立集成包中。
涉及 Retriever、Runnable、LCEL、LangGraph 的链路,建议用 invoke() / ainvoke() 作为统一调用入口,并把检索参数、路由条件、重排参数和降级策略显式配置出来。不要只照搬旧导入路径。
# 拓展
CRAG:纠错式检索增强生成优化策略 不应该孤立使用。RAG 优化通常要和评测集、召回日志、答案引用、用户反馈、成本统计一起看。只优化某一个环节,可能会让另一个环节退化。
工程上建议把 query、改写后的 query、召回文档、metadata filter、重排得分、最终 Prompt 和模型输出都记录下来。否则问题出现时,很难判断是加载、切分、Embedding、检索、重排、Prompt 还是生成阶段出了问题。
# 常见问题
什么时候需要使用这个策略?
当普通向量检索已经不能稳定命中关键证据,或者复杂问题经常漏召回、召回重复、上下文不完整时,就需要引入该类优化。
它能替代基础 RAG 链路吗?
不能。优化策略依赖基础链路。文档质量、chunk 设计、Embedding 模型、metadata 规范和 Retriever 配置没有打好,后续策略只能缓解,不能根治。
如何判断优化是否有效?
用固定评测集对比优化前后:召回命中率、答案正确率、引用正确率、拒答准确率、延迟和成本。只看单个 demo 很容易误判。
# 面试题
RAG 优化应该从哪里开始?
先定位问题阶段:文档是否解析正确、chunk 是否完整、Embedding 是否适合、检索是否命中、上下文是否可用、模型是否按证据回答。定位后再选择对应策略。
为什么复杂 RAG 系统需要可观测性?
因为答案错误可能来自任意环节。没有检索日志、重排分数、Prompt 和输出记录,就只能靠猜。
如何避免优化策略越加越乱?
每个策略都要有触发条件、输入输出、评测指标和降级方案。能用简单策略解决的问题,不要过早引入复杂链路。
# 生产问题排查
| 问题 | 常见原因 | 处理方式 |
|---|---|---|
| 优化后更慢 | 多路检索、重排或图分支增加调用次数 | 增加超时、缓存、并行和候选裁剪 |
| 召回更多但更乱 | 多查询或混合检索没有去重和重排 | 使用 RRF、rerank、source_id 去重 |
| 答案仍然无依据 | 上下文质量低或 Prompt 没有约束证据 | 增加引用要求、拒答策略和证据检查 |
| 成本上涨明显 | 过多 LLM 改写、摘要或评估调用 | 缓存中间结果,限制触发条件 |
| 线上效果不稳定 | 缺少评测集和回归流程 | 固化 golden set,发布前跑回归 |