# MetaGPT 记忆模块解读:多智能体协作里的消息记忆、角色上下文与长期记忆
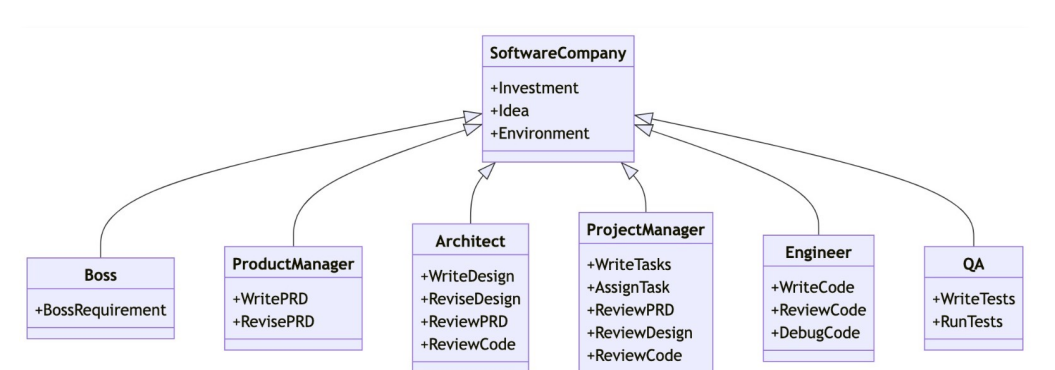
MetaGPT 的核心不是把一个大模型包装成聊天机器人,而是把软件公司里的产品经理、架构师、项目经理、工程师等角色抽象成多个 Agent,再用 SOP 把它们组织起来。
这种架构下,记忆不只是“用户和助手的聊天历史”。它更像一个多智能体协作系统里的消息账本:
- 每个角色看到哪些消息。
- 哪些消息已经处理过。
- 哪些消息由哪个 action 触发。
- 当前角色应该根据哪些历史做决策。
- 任务中断后如何恢复。
- 历史经验如何影响下一轮执行。
这篇文章从 MetaGPT 的记忆模块看 Agent 记忆设计,重点不是复述某个类的代码,而是拆出它背后的工程思想:消息流、角色私有记忆、观察机制、短期记忆、长期记忆和生产系统里的取舍。
# MetaGPT 的记忆定位
在 MetaGPT 里,Role 是 Agent 的核心抽象。一个 Role 不只是有 prompt 和模型,它还包含:
actions:能做什么。state:当前处于什么阶段。todo:下一步要执行哪个 action。msg_buffer:收到但尚未处理的消息。memory:这个角色已经观察和保存的消息。working_memory:规划或任务执行过程中的工作记忆。watch:这个角色关注哪些 action 产生的消息。
所以 MetaGPT 的记忆不是单纯为了聊天连续性,而是为了让角色在协作中知道:
- 我已经看过什么。
- 哪些新消息和我有关。
- 哪些历史会影响我的下一步动作。
- 我应该避免重复处理哪些消息。
这和普通聊天机器人的记忆层级不一样。聊天机器人通常是一个用户 thread;MetaGPT 更像是一个多角色消息系统,每个角色都有自己的观察窗口和记忆副本。
# 记忆模块的整体流程
MetaGPT 的记忆链路可以概括为“消息进入环境,角色观察消息,过滤出自己关心的部分,保存到自己的记忆,再基于记忆思考和行动”。
这个流程里有几个关键对象:
Message:协作系统里流转的基本信息单位。MessageQueue:角色接收到的消息缓冲区。Memory:角色自己的短期消息记忆。LongTermMemory:带持久化和相似检索能力的长期记忆。RoleContext:角色运行时上下文,聚合 memory、msg_buffer、state、todo、watch 等状态。Environment:角色之间发布和接收消息的协作空间。
如果用一句话总结:MetaGPT 的记忆是围绕“角色如何观察消息并形成上下文”设计的,而不是围绕“如何把历史聊天塞回 prompt”设计的。
# Memory:最基础的消息记忆
当前 MetaGPT 的 Memory 是一个非常直接的结构:内部维护消息列表和一个按 action 来源建立的索引。
核心形态可以理解为:
class Memory:
    storage: list[Message]
    index: dict[str, list[Message]]

    def add(self, message: Message):
        if message in self.storage:
            return
        self.storage.append(message)
        if message.cause_by:
            self.index[message.cause_by].append(message)
2
3
4
5
6
7
8
9
10
它提供的能力也很朴素:
add():添加单条消息。add_batch():批量添加消息。get():获取最近 k 条记忆,k 为 0 时返回全部。get_by_role():按角色查消息。get_by_content():按内容关键词查消息。get_by_action():按触发 action 查消息。get_by_actions():按多个 action 查消息。find_news():从观察到的消息里找出尚未处理的新消息。delete()/delete_newest()/clear():删除或清理。
这个设计很轻,但有一个重要思想:消息不只是文本,它带有元信息,尤其是 cause_by。多智能体协作里,知道消息是由哪个 action 产生的,往往比单纯知道消息内容更重要。
# cause_by 索引为什么重要
在单 Agent 聊天里,历史通常按时间排序就够了。但在多 Agent 协作里,消息有来源、有意图、有目标角色。
例如一个软件开发团队里:
- 产品经理输出 PRD。
- 架构师基于 PRD 输出系统设计。
- 项目经理基于设计拆任务。
- 工程师基于任务写代码。
工程师并不一定需要读取所有消息,它可能最关心“项目经理拆出来的开发任务”和“架构师给出的接口设计”。这时按 cause_by 建索引,就可以让角色快速拿到自己关心的 action 结果。
MetaGPT 的 RoleContext.important_memory 就体现了这个思路:
class RoleContext:
    watch: set[str]
    memory: Memory

    @property
    def important_memory(self):
        return self.memory.get_by_actions(self.watch)
2
3
4
5
6
7
watch 定义角色关注哪些 action,important_memory 从记忆里取出这些 action 对应的消息。
这是一种非常实用的 Agent 记忆设计:先定义注意力边界,再按边界召回,而不是把所有历史都交给模型自己筛。
# msg_buffer:接收缓冲区不是记忆本身
MetaGPT 里有一个容易混淆的点:msg_buffer 和 memory 不是同一个东西。
msg_buffer 是角色收到但尚未处理的消息队列。它更像 inbox。
memory 是角色已经观察、筛选并保存下来的历史。它更像本角色的上下文记录。
角色在 _observe() 中会从 msg_buffer 里取出未处理消息,然后按规则过滤:
- 消息是否由自己关注的 action 产生。
- 消息是否发送给自己。
- 消息是否已经在旧记忆里出现过。
- 是否配置为观察缓冲区内的全部消息。
过滤后的消息会进入 self.rc.news,并被保存进 self.rc.memory。
这个设计有一个很好的边界:消息进入系统不等于进入某个角色的记忆。角色只记住与自己有关的部分。
# find_news:避免重复处理
多智能体系统很容易重复消费消息。一个角色如果每轮都从全局消息池里读取历史,就可能反复处理同一条消息。
MetaGPT 的 find_news() 负责找“新消息”:
def find_news(self, observed: list[Message], k=0) -> list[Message]:
    already_observed = self.get(k)
    news = []
    for message in observed:
        if message in already_observed:
            continue
        news.append(message)
    return news
2
3
4
5
6
7
8
这个函数看起来简单,但它解决的是 Agent 协作系统里的关键问题:消息消费要有去重语义。
生产系统里,这一点通常会进一步升级为:
- 每条消息有全局唯一 id。
- 每个 role 有自己的消费位点。
- 消息处理有幂等记录。
- 失败后可以重放。
- 重放时不会重复执行副作用。
MetaGPT 的实现偏轻量,但方向是对的:记忆不只是存储,还是消息处理状态的一部分。
# Role 的观察过程
Role 的 _observe() 可以理解为“从缓冲区读取新消息,并写入本角色记忆”。
简化逻辑如下:
async def _observe(self) -> int:
    news = self.rc.msg_buffer.pop_all()
    old_messages = [] if not self.enable_memory else self.rc.memory.get()

    self.rc.news = [
        n for n in news
        if (n.cause_by in self.rc.watch or self.name in n.send_to)
        and n not in old_messages
    ]

    self.rc.memory.add_batch(self.rc.news)
    return len(self.rc.news)
2
3
4
5
6
7
8
9
10
11
12
这段逻辑体现了三个设计原则:
第一,角色不是被动读取全部历史,而是先观察新消息。
第二,角色只保存自己关心的消息。
第三,记忆和 action 选择绑定,后续 _think()、_act() 都会依赖这些历史。
这也是 MetaGPT 和普通聊天链最大的不同:它不是一条线性对话,而是一组角色在共享环境里通过消息进行协作。
# LongTermMemory:从短期列表到持久化检索
基础 Memory 是内存里的消息列表。长期记忆需要解决两个问题:
- 程序重启后能恢复。
- 遇到相似消息时能判断是否已经处理过。
MetaGPT 的 LongTermMemory 继承自 Memory,并引入 MemoryStorage。当前实现里,MemoryStorage 使用向量检索引擎保存和搜索消息,持久化到角色对应的本地目录。
核心思路可以概括为:
class LongTermMemory(Memory):
    memory_storage: MemoryStorage

    def recover_memory(self, role_id, rc):
        self.memory_storage.recover_memory(role_id)

    def add(self, message):
        super().add(message)
        if message.cause_by in self.rc.watch:
            self.memory_storage.add(message)

    async def find_news(self, observed, k=0):
        stm_news = super().find_news(observed, k=k)
        ltm_news = []
        for message in stm_news:
            similar = await self.memory_storage.search_similar(message)
            if not similar:
                ltm_news.append(message)
        return ltm_news[-k:]
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
这里有一个很关键的分层:
- 短期记忆负责当前进程内的消息列表和索引。
- 长期记忆负责持久化和相似检索。
find_news()不只判断“是否完全相同”,还会判断“是否和长期记忆里的内容相似”。
这对于 Agent 恢复和增量执行很重要。否则系统重启后,角色可能把过去已经处理过的需求再处理一遍。
# MemoryStorage:向量检索式长期记忆
MemoryStorage 的实现思路是把消息内容写入向量索引,再用相似搜索判断新消息是否和旧消息接近。
可以理解为:
class MemoryStorage:
    def recover_memory(self, role_id):
        # 从角色目录恢复向量索引
        ...

    def add(self, message):
        # 把 message 加入向量索引
        ...

    async def search_similar(self, message):
        # 根据 message.content 做相似检索
        ...

    def persist(self):
        # 持久化向量索引
        ...
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
这种实现适合 MetaGPT 的项目式协作:角色需要在后续运行中识别“以前是否见过类似消息”,而不是只按精确 id 查找。
但生产里要注意,向量相似不等于业务相同。两个需求语义相近,但可能是不同版本;两个任务描述接近,但状态不同。长期记忆检索必须结合时间、角色、项目、action、版本号和置信度一起判断。
# 和普通 LLM 记忆的区别
普通聊天机器人里,记忆通常围绕用户 thread:
user -> assistant -> user -> assistant
MetaGPT 里的记忆围绕角色协作:
需求 -> 产品经理 -> 架构师 -> 项目经理 -> 工程师 -> 审查者
区别很明显:
| 维度 | 普通聊天记忆 | MetaGPT 记忆 |
|---|---|---|
| 基本单位 | 用户消息和助手消息 | Message |
| 作用域 | 用户会话 | Role / Team / Project |
| 召回方式 | 最近历史、摘要、语义召回 | role watch、cause_by、消息过滤、相似检索 |
| 目标 | 对话连续性 | 多角色协作和任务推进 |
| 风险 | 上下文过长、偏好污染 | 重复处理、消息路由错误、角色记忆不一致 |
MetaGPT 给我们的启发是:Agent 记忆最好不要只按“时间”组织,还要按“角色、动作、任务状态、消息来源”组织。
# 对生产 Agent 的启发
从 MetaGPT 的记忆设计里,可以抽出几个生产原则。
第一,记忆要有作用域。
至少要区分:
- 用户级记忆。
- 会话级记忆。
- 任务级记忆。
- 角色级记忆。
- 团队级共享记忆。
第二,消息要有元信息。
不要只保存纯文本,至少要保存:
message_idrolecause_bysend_tothread_idtask_idcreated_atsourcestatus
第三,召回要有注意力边界。
不要让每个 Agent 都读全部历史。角色应该明确订阅哪些消息类型,或者通过能力路由决定召回范围。
第四,长期记忆要能恢复和去重。
中断恢复、重复执行、相似任务识别,都需要长期记忆的支持。
第五,记忆要能治理。
包括删除、过期、纠错、审计、权限、脱敏和成本控制。
# MetaGPT 记忆设计的局限
MetaGPT 的记忆模块偏工程轻量,适合它自己的 SOP 多角色协作场景,但直接搬到业务生产系统里还不够。
主要局限包括:
- 基础
Memory是列表存储,不适合大规模历史。 cause_by索引简单有效,但不够表达复杂任务状态。- 长期记忆基于相似检索,容易出现相似但不相同的误判。
- 本地向量索引更适合单机或项目级恢复,不是天然分布式。
- 缺少完整的隐私、删除、审计、版本和冲突治理。
- 多角色同时写同一任务状态时,需要更强的一致性设计。
所以它更像一个优秀的参考模型,而不是可以直接照搬的企业级记忆平台。
# 和 LangGraph 记忆体系的对照
如果用当前 LangGraph / LangChain 的视角看,MetaGPT 的记忆可以映射成几层:
msg_buffer类似消息收件箱或事件队列。RoleContext.memory类似角色短期状态。working_memory类似任务执行过程中的 scratchpad。LongTermMemory类似带向量检索的跨运行持久化。Environment类似多 Agent 的通信总线。
LangGraph 更强调状态图和 checkpointer:
- 短期记忆放在线程状态里。
- 每个步骤更新 state。
- checkpointer 负责恢复。
- Store 负责跨 thread 的长期记忆。
MetaGPT 更强调角色和 SOP:
- 每个角色有自己的 memory。
- 消息通过环境流动。
- 角色通过 watch 选择关注的 action。
- 长期记忆帮助恢复和去重。
两者不是谁替代谁,而是设计重点不同。LangGraph 更像通用状态机,MetaGPT 更像多角色协作框架。
# 问题
MetaGPT 记忆模块最大的启发,也是它最大的问题:记忆和消息协作耦合得很紧。
这在 SOP 型多智能体系统里很好用,因为角色、action、消息、状态都在一个框架里。但如果放到企业业务系统里,记忆往往还要和用户权限、业务数据库、审计系统、工单状态、组织架构、数据权限打通。单纯的 Message 列表加向量检索不够。
另外,长期记忆不是“相似就跳过”。真实业务里,相似需求可能代表需求变更、补充说明或新版本。如果没有版本、时间和任务状态,向量去重可能误杀重要信息。
# 拓展
可以把 MetaGPT 的思路拓展成生产 Agent 记忆模型:
Inbox:每个 Agent 的消息缓冲区。ShortTermMemory:当前 thread 或 task 内的角色记忆。WorkingMemory:当前执行步骤的临时状态。SharedMemory:团队共享的任务事实和产物。LongTermMemory:跨任务、跨会话的历史经验。MemoryIndex:按 action、role、task、embedding 建索引。MemoryPolicy:决定什么能写、什么能召回、何时过期、如何删除。
这比“给 Agent 加一个聊天历史数组”更接近真实生产系统。
# 实际生产是否使用
MetaGPT 这套记忆思想值得借鉴,但不建议原样照搬。
适合借鉴的部分:
- 每个 Agent 有自己的记忆作用域。
- 消息进入记忆前先经过观察和过滤。
- 用 action 来源建立索引。
- 用长期记忆做恢复和去重。
- 把任务协作看成消息流,而不是单线程对话。
生产系统需要额外补齐:
- 分布式持久化。
- 权限隔离。
- 消息幂等。
- 状态版本。
- 隐私删除。
- 记忆质量评估。
- 人工纠错和审计。
# 现在是否抛弃
没有抛弃多智能体记忆这个方向,但具体实现要看框架定位。
MetaGPT 当前仍然保留 Memory、RoleContext.memory、msg_buffer、working_memory 等核心设计。长期记忆相关代码也仍能看到 LongTermMemory 和 MemoryStorage 的思路。
但如果是新做业务 Agent,不一定要使用 MetaGPT 的实现。更通用的做法是:用 LangGraph checkpointer 管 thread state,用 Store / 数据库 / 向量库管长期记忆,用消息队列或事件表管理多 Agent 通信,再把 MetaGPT 的 role/watch/cause_by 思想吸收到自己的状态模型里。
# 最新生产如何实现
一个更生产化的 MetaGPT 式记忆架构,可以按下面拆:
第一层,消息表:
CREATE TABLE agent_messages (
    id TEXT PRIMARY KEY,
    tenant_id TEXT NOT NULL,
    project_id TEXT NOT NULL,
    thread_id TEXT NOT NULL,
    role_name TEXT NOT NULL,
    cause_by TEXT,
    send_to TEXT,
    content TEXT NOT NULL,
    created_at TIMESTAMP NOT NULL
);
2
3
4
5
6
7
8
9
10
11
第二层,角色消费状态:
CREATE TABLE agent_role_offsets (
    tenant_id TEXT NOT NULL,
    project_id TEXT NOT NULL,
    role_name TEXT NOT NULL,
    last_message_id TEXT,
    updated_at TIMESTAMP NOT NULL,
    PRIMARY KEY (tenant_id, project_id, role_name)
);
2
3
4
5
6
7
8
第三层,短期状态:
state = {
    "thread_id": thread_id,
    "role": "Architect",
    "news": new_messages,
    "working_memory": current_plan,
    "todo": next_action,
}
2
3
4
5
6
7
第四层,长期记忆索引:
memory_index.add(
    namespace=("tenant", tenant_id, "project", project_id, "role", role_name),
    key=message_id,
    value={
        "content": content,
        "cause_by": cause_by,
        "created_at": created_at,
    },
)
2
3
4
5
6
7
8
9
第五层,召回策略:
def recall_for_role(role_name: str, action: str, query: str):
    exact = message_repo.list_by_cause(role_name=role_name, cause_by=action)
    semantic = memory_index.search(namespace=(role_name,), query=query, limit=5)
    return merge_and_rank(exact, semantic)
2
3
4
最终原则是:短期记忆负责当前任务推进,长期记忆负责恢复和经验复用,消息系统负责多 Agent 协作,权限和审计系统负责治理。MetaGPT 的价值不在于某个 Memory 类多复杂,而在于它提醒我们:多智能体记忆首先是消息协作问题,其次才是向量检索问题。