# 大语言模型为什么会幻觉:从原因、检测到 AI Agent 的生产级缓解方案
一句话导读:幻觉不是一个靠“提示词写严一点”就能彻底解决的问题,它来自数据、训练、推理和应用链路的共同作用;生产系统要做的不是幻想零幻觉,而是把幻觉风险拆成可检测、可拦截、可回放、可评估、可持续降低的工程问题。
LLM 幻觉最麻烦的地方,不是模型偶尔答错。
真正麻烦的是:它经常答得很像真的。
它会给出具体年份、具体人名、具体政策条款、具体 API 参数、具体引用来源,语气还很笃定。对用户来说,这比“我不知道”危险得多;对生产系统来说,这意味着错误可能绕过人工直觉,进入业务流程、知识库、工单、报告甚至外部接口。
所以做 AI Agent,不能只问:
“怎么让模型少幻觉?”
更应该问:
“系统在哪些环节允许模型自由生成事实?哪些事实必须有来源?哪些输出必须校验?哪些场景宁可拒答也不能编?出了错怎么定位是检索、生成、工具还是评估的问题?”
这才是工程上讨论幻觉的正确入口。
# 先定义:两类常见幻觉
幻觉可以粗略分成两类:事实性幻觉和忠实性幻觉。
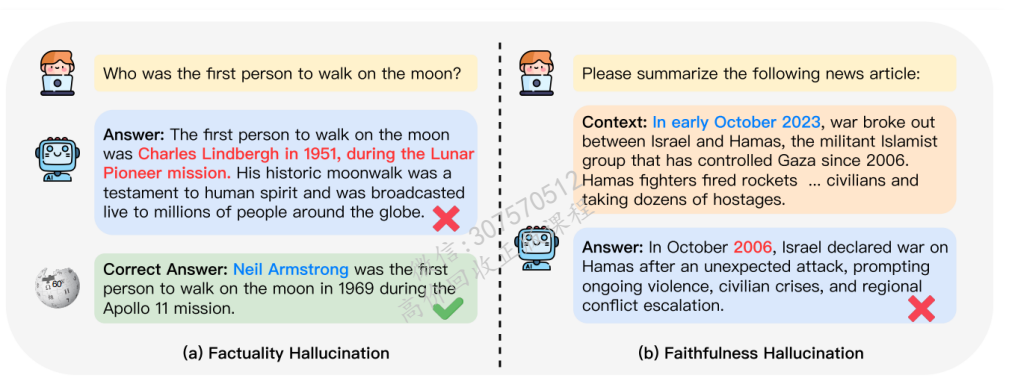
事实性幻觉,是模型生成的内容和真实世界不一致。
比如问“第一个登上月球的人是谁”,模型回答成另一个人,并补出一堆看似合理的经历。这类错误的判断标准通常在模型外部:真实世界、权威资料、数据库记录、政策文件、业务系统。
忠实性幻觉,是模型生成的内容和用户输入、上下文、检索材料或工具结果不一致。
比如用户让它总结 2023 年 10 月的新闻,它却写成 2006 年;或者 RAG 已经检索到正确条款,模型回答时却改写成另一个结论。这类错误的判断标准通常在当前上下文内部:用户指令、source chunks、工具返回、前文状态。
这两个概念在生产排查里很重要:
| 类型 | 判断依据 | 典型问题 |
|---|---|---|
| 事实性幻觉 | 外部真实世界或权威系统 | 人名、日期、法规、产品参数、财务数据编错 |
| 忠实性幻觉 | 当前输入、上下文、检索内容、工具结果 | 不按资料答、改写工具结果、违反用户要求、前后矛盾 |
RAG 主要缓解事实性幻觉,但不能自动解决忠实性幻觉。模型拿到正确资料后,仍然可能不忠实地生成。
# 幻觉为什么会发生
幻觉不是单点 bug,它来自多层原因。
第一层是数据问题。
模型学到的世界来自训练数据。训练数据可能有错误、偏见、重复、过期、缺失。模型也不知道自己知识的边界在哪里。即使训练数据里有正确事实,模型在生成时也不一定能稳定取出那条事实。
第二层是训练目标问题。
大模型的基础训练目标是预测下一个 token。这个目标天然鼓励生成“高概率连续文本”,而不是严格区分“我知道”和“我不知道”。如果评估方式也奖励猜中答案,而不是奖励表达不确定性,模型就更容易在不知道时猜一个看起来合理的答案。
第三层是对齐问题。
RLHF 或偏好优化会让模型更像一个“有帮助的助手”。这通常是好事,但也可能带来副作用:当用户期待一个答案时,模型倾向于给出完整、流畅、令人满意的回答,而不是冷冰冰地说证据不足。
第四层是推理过程问题。
生成是逐 token 采样,前面一个错误 token 可能把后续内容带偏。上下文越长,模型越容易遗漏关键约束;指令越复杂,模型越容易在多个目标之间失衡。
第五层是应用链路问题。
很多线上幻觉不是模型独立造成的,而是链路造成的:
- 检索没有召回正确资料。
- chunk 切分破坏了语义。
- rerank 把正确资料排到后面。
- prompt 没有要求引用来源。
- 工具返回未校验就交给模型改写。
- 模型输出没有经过 groundedness 检查。
- 用户问题本身模糊或带错误前提。
工程上最怕一句话:
“这是模型幻觉。”
这句话太粗。你需要进一步定位:是知识缺失、检索失败、上下文冲突、指令不清、输出未校验,还是模型在有证据的情况下仍然不忠实?
# 幻觉不是只能靠模型解决
如果你是模型训练团队,可以从数据清洗、预训练目标、对齐策略、解码策略、事实性奖励、拒答训练等方向降低幻觉。
但大多数业务团队是在做 LLM 应用,不是在训练基础模型。对应用团队来说,最有效的手段通常在系统层:
- 限制模型自由发挥的范围。
- 用检索和工具给模型提供外部事实。
- 对关键输出做校验。
- 对无法确认的问题允许拒答。
- 对答案建立引用和证据链。
- 用评估集持续回归。
- 用线上反馈闭环改进检索和提示。
所以,生产里的反幻觉不是单一 prompt,而是一套多层防线。
# 第一层:问题分流
不要让所有问题都直接进同一条生成链。
一个可靠的 Agent 应该先判断问题类型:
| 问题类型 | 处理方式 |
|---|---|
| 闲聊、创意、开放问答 | 可以直接生成,但要避免伪造事实 |
| 知识库问答 | 必须先检索,再基于证据回答 |
| 业务数据查询 | 必须调用工具或数据库 |
| 规则、政策、合同、财务 | 必须引用来源,必要时拒答 |
| 高风险建议 | 必须加免责声明、边界和人工转接 |
| 指令不完整 | 先澄清,不要补脑 |
很多幻觉来自错误路由。用户问“我这个订单为什么还没发货”,模型不应该根据常识猜物流原因,而应该查订单系统。
路由层可以很简单:
def route_question(query: str) -> str:
    if contains_order_id(query):
        return "tool_order_query"
    if is_policy_question(query):
        return "rag_policy_qa"
    if is_high_risk_advice(query):
        return "safe_answer"
    return "general_answer"
2
3
4
5
6
7
8
生产里更成熟的做法是用分类器、规则和 LLM router 混合,但原则不变:先决定答案应该从哪里来,再决定让模型怎么说。
# 第二层:RAG 接地
RAG 是缓解事实性幻觉最常见的工程方案,但 RAG 不是“接一个向量库就完事”。
它至少有三种模式:
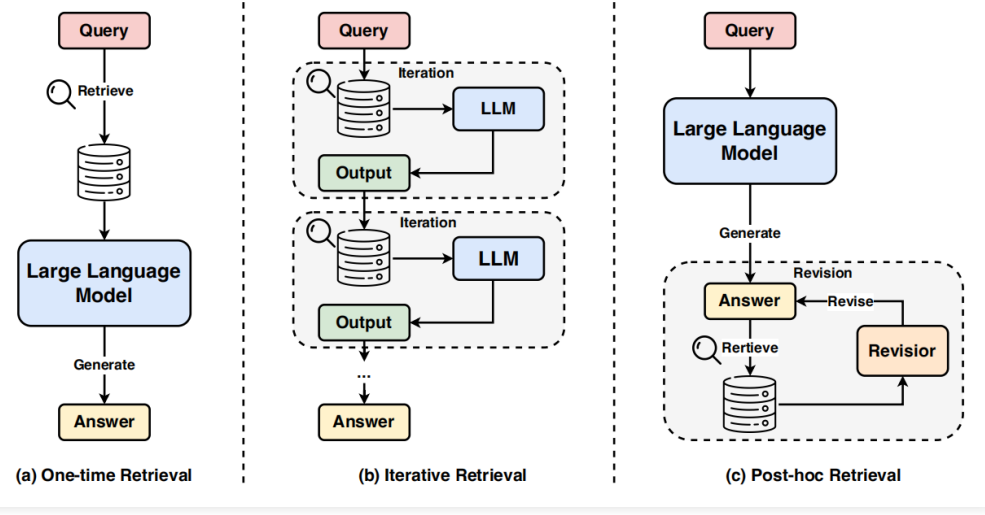
一次性检索,是最常见模式:先检索资料,再把资料放进 prompt,让模型回答。
迭代检索,是模型在生成过程中发现缺信息,再继续检索,适合复杂问题和多跳问答。
事后检索,是模型先生成答案,再检索证据对答案进行修订或验证,适合生成后校验、引用补全和事实审查。
这三种方式的目标不同:
| 模式 | 适合场景 | 风险 |
|---|---|---|
| 一次性检索 | 普通知识库问答、客服 FAQ | 检索错了就全链路错 |
| 迭代检索 | 多跳问题、复杂任务、Agent 推理 | 延迟和成本更高 |
| 事后检索 | 答案审查、报告生成、引用校验 | 可能修不回来,需要拒答策略 |
如果你的知识库问答经常幻觉,不要第一反应就改 prompt。先查检索:
- 正确文档有没有入库。
- chunk 有没有切坏。
- embedding 是否适合领域术语。
- top_k 是否太小。
- reranker 是否把正确资料排掉。
- query rewrite 是否改错意图。
- metadata filter 是否过滤过头。
- 文档是否过期。
RAG 的生成质量上限,经常由检索质量决定。
# 第三层:答案必须忠实于证据
有了资料,不等于答案忠实。
一个更稳的知识库问答 prompt,应该明确模型只能基于资料回答:
SYSTEM_PROMPT = """
你是企业知识库问答助手。
只能根据给定资料回答问题。
如果资料不足以回答,请说“当前资料不足以确认”,并说明缺少什么信息。
不要使用资料外的事实补全答案。
回答中必须引用资料编号。
"""
2
3
4
5
6
7
但 prompt 只是软约束。生产里还要做后置校验:
- 答案里的关键事实是否能在资料中找到。
- 引用编号是否真实存在。
- 引用内容是否支持答案结论。
- 答案是否回答了用户问题。
- 是否出现资料外的人名、日期、金额、条款编号。
可以把答案拆成 claims,再逐条验证:
class ClaimCheckResult(BaseModel):
    claim: str
    supported: bool
    evidence_ids: list[str]
    reason: str


def verify_claims(answer: str, contexts: list[Document]) -> list[ClaimCheckResult]:
    claims = extract_claims(answer)
    return [check_claim_against_context(claim, contexts) for claim in claims]
2
3
4
5
6
7
8
9
10
如果关键 claim 没有证据支撑,就不要把答案直接返回给用户。可以选择修订、降级、拒答或转人工。
# 第四层:让模型学会“不知道”
很多系统不允许模型说不知道,这会直接制造幻觉。
比如 prompt 里写:
你必须回答用户问题,不能拒绝。
这在低风险闲聊里没关系,在知识库问答里就是事故入口。
更合理的策略是:
当资料不足时,你必须拒绝给出确定答案。
拒答时说明缺少的资料类型,并给出下一步建议。
2
拒答不是失败。高风险场景里,正确拒答比错误肯定要好得多。
可以把输出分成三类:
| 类型 | 说明 |
|---|---|
answer | 证据充分,可以回答 |
partial_answer | 只能回答一部分,并说明边界 |
insufficient_evidence | 资料不足,拒绝编造 |
结构化输出示例:
class GroundedAnswer(BaseModel):
    status: Literal["answer", "partial_answer", "insufficient_evidence"]
    answer: str
    citations: list[str]
    missing_evidence: list[str]
2
3
4
5
一旦输出结构里允许 insufficient_evidence,模型才有地方表达不确定。
# 第五层:工具结果不要让模型改写成事实
Agent 经常要调用工具。工具返回的是结构化事实,模型负责解释。
危险写法是:
根据工具结果回答用户。
如果模型自由改写工具结果,金额、日期、状态、数量都可能被写错。
更稳的做法是保留关键字段,不让模型重新发明:
tool_result = {
    "order_id": "A1001",
    "status": "pending_shipment",
    "paid_at": "2026-08-10 10:21:00",
    "expected_ship_before": "2026-08-13 23:59:59",
}
2
3
4
5
6
回答时要求:
- 关键字段必须原样引用。
- 不得推断不存在的原因。
- 不得生成工具结果外的物流状态。
- 如果用户追问原因,而工具没有原因字段,要说明当前系统未返回原因。
对于订单、余额、审批、合同、医疗、法务这类场景,工具结果应当是事实源,模型只是表达层。
# 第六层:建立幻觉检测
幻觉检测可以分成几类。
第一类是外部事实检测。把模型答案和权威知识源、数据库、工具结果比较。
第二类是一致性检测。让模型多次回答或多模型交叉检查,看关键结论是否稳定。
第三类是不确定性估计。观察模型置信度、回答分布、拒答倾向或采样结果差异。
第四类是 LLM-as-a-Judge。让另一个模型基于 rubric 判断答案是否 grounded、是否 relevant、是否 faithful。
第五类是规则和 schema 检测。比如引用格式、JSON schema、日期格式、金额范围、枚举值、工具参数是否合法。
生产里建议用组合拳:
def hallucination_guard(answer, contexts, tool_results):
    checks = [
        check_citations_exist(answer, contexts),
        check_claims_supported(answer, contexts),
        check_tool_fields_preserved(answer, tool_results),
        check_no_forbidden_claims(answer),
        llm_judge_groundedness(answer, contexts),
    ]
    return aggregate_checks(checks)
2
3
4
5
6
7
8
9
不要指望单个 judge 一锤定音。幻觉检测本身也可能误判,所以高风险场景要保留人工审核和回放能力。
# 第七层:用评估闭环降低幻觉
如果没有评估集,幻觉治理很快会变成玄学。
至少要维护几类 golden cases:
- 知识库中有明确答案的问题。
- 知识库中没有答案的问题。
- 资料相似但答案不同的问题。
- 用户问题带错误前提的问题。
- 多跳问题。
- 需要工具调用的问题。
- 容易出现假引用的问题。
- 历史版本冲突的问题。
评估指标可以拆成:
| 指标 | 说明 |
|---|---|
| Retrieval Recall@K | 正确资料有没有被召回 |
| Context Relevance | 召回资料是否真的相关 |
| Answer Groundedness | 答案是否被资料支持 |
| Answer Relevance | 答案是否回答用户问题 |
| Citation Precision | 引用是否真实支持结论 |
| Abstention Accuracy | 资料不足时是否正确拒答 |
| Tool Faithfulness | 是否忠实使用工具结果 |
| Regression Rate | 新版本是否引入旧问题 |
只看最终准确率不够。你必须知道错误发生在哪一层。
# 一个生产级反幻觉链路
可以把完整链路设计成这样:
def answer_question(query: str, user_context: dict):
    route = route_question(query)

    if route == "tool_order_query":
        tool_result = query_order_system(query, user_context)
        answer = render_tool_answer(query, tool_result)
        return verify_tool_faithfulness(answer, tool_result)

    if route == "rag_policy_qa":
        docs = retrieve(query, user_context)
        if not docs:
            return insufficient_evidence("没有检索到可用资料")

        answer = generate_grounded_answer(query, docs)
        check = verify_groundedness(answer, docs)

        if check.passed:
            return answer

        repaired = revise_answer(query, answer, docs, check)
        if verify_groundedness(repaired, docs).passed:
            return repaired

        return insufficient_evidence("资料无法支持一个可靠答案")

    return general_answer_with_uncertainty(query)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
这个链路里,模型不是唯一主角。路由、检索、工具、校验、修订、拒答同样重要。
# 常见误区
误区一:以为 RAG 等于无幻觉。
RAG 只提供外部资料,不保证模型忠实使用资料。检索错、资料错、引用错、模型改写错,都会导致幻觉。
误区二:以为 temperature 设为 0 就不会幻觉。
低 temperature 可以降低随机性,但不能解决知识缺失、上下文冲突、训练偏差和工具结果误读。
误区三:以为 prompt 写“不要编造”就够了。
这是必要但不充分。生产里要有证据、校验和拒答机制。
误区四:以为模型越强越不用防。
强模型幻觉更少,但一旦幻觉,表达更自然、更可信,反而更容易被用户相信。
误区五:只评估答案,不评估检索和工具。
很多幻觉根因在上游。只改生成 prompt,可能永远修不到真正问题。
# 上线前检查清单
知识库问答上线前,至少问这些问题:
- 没有资料时,系统会拒答吗?
- 引用是否能点击到真实 source?
- 答案里的每个关键事实是否有证据?
- 检索失败和生成失败是否能区分?
- 用户错误前提是否会被纠正?
- 工具返回字段是否会被模型改写错?
- 高风险答案是否有人审或二次校验?
- 是否有覆盖“无答案问题”的评估集?
- 是否记录了 retrieved docs、answer、judge result?
- 每次 prompt、retriever、reranker、模型升级后是否跑回归?
这些问题比“模型看起来聪不聪明”更重要。
# 结论
幻觉无法被彻底消灭,只能被系统性压低。
大模型天生擅长生成流畅文本,却不天然知道哪些事实必须可验证、哪些场景必须拒答、哪些工具结果不能改写、哪些引用不能伪造。AI Agent 的工程价值,就在于把模型放进一套有边界的系统里。
真正可靠的反幻觉方案,是多层防线:
- 路由决定事实来源。
- RAG 提供外部证据。
- 工具提供结构化事实。
- Prompt 约束回答边界。
- Schema 约束输出形态。
- Guardrail 检查证据一致性。
- 评估集持续回归。
- 线上反馈反哺知识库和链路。
不要把“减少幻觉”理解成一句提示词。它是一个完整的可靠性工程。